CMU等提出Raven:用稀疏内存路由解耦遗忘,长文本外推16倍
Raven: High-Recall Sequence Modeling with Sparse Memory Routing
在大模型对超长上下文与高吞吐推理的双重渴望下,线性时间序列模型一度被寄予厚望。以状态空间模型(SSM,如 Mamba)和各类线性 Transformer 为代表的架构,凭借与序列长度呈线性关系的计算复杂度和恒定的推理显存占用,展现出替代传统注意力机制的巨大潜力。然而,这代模型长期以来都面临着一个难以回避的阿喀琉斯之踵:长程检索与精确召回能力严重匮乏。在经典的“大海捞针”(Needle-in-a-Haystack)测试或复杂信息抽取任务中,随着上下文长度成倍增加,线性模型的检索精度往往迅速崩塌。
ArXiv URL:https://arxiv.org/abs/2607.25357v1
究其根源,这并非线性模型“记不住”信息,而是其内存写入机制存在根本缺陷。主流状态空间模型普遍采用密集写入(Dense Write)策略,每一个新到达的 Token 都会更新全局隐状态的所有维度,随着序列不断推进,旧信息在持续的状态覆盖中遭受严重干扰,特定 Token 的表征被彻底冲淡;与此同时,滑动窗口注意力(SWA)走向了另一个极端,它虽然通过显式保存 Key-Value 向量实现了局部内的稀疏写入,却采用基于位置的硬性逐出(Hard Eviction),一旦关键信息滑出窗口便永远遗失。
来自卡内基梅隆大学(CMU)、Cartesia AI、MBZUAI 与洛桑联邦理工学院(EPFL)的研究团队在论文《Raven: High-Recall Sequence Modeling with Sparse Memory Routing》中打破了这一二元对立。本文提出了一个统一的理论框架——路由槽内存(Routing Slot Memories, RSM),指出序列模型的核心问题不是要不要遗忘,而是必须将“信息写向何处”(Where)与“信息留存多久”(How long)彻底解耦。基于该理论,团队构建了全新的线性时间模型 Raven:它维护一组固定的内存槽位,在每个时间步通过数据驱动的稀疏路由,仅更新并衰减极少数选中的槽位,其余槽位则完全冻结。实验表明,Raven 在 400M 和 800M 参数规模下展现出惊人的长程外推能力,在无需卷积层辅助的情况下,外推至训练长度 16 倍时仍能保持 90% 以上的召回准确率,彻底扭转了线性模型在长上下文检索上的劣势。
从全量覆写到硬性逐出:线性记忆的固有权衡
为了理解 Raven 的突破,必须先理清现有序列模型在管理历史信息时的底层困境。有限状态的循环模型本质上都必须在有限的存储空间内压缩无限的历史信息。如果将模型在时刻 $t$ 的内部记忆抽象为一个矩阵 ${\mathbf{S}}_t \in \mathbb{R}^{M \times d}$,其中 $M$ 为槽位数量(对应特征头维度),$d$ 为键值扩展维度,那么状态的演进通常遵循如下通用形式:
\[{\mathbf{S}}_t = {\mathbf{S}}_{t-1} \odot {\mathbf{a}}_t + {\mathbf{v}}_t {\mathbf{k}}_t^{\top}\]在以 Mamba-1、Mamba-2 以及 Gated Linear Attention(GLA)为代表的 SSM 体系中,写入向量是完全密集的。这意味着系统每读入一个 Token,隐状态中的所有 $M$ 个槽位都会被强行写入新的内容,并统一施加通道级的连续衰减因子 ${\mathbf{a}}_t$。这种机制在建模平滑的语义特征演变或语言流畅度时非常出色,但面对精细的键值绑定(Key-Value Binding)和远距离精确检索时却暴露出致命缺陷:早期写入的关键数据在成千上万步的密集更新中,不可避免地被后续无关背景 Token 的特征所污染,发生严重的特征重叠与相消。
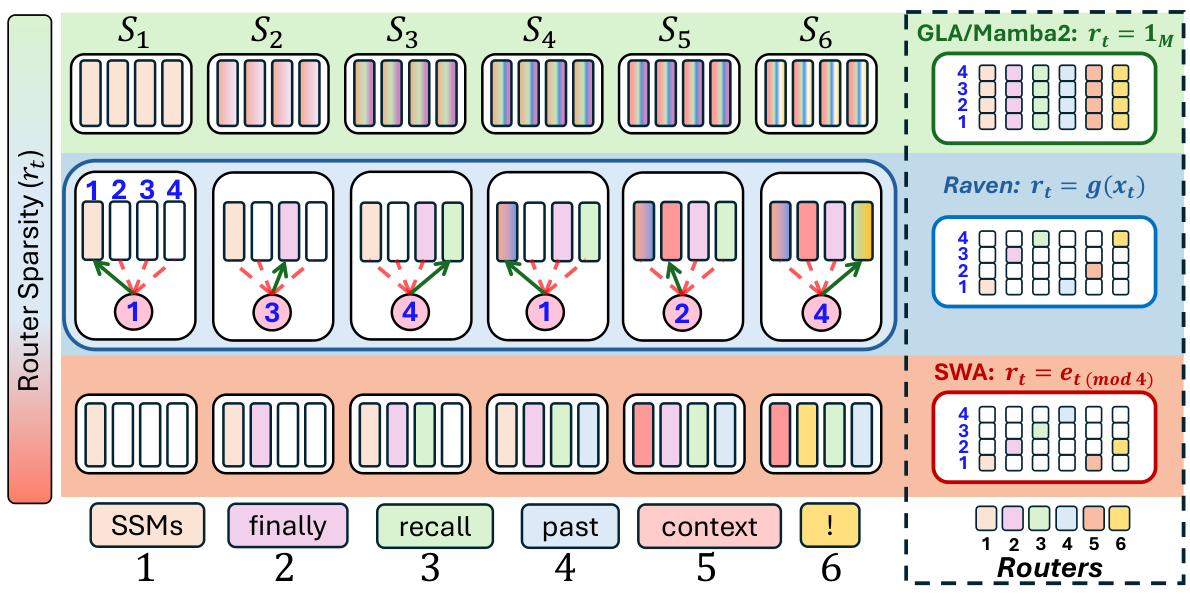
滑动窗口注意力(SWA)则处在光谱的另一端。SWA 在本质上可以被看作一种具有双状态(Key Cache 与 Value Cache)的特殊状态空间模型。在每个步长 $t$,SWA 使用一个循环的独热向量(One-hot vector)${\mathbf{e}}_t$ 作为指示器,以先进先出(FIFO)的方式仅向当前的这一个槽位覆写新的 Key 和 Value 向量,其他槽位保持不变。这种写入机制高度稀疏,保证了窗口内的每个 Token 都以原始、未受干扰的状态保留。然而,SWA 的致命弱点在于其路由是与输入内容完全无关的确定性时间循环:当窗口填满后,最老的槽位将被无条件清零抹除。它无法根据 Token 的重要性做出智能保留决策,一旦线索滑出窗口边界,模型的召回率就会瞬间跌至归零。
在密集更新导致的“特征干扰”与滑动窗口导致的“硬性遗忘”之间,缺乏一种兼具内容感知路由与持久化存储能力的中间架构。现有的某些尝试,如 ABC(Attention with Bounded Memory Control)或 GSA(Gated Slot Attention),虽然引入了基于输入的权重分配,但由于缺乏真正的稀疏硬截断或缺失衰减控制,写入依然是弥散在所有槽位上的密集更新,未能在根本上消除跨步干扰。
统一理论视角:Routing Slot Memories (RSM)
为了从数学上厘清上述模型的内在联系,论文正式提出了 Routing Slot Memories (RSM) 这一广义框架。RSM 建立在一个核心属性之上:槽可分离性(Slot-Separability)。即整个记忆矩阵 ${\mathbf{S}}_t$ 的每一行(每一个内存槽位 ${\mathbf{S}}_t[i]$)都独立演进,槽与槽之间在状态转移时不发生横向混合。
在代数表征上,如果一个线性更新满足槽可分离性,其左乘转移矩阵必须是对角阵。在此基础上,RSM 显式引入了路由器(Router)概念,将状态转移拆解为“保留的历史”与“更新的记忆”两项互补融合:
\[{\mathbf{S}}_t = (\mathbf{1} - {\mathbf{r}}_t) \odot {\mathbf{S}}_{t-1} + {\mathbf{r}}_t \odot \bigl({\mathbf{D}}_t {\mathbf{S}}_{t-1} {\mathbf{A}}_t + {\mathbf{U}}_t\bigr)\]其中,${\mathbf{r}}_t \in \mathbb{R}^M$ 即为路由器在时间步 $t$ 生成的分配向量,其元素 ${\mathbf{r}}_t[i]$ 严格限定了新信息向第 $i$ 个槽位的写入强度;${\mathbf{U}}_t$ 代表待写入的内容矩阵,而 ${\mathbf{D}}_t$ 与 ${\mathbf{A}}_t$ 则分别控制槽位内行与列的内部衰减。这一形式赋予了状态转移非常直观的物理语义:
-
当路由分量 ${\mathbf{r}}_t[i] = 0$ 时,第 $i$ 个槽位处于完全冻结(Frozen)状态,旧有内容原封不动地跨步持久化保留;
-
当路由分量 ${\mathbf{r}}_t[i] = 1$ 时,该槽位被全量激活,旧记忆被按既定规则衰减并覆盖写入新信息;
-
在 0 与 1 之间则实现连续软更新。
在 RSM 框架的统一审视下,现有主流架构的本质差异瞬间明朗化:SWA 实际上是路由向量极度稀疏、且仅按时序循环变换(${\mathbf{r}}_t = {\mathbf{e}}_t$)的无衰减 RSM;Mamba-2、GLA、GDN 等密集 SSM 则对应恒等全 1 路由(${\mathbf{r}}_t = \mathbf{1}_M$),放弃了空间上的选择性,完全将遗忘职责甩给了通道衰减矩阵 ${\mathbf{A}}_t$;而经典的 DeltaNet 则相当于使用输入投影向量构成了秩为 1 的投影更新矩阵。
正是在这一设计空间的光谱中,出现了一个明显未被开发的理想象限:同时具备稀疏性(Sparsity)、输入依赖性(Input-dependence)与槽级连续衰减(Selective Decay)的序列模型。这正是 Raven 的立足点。
Raven 的核心机制:稀疏路由与选择性遗忘
Raven 继承了类似注意力的双状态设计,分别维护针对 Key 的状态矩阵 ${\mathbf{S}}^k_t \in \mathbb{R}^{M \times d}$ 与针对 Value 的状态矩阵 ${\mathbf{S}}^v_t \in \mathbb{R}^{M \times d}$。其内部更新方程被精妙地形式化为:
\[{\mathbf{S}}^k_t = \exp(a_t {\mathbf{r}}_t) \odot {\mathbf{S}}^k_{t-1} + \bigl(\mathbf{1} - \exp(a_t {\mathbf{r}}_t)\bigr) {\mathbf{k}}_t^{\top}\] \[{\mathbf{S}}^v_t = \exp(a_t {\mathbf{r}}_t) \odot {\mathbf{S}}^v_{t-1} + \bigl(\mathbf{1} - \exp(a_t {\mathbf{r}}_t)\bigr) {\mathbf{v}}_t^{\top}\]最终通过标准化注意力机制读取输出:${\mathbf{o}}_t = ({\mathbf{S}}^v_t)^{\top} \mathrm{softmax}({\mathbf{S}}^k_t {\mathbf{q}}_t)$。这里的核心构造在于标量衰减因子 $a_t < 0$ 与稀疏路由向量 ${\mathbf{r}}_t$ 的结合方式。
首先是基于输入的稀疏路由机制。不同于传统混合专家(MoE)模型,Raven 在序列的每一个 Token 位置都需要决定将特征沉淀至哪几个槽位。模型通过线性投影计算输入与槽位的相关度分值 ${\mathbf{m}}_t = \sigma({\mathbf{W}} {\mathbf{x}}_t)$,随后执行硬性的 Top-$K$ 截断操作,仅保留分值最高的 $K$ 个槽位,其余全部强制归零:
\[{\mathbf{g}}_t = \mathrm{KeepTop}_K({\mathbf{m}}_t), \qquad {\mathbf{r}}_t = \frac{{\mathbf{g}}_t}{\alpha \sum_{i=1}^M {\mathbf{g}}_t[i]}\]这里存在一个与常见 MoE 模型截然相反的深刻取舍:Raven 在训练中完全不使用任何负载均衡损失(Load Balancing Loss)。在 MoE 中,研究人员竭力避免专家利用率倾斜;但在长程记忆管理中,强制槽位均匀分配反而会破坏记忆结构。Raven 刻意允许甚至鼓励非均匀路由——那些具有极高信息密度的检索关键 Token(如测试中的 Passkey、专有名词、核心实体)会被定向路由至特定的专用槽位,而大量流式语法背景 Token 则被挤入共享槽位频繁覆写。这种设计让关键信息在专属槽位中免遭任何后续更新的干扰。
其次是选择性槽级衰减控制。每个激活步的遗忘速率由一个受输入驱动的对数标量衰减参数 $a_t = -\mathrm{SoftPlus}({\mathbf{w}}^{\top} {\mathbf{x}}_t) \exp(\Delta)$ 决定。注意观察指数项 $\exp(a_t {\mathbf{r}}_t[i])$ 的数学特性:对于未被 Top-$K$ 路由选中的槽位,${\mathbf{r}}_t[i] = 0$,其衰减乘子恒等于 $\exp(0) = 1$,同时写入增益项 $1 - \exp(0) = 0$。这意味着未选中的槽位在当前时间步被完全旁路,其历史信息被绝对冻结。只有被路由选中的极少数槽位,才会按动态计算的速率发生平滑衰减,并写入当前 Token 的特征。
这种机制从根本上重塑了有效序列长度(Effective Sequence Length, ESL)。对于包含 $T$ 个 Token 的长序列,由于每个槽位仅被稀疏选中,其在整个时序生命周期中实际处理的步数大幅减少。这相当于为不同的语义信息自发建立了多速率的时间尺度,使得整个固定容量的内部状态可以跨越极其漫长的上下文而不会迅速饱和。
更为亮眼的是,以往几乎所有顶尖的线性模型(如 Mamba-2、GLA、GDN)都极度依赖 1D 深度卷积来进行局部的时序特征平滑与训练稳定,而 Raven 完全摒弃了 1D 卷积模块。实验证明,单纯依靠内容感知路由与槽级衰减的协同,就足以完美解决局部上下文整合与高精度检索的矛盾,极大简化了计算图的设计。
极端外推压测:超越训练长度 16 倍的硬核表现
为了验证 Raven 在长程检索上的绝对实力,研究团队在合成大海捞针(Single Needle-in-a-Haystack, NIAH)以及多项真实的低冗余信息抽取基准上展开了全面评测。测试涵盖了 400M 参数(训练上下文 2K)与 800M 参数(训练上下文 4K)两个量级,所有对比基准均严格对齐参数总量与解码隐状态缓存容量。
在经典的单针检索任务中,模型的表现呈现出戏剧性的两极分化。在 400M 规模下,当评估长度推移至 8K(已达训练长度 4 倍)时,此前表现优异的 Mamba-2 和 Gated Delta-Net(GDN)的准确率开始断崖式下跌,密集状态更新导致的“记忆溢出”暴露无遗;而滑动窗口机制(SWA)在超出窗口范围后直接失效。相比之下,Raven 在 8K 与 16K 长度下维持了惊人的 99% 以上完美召回率;即便在将上下文强行拉伸至 32K——即训练长度的整整 16 倍时,Raven 依然拿下了 >91% 的惊人高分,成为该级别下唯一具备长程可用性的线性序列模型。
在 800M 参数尺度上,外推能力进一步显现。在 64K 超长上下文(16 倍外推)的 NIAH-1 压力测试下,原本处于线性模型第一梯队的 GDN 准确率骤降至 45.2%,而 Raven 依旧稳稳锁定了 91.0% 的召回准确率。这一成绩甚至击败了部分依靠完整保留全局 KV 缓存的 Softmax 变体(如 FoX 模型)。这确凿地证明:Raven 在超长距离下的稳健性并非源自参数规模的暴力堆叠,而是稀疏路由机制为关键信息构筑了免受冲刷的物理隔离层。
在更加考验真实语境理解的抽取式问答与文档结构化抽取任务中,Raven 同样展现出统治力。在单文档抽取式 QA(SQuAD)、网页数据抽取(SWDE)以及财务文档信息抽取(FDA)三项高召回依赖基准中,Raven 全面超越了此前的线性时间基准:
在 SWDE 测试中,400M 参数的 Raven 达到了 34.1% 的准确度,显著拉开与 Mamba-2(25.7%)和 GLA(29.0%)的差距,极大缩窄了线性模型与标准 Transformer 上限之间的鸿沟;在长文档结构理解难度极高的 FDA 基准上,Raven 成为全场唯一突破 22% 准确率的线性模型,比此前最强 SSM 表现高出近 8 个百分点。这些结果表明,Raven 的优势不仅限于机械地定位一个孤立的随机 Passkey,它在面对真实自然语言的句法交错、多跨度属性抓取时,依然能有效利用槽位分离机制留存关键证据。
除了独立作为全线性架构运行,Raven 在与标准注意力混合的 Hybrid 架构 中同样展现了卓越的协同效应。当与全局 Attention 交替堆叠时,以 Raven 作为线性主干的模型不仅在常规语言建模指标上追平了全量 Transformer,在极难的多针检索(NIAH-2、NIAH-3)中,更展现出显著优于 Mamba-2 Hybrid 和 SWA Hybrid 的性能基线。
架构演进的启示:线性模型的新拐点
回顾过去两年序列建模领域的演化,研究者们从最初对全量注意力(Softmax Attention)的昂贵代价感到苦恼,转向对线性循环模型(RNN/SSM)恒定显存推理的狂热追求,但随后又普遍陷入了“线性模型无法做好精确检索”的沮丧之中。
Raven 的诞生为这场争论提供了极具启发性的理论解释与工程范例。它揭示了传统 SSM 与 SWA 的瓶颈并不在于“线性计算”本身,而在于过去的设计在处理记忆更新时过于武断——要么对所有槽位一视同仁地覆盖写入,要么按物理位置机械地一刀切淘汰。
通过建立 Routing Slot Memories 理论,Raven 证明了稀疏性不仅是控制计算复杂度的手段,更是防止长程信息互相污染的天然保护墙。将动态 Top-$K$ 路由与槽级局部衰减相结合,模型学会在内部自动实现语义上的“内存分级存储”:低熵、重复的背景语流在公用槽位中快速流转衰减,而高熵、决定任务成败的关键信息则在专属槽位中被长久冻结。
在长上下文与大规模推理成本日益成为核心瓶颈的当下,Raven 为设计高效长文本架构指出了一条清晰的技术路径:未来的高性能序列模型无需在“昂贵的完全注意力”与“健忘的密集状态空间”之间做出二选一的妥协。通过引入精细化的稀疏内存路由,以极低的推理开销换取媲美标准注意力的长程检索保真度,线性模型正在真正迎来走向大规模实用化的全新拐点。