RefactorAssist:静态预检叠加测试反馈,代码重构通过率达94.2%
RefactorAssist: Agentic Refinement for Reliable Code Refactoring
在软件工程领域,代码重构的核心铁律是“保持外部行为不变的前提下优化内部结构”。然而,当开发团队尝试将大语言模型(LLM)引入这一流程时,往往会遭遇尴尬的现实:模型生成的代码在视觉上极其整齐、命名更具可读性、复杂度也明显降低,但运行单元测试时却频繁报错。大模型常常在重构过程中“自作聪明”地修改边界逻辑、错误推断变量类型,甚至凭空添加它认为合理的附加功能,彻底违背了重构的初衷。
ArXiv URL:https://arxiv.org/abs/2608.00924
针对大模型重构“看似优雅、实则跑不通”的行业顽疾,一项最新研究提出了名为 RefactorAssist 的智能体修复框架。研究团队首先在真实开源 Java 项目中对主流模型的重构失败原因展开了大规模实证分析,并在此基础上构建了一套由“确定性静态修复”与“测试日志引导的 Agent 闭环”共同组成的两阶段防御系统。实验结果表明,该系统能将原本仅有 68.4% 的重构测试通过率拉升至 94.2%,对后续遗留缺陷的修复率达到 70.8%。这一方案展现出一种极具工程借鉴意义的思路:解决大模型生成缺陷的最佳路径,并非无休止地堆叠 Prompt 或增大模型参数,而是用轻量确定的编译器工具链与精准的反馈回路形成工程闭环。
提示词工程的失效:重构失败并非缺少示例
以往处理代码生成错误时,业内常用的手段是采用 Few-shot 提示或限定生成范围。为了验证这些手段在重构任务中的真实效力,研究团队在涵盖 10 个成熟开源 Java 项目、共计 10,000 个方法与测试对的数据集上进行了系统评测,对比了 GPT-4o、Claude Sonnet、Qwen2.5-Coder-32B-Instruct 以及开源底模 StarCoder2 的表现。
测试数据打破了许多人对提示词工程的迷信。实验结果显示,从 Zero-shot 切换到 1-shot、3-shot 乃至 5-shot,或者严格收缩重构的目标范围,对单元测试通过率的提升微乎其微。决定重构正确率的关键因素绝非上下文里的参考示例,而是底层模型本身的代码理解能力。在未经任何辅助干预的初始状态下,商业旗舰模型 GPT-4o 的通过率仅达到 80.8%,而更贴近离线私有化部署场景的 StarCoder2 仅有 68.4% 的通过率(中位数甚至低至 66.1%)。
这意味着,无论采用何种提示词套路,单次直出的生成模式都无法满足生产级代码重构的可靠性要求。近两成到三成的代码在重构后导致既有测试用例失败,直接阻断了 CI/CD 流程。如果不建立自动化捕获与自我修复机制,开发者手动排查这些由重构引入的细微回归缺陷所消耗的成本,将彻底抵消大模型带来的提效收益。
八大暗礁:大模型重构到底错在哪里?
为了摸清模型在重构时频繁触礁的根源,研究团队结合自动化聚类与深度人工复核,分析了所有失败用例,归纳出一套经过 Cohen’s kappa 检验(一致性系数达到 0.78)的高可靠错误分类学。大模型在重构过程中引发测试崩溃的原因,高度集中在以下八类行为中:
第一项,也是占比最高的致命诱因,是上下文误解与幻觉,占据了 24.3% 的失败案例。模型在缺乏完整工程视图时,往往会脑补类成员变量、错误猜测跨文件调用的方法签名,导致编译期即报错。第二项是不正确或不一致的命名变更,占比 15.3%。重构经常涉及重命名变量或内部方法以提高可读性,但模型经常在方法体内完成了改名,却遗漏了局部引用,或在调用下游逻辑时拼错名称。
第三项问题极其普遍且具代表性:擅自增加新功能或变量,占比 13.7%。大模型倾向于按照通用编程习惯“顺手”补全逻辑,例如增加防御性参数校验、插入默认返回值或声明未被消费的冗余变量,直接打破了原有单元测试的断言预期。排在第四至第八位的诱因则涵盖了代码输出不完整(11.3%)、语法与括号结构性错误(9.7%)、边缘用例未妥善处理(9.0%)、类型不兼容(8.7%)以及变量脱离作用域(8.0%)。
这组数据为重构修复系统的设计提供了清晰切入点:失败原因并非全部属于深奥的算法逻辑错误,相当一部分实际上是缺少 import 导包、括号未闭合、基础类型强转不匹配等浅层语法与结构失误。如果每一次出错都无差别地重新调用大型语言模型进行端到端重写,不仅推理开销极大,还可能在修补旧 Bug 的同时引入新幻觉。
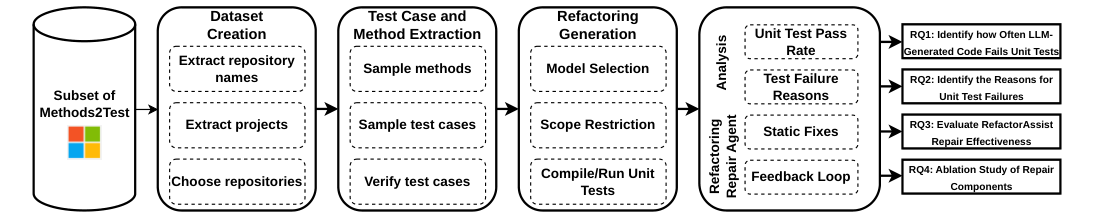
两阶段防御:静态拦截与 Agent 动态闭环
基于上述失败机理,RefactorAssist 设计了一套梯次防御的工作流。整个架构分为轻量确定的静态修复,以及由测试驱动的 Agentic 迭代修复。
第一阶段是完全不调用 LLM 的静态修补程序。由于约有两成的错误集中在结构缺失、括号不平衡和导包遗漏上,RefactorAssist 在获取到模型初始重构代码后,先利用 JavaParser 等确定性静态分析工具进行扫描。该阶段在不改变业务逻辑的前提下,保守地执行补全缺失 import、平衡括号配对以及修正明显类型不兼容的操作。这一步骤计算开销极低、执行速度在毫秒级,却能直接滤除大量低级语法故障。
如果经过静态修补后的代码仍然无法通过 Maven 编译或单元测试断言,代码便会流转至第二阶段:Agentic 迭代修复循环。这个循环并非盲目地将错误信息原样扔回给模型,而是配备了由四类专用工具构成的协作中枢:
第一类是测试运行器(Test Runner),负责在隔离环境中编译代码并执行原生单元测试,提供精准的布尔状态与失败堆栈;第二类是错误日志处理器(Error Log Processor),负责清洗上千行的 Maven 控制台输出,精准提炼出报错行号、异常类型与断言差异;第三类是代码差异生成器(Code Diff Generator),生成原始代码与重构代码之间的 Unified Diff,明确标记改动区域;第四类则是上下文检索器(Context Retriever),负责根据符号定位关联文件,提供跨类依赖的签名定义。
在运行时,系统不仅在短时记忆中保留最新一轮的 Diff 与测试日志,还在长时记忆中固化仓库级别的类型信息。Agent 内部进一步分工为“诊断”与“生成”两个环节:诊断环节首先根据错误现象输出结构化的根因与修改提示元组,随后生成环节接收该提示与严格的代码限制约束,在保护已有公有方法签名不变的前提下实施定向靶向重写。系统设置了最多 10 次的循环上限,一旦测试全部变绿即刻终止退出,既防范了无限循环带来的开销,又规避了模型在多轮修改中发生逻辑漂移。
实验成效:静态省成本,Diff 助冲刺
为了杜绝评测中的数据泄漏嫌疑,研究团队在基于 Methods2Test 筛选出的代码子集上,选用训练集完全开源透明的 StarCoder2 作为基础生成模型,并在一套由 8 块 NVIDIA A100 GPU 组成的集群上执行了严苛的循环构建验证。
实验指标给出了极具说服力的梯次提升路径。仅通过第一道防线中的静态分析修复,原始重构代码的单元测试通过率便直接从 68.4% 跃升至 80.3%。这意味着仅仅借助传统语法分析工具纠正导包、配平括号等结构瑕疵,就直接解决了近三分之一的失败场景,为后续环节节省了可观的 API 计费与推理算力。
而在进入 Agentic 修复阶段后,面对那些真正涉及功能偏差、断言落空的高难度残留缺陷,RefactorAssist 展现出了强大的解题能力。在最终的完整形态下,Agent 对剩余失败用例的单项修复率达到了 70.8%,最终促成整体代码的累计测试通过率高达 94.2%。
消融实验进一步揭示了修复链路中各个技术组件的真实贡献度。数据显示,提供给模型的反馈信息并非越多越好:
-
代码 Diff 与清洗后的错误日志是维持修复精度的核心支柱。当模型能够同时看到“自己改动了哪里”以及“测试在哪个断言上失败”时,其纠错效率达到峰值;配合专用诊断模型生成的排查提示,形成了最强的组合形态。
-
盲目接入 RAG 上下文检索反而带来了副作用。当把依赖仓库中大量相关联类的上下文全部拼接到 Prompt 中后,累积通过率出现了微幅下滑。深入分析表明,海量检索片段带来的信息噪声干扰了模型的注意力聚焦,导致模型在修复微小断言失败时,容易过度发散、误触无关变量。将修复范围紧凑限制在 Diff 与报错堆栈指示的邻域内,才是提高修复成功率的更优解。
走向工程可信的代码重构
RefactorAssist 的实践为 AI 辅助编程工具的发展带来了一项关键启示:代码重构绝不能等同于普通的自然语言润色。在实际开发场景中,可执行性与行为等价性具有压倒一切的优先级。
试图完全仰赖大模型的自愈能力来编写出无瑕疵代码,在现阶段已被证实并不经济,甚至难以收敛。最有效的落地形态,是将传统的静态语法分析器、确定性测试套件作为外生约束硬边界,包裹在生成式智能体的外层。通过传统编译工具过滤掉 90% 的浅层语法干扰,再利用测试驱动的 Agent 去啃下 10% 的深层逻辑硬骨头,这种工程架构不仅让 94.2% 的高可靠重构成为可能,也真正为自动化重构嵌入主流开发者的 CI/CD 流水线扫清了可行性障碍。