SESA:搜索Agent在自博弈中演化技能,脱离外挂记忆依然提升2.2分
Self-Play Meets Skill Evolution: Self-Evolving Search Agents that Pose, Solve, and Remember
在大模型驱动的智能体(Agent)研究中,如何让模型脱离人工标注数据自主进化,一直是具身智能与复杂推理领域的核心议题。目前学术界主要沿着两条看似平行却各有遗憾的路径探索:
ArXiv URL:https://arxiv.org/abs/2607.29468
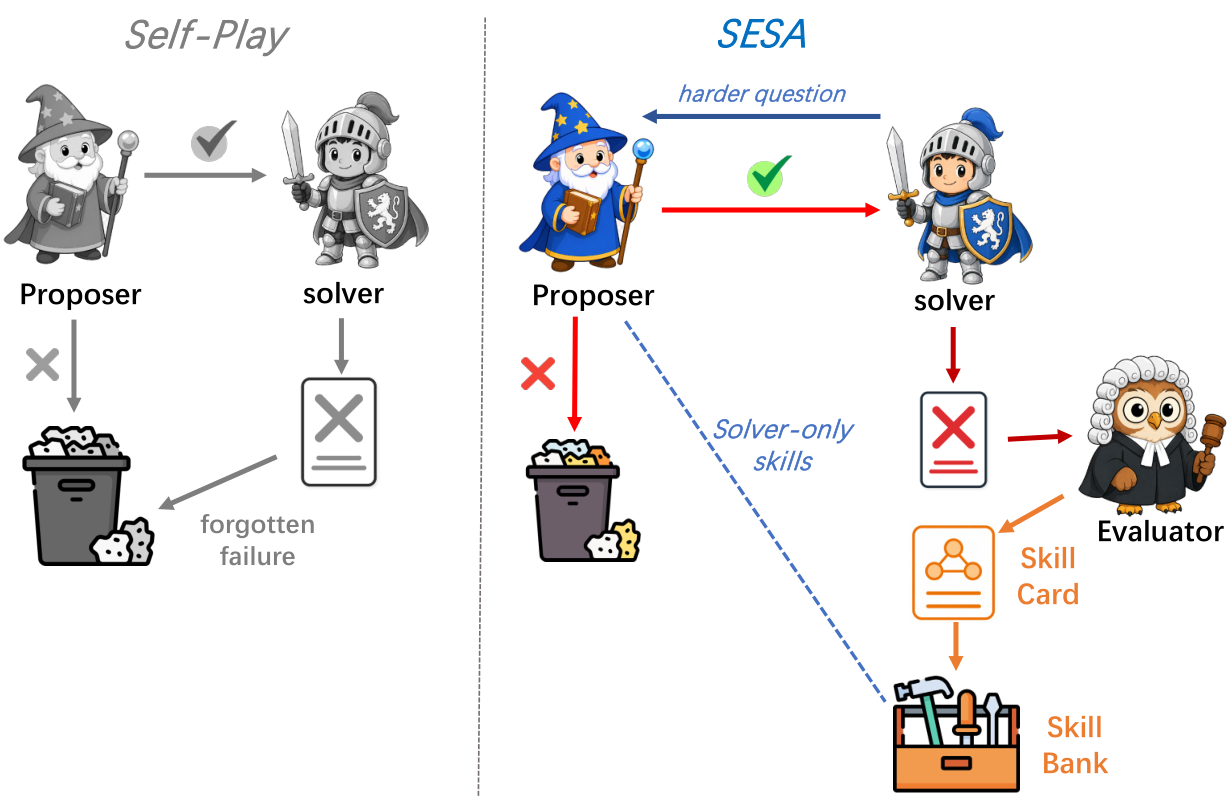
一条路径是零数据自博弈(Zero-Data Self-Play)。这种方案让大模型分别扮演提问者与解答者,通过内在的对抗演练不断拔高任务难度。它的优势在于任务难度能够跟随模型能力动态水涨船高,但致命缺陷在于经验不可沉淀——解答者在某类难题上的失败虽然会产生策略梯度更新模型权重,却无法留下任何结构化、可复用的策略资产,很多摸索出来的搜索模式转头就忘。
另一条路径是基于技能库的强化学习(Skill-Augmented RL)。这类方法会将过去的成功或失败轨迹提炼为结构化笔记或非参数化的策略记忆库,推理时检索外挂。它的记忆留存能力很强,但这些技能往往来自于固定的预设数据集或人工设计的静态课程,智能体无法自主决定去哪里探索未知。
自博弈决定了“练什么”,却留不下经验;外挂技能库“记住了经验”,却只能在别人给定的死板赛道上打转。
针对这一割裂现状,最新研究提出了 SESA(Self-Evolving Skill-Augmented Agent,自演化技能增强智能体)。该方法首次将在线程序化技能演化无缝嵌入工具增强搜索的自博弈训练中,让提问者(Challenger)动态生成的探索边界与解答者(Solver)维护的外挂技能库形成紧密耦合的双向循环。
实验结果给出了一个极具说服力的信号:在涵盖事实检索与多跳推理的七大基准测试中,SESA 相比纯自博弈基线 SSP 平均准确率提升了 1.2 至 3.2 个百分点,全面超越了知名技能增强框架 SkillRL。更重要的是,研究发现即便在部署时彻底剥离外挂技能库(SESA-Off),模型依然保留了 1.8 至 2.2 个百分点的净收益。这意味着,动态演化的技能记忆并非仅仅是一个测试期的“外挂提示词补丁”,它通过重构训练期的策略采样轨迹,真正将解题技巧烙印进了模型权重之中。
为什么单纯拼接自博弈与技能库会彻底失效?
直觉上看,将自博弈与技能库结合似乎并不复杂:只要在解答者做错时记一笔笔记,存入向量数据库即可。然而实际操作中,朴素拼接会迅速引发系统崩溃。
最直接的风险是信息泄露。如果在自博弈闭环中将检索到的经验同时暴露给提问者,提问者便会直接窥视到解答策略的底牌,导致出题方向畸变,甚至反向生成刻意规避或利用记忆漏洞的病态问题,摧毁博弈的有效性。
更为隐蔽的问题是噪声经验的恶性累积。在自博弈的探索阶段,解答者会遇到大量完全超出当前能力边界的极端难题。如果将每一次失败都提炼成技能,记忆库就会迅速充斥着荒谬、不可执行或极度特定的无效信息。随着记忆库体积膨胀,不仅检索延迟激增,检索出的噪声还会反噬解答者的探索轨迹。
最后是训练与记忆的脱节。传统的技能增强方法大多是在模型训练完成后外挂一个检索器,或者在固定的训练集上维护静态库。这种被动的单向输入使得自博弈的提问者完全感知不到解答者的进化,无法形成任务难度与能力储备相互推动的课程效应。
SESA 的核心闭环:非对称自博弈与四阶段演化
为了破解上述矛盾,SESA 将程序化记忆重新定义为自博弈过程中的一个“动态演化状态”。它由两个独立参数化的策略组成:提问策略 $\pi_p$(Challenger)与解答策略 $\pi_s$(Solver),并通过四阶段飞轮驱动任务生成与技能库的双向共进化。
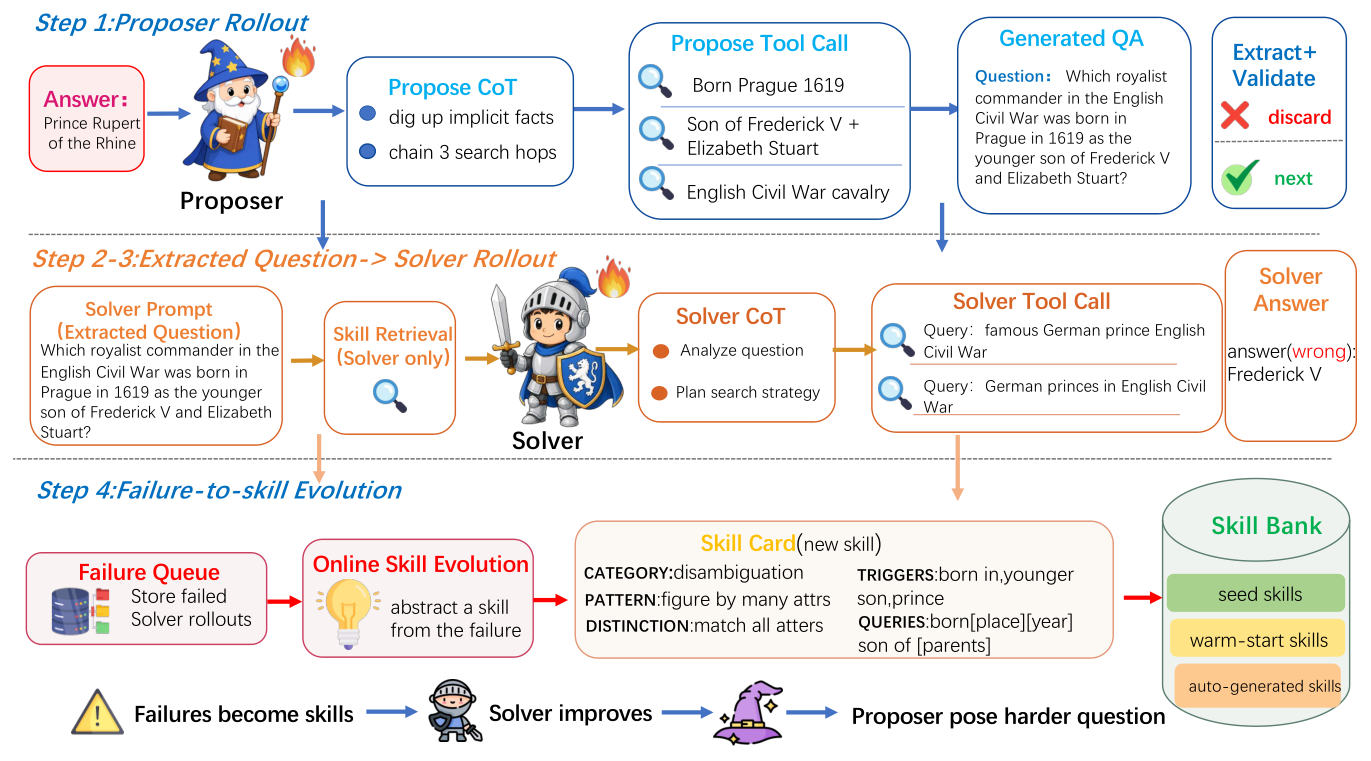
每个存储在记忆库 $\mathcal{B}$ 中的技能都被结构化表示为一个五元组:
\[s=(u, c, a, z, m)\]其中包含技能描述 $u$、触发场景 $c$、规避要点(Avoidance Cues)$a$、查询重写模板 $z$ 以及使用元数据 $m$。围绕这个活态资产,SESA 组织起完整的训练生命周期:
1. 记忆冷启动(Memory Priming)
在训练开始前,SESA 构建了包含 157 条初始经验的基础记忆库 $\mathcal{B}_0$。其中 15 条由人工编写,涵盖多跳搜索中常见的消歧、回退重试等通用范式;另外 142 条则从前期的自博弈引导阶段中挖掘去重而来。这批冷启动数据确立了后续技能提炼的颗粒度与表征基准。
2. 信息非对称的自博弈(Asymmetric Self-Play)
提问者 $\pi_p$ 与解答者 $\pi_s$ 采用独立模型参数。在每一轮交互中,提问者仅根据目标实体及跳数要求生成问题,无法访问任何技能库;而解答者在面对问题时,首先通过密集检索器检索与当前输入最相关的 Top-$k$ 个技能,将其拼入 Prompt 作为战术参考。这种信息非对称性确保了解答者成功率可以客观衡量问题的内在难度,防止出题策略被解题记忆污染。
3. 基于能力边界的前沿塑形(Frontier Shaping)
这是保证记忆库质量的关键门控。如果解答者面对某道题全军覆没(成功率 $\hat{p}_s=0$),说明该问题严重超纲;若全部答对($\hat{p}_s=1$),则说明问题缺乏信息量。SESA 利用分组相对策略优化(GRPO)中采样的 $G$ 条轨迹,计算经验解出率:
\[\hat{p}_{s}(x)=\frac{1}{G}\sum_{i=1}^{G}\mathbf{1}\{r_{s}(\tau_{i},a^{\ast})>0\}\]基于此,提问者获得的奖励被塑形为一个双侧惩罚的倒 U 型函数:
\[r_{p}(x)=\left\{\begin{array}{ll}-\lambda,&\hat{p}_{s}(x)\in\{0,1\},\\ 4(\ell+\hat{p}_{s}(x))(h-\hat{p}_{s}(x)),&\text{otherwise},\end{array}\right.\]其中设置 $\ell=0, h=1$,极端情况施加惩罚 $-\lambda$。该函数强制提问者在解答者的“能力前沿”(Competence Boundary)附近出题。只有那些处于可学习区间内的试错,才能进入后续的提炼阶段,阻断了超纲垃圾信息污染记忆库的通道。
4. 在线失败提炼与记忆去重(Failure Distillation)
并非所有失败都会沉淀。SESA 建立了一个容量上限为 300 的暂存队列,专门收集那些在前沿难度下未能成功解出的真实轨迹。系统每 10 个训练步执行一次沉淀,优先选取反复受挫或即便有了策略指导依然失误的高价值案例。
由专门的判断模型对失败轨迹进行溯因反思,提炼出前序策略未能覆盖的新触发词、检索重构模板和避坑指南。为了防止记忆爆炸,新提炼出的技能必须通过严格的多样性过滤:使用 E5-base-v2 计算文本向量余弦相似度,只有与现有记忆库及同批次新技能的相似度均低于 0.93 时,才被允许写入记忆库:
\[\max_{s^{\prime}\in\mathcal{B}_{t}\cup\Delta\mathcal{B}^{<s}_{t}}\mathrm{sim}(e(s),e(s^{\prime}))\leq 0.93\]这一机制赋予了记忆库动态的新陈代谢特征:随着解答者在技能辅助下攻克旧盲区,提问者被前沿奖励驱动着去探索更复杂的题型,新题型带来的新失败再促使记忆库进化,形成生生不息的上升螺旋。
核心实验:打破自博弈与技能增强的性能上限
评估 SESA 的有效性需要解答两个根本问题:第一,相比纯自博弈或传统的静态技能学习,SESA 是否真的具有泛化优势?第二,所获得的提升到底仅仅依靠测试期的外挂检索,还是真正改变了模型本体?
研究团队在严格遵循零外部监督(不接触任何下游测试集提问)的设定下展开训练,并在 7 个涵盖事实检索与多跳推理的主流基准上完成了 3,125 道保留测试题的评估。
在不同规模与结构的基座模型上,SESA 均展现出了明显的超额收益:
-
Qwen3 系列模型:在 Qwen3-4B 上,SESA 相比纯自博弈(SSP)平均准确率提升 2.3 个百分点;在 Qwen3-4B-Instruct 上提升 2.7 个百分点;在 Qwen3-8B 上提升达到 3.2 个百分点。对比未参与持续训练的原生基座模型,其总跃升幅度分别达到了 10.9、11.8 和 7.0 个百分点。
-
跨架构与专业化模型:在 LLaMA-3.1-8B 上,SESA 相比 SSP 提升 1.2 个百分点,相对基座模型提升 10.8 个百分点。即便在已经经过海量检索专项微调的 Search-R1-7B 检查点上,SESA 依然能在高位继续拉升性能,达到 57.5% 的平均准确率。
-
对比主流技能强化学习方案:在 Qwen2.5-7B 体系下,研究人员统一在相同检索后端、解码配置与语义判别器下对比了此前代表性的 SkillRL。SkillRL 取得了 50.1% 的平均准确率(比 SSP 高 0.6),而 SESA 达到了 51.0%,以 0.9 个百分点的稳定优势胜出。
这一系列跨参数量、跨模型家族的稳定增益证明,在动态前沿上协同演化出的技能,质量显著高于在固定语料或静态任务上沉淀的外部知识。
双路径收益解耦:技能如何沉淀进模型参数?
在很多人的固有认知中,记忆库或 RAG 系统的性能增益属于“挂件收益”——检索器一关,模型就会被打回原形。SESA 实验中最具技术启发性的发现,恰恰是对这一假说的有力反驳。
研究团队设计了三组严格对照的评估模式:
-
SSP:完全不接触记忆库训练的传统自博弈解答模型;
-
SESA-Off:由 SESA 联合训练完成,但在测试阶段完全关闭检索器、不提供任何外部技能提示的模型;
-
SESA-On:保持 SESA 权重不变,在测试阶段开启最终记忆库检索的模型。
测试结果揭示了技能价值的“双路径沉淀”现象:
在 Qwen3-4B 上,SESA-Off 相比 SSP 依然拥有 1.8 个百分点的净优势,而 SESA-On 相比 SESA-Off 仅额外提供了 0.5 个百分点的外挂增益;在 Qwen3-8B 上,SESA-Off 维持了 2.2 个百分点的内化优势,开启外挂记忆后进一步增长 1.0 个百分点。
这意味着,技能的大部分红利已经被模型参数彻底吸收了。其内在机理在于:在训练阶段,检索到的高价值技能重构了解答者的 On-Policy 采样轨迹,使得智能体在强化学习探索中能够更容易找到正确的搜索路径并获得正向奖励。通过这种机制,技能作为一种“高阶探索脚手架”,直接引导了策略梯度的优化方向,将有效的工具使用范式直接编织进了神经网络的权重内部。
这一特性具有极高的工程价值:在对延迟极其敏感或算力受限的生产环境中,开发者可以直接部署 SESA-Off 模式,无需承受检索外部技能库带来的显存与上下文开销,依然能全额享受自博弈与技能演化带来的模型本体能力进阶;而在追求极限精度的复杂推理场景中,再开启 SESA-On 进行非参数化补充。
机制消融与训练动态:为什么缺少闭环就不行?
为了验证四阶段设计中各项模块的不可替代性,消融实验提供了明确的证据支撑。
当从框架中移除“在线失败提炼”(Failure Distillation)时,模型性能瞬间暴跌 2.7 个百分点。这证明仅仅依靠冷启动提供的 157 条先验技能,系统很快就会在自博弈深入后遭遇泛化瓶颈。如果没有随难题前沿实时生成的新技能做支撑,解答者在面对提问者升级后的新型长尾问题时将束手无策。
前沿塑形(Frontier Shaping)同样至关重要。移除前沿塑形后,提问者失去了难度感知惩罚,往往会退化为随机生成大量极度晦涩或极度琐碎的问题,导致写入记忆库的技能包含大量无效噪点,拖慢训练效率并损伤最终精度。
从训练过程的监控曲线中可以观察到一个非常健康的演化特征:随着训练步数的推进,提问者生成的高质量、可用问题占比持续攀升并趋于收敛。与此同时,记忆库中的活跃技能数量呈现出“先快速扩张、随后在严格去重和淘汰机制下平稳收缩”的倒 V 型轨迹。这表明记忆库并非无底线地堆砌碎片经验,而是在与环境的互动中自我提纯,真正演化为一套高度紧凑、可操作性强的搜索方法论。
总结与展望
SESA 改变了我们看待外部记忆库与大模型强化的方式。以往的研究往往将记忆库视作静态的数据容器,或仅仅将其看作推理期的提示工程插件;而 SESA 证明,程序化记忆完全可以作为强化学习中的一个活态演化变量。
通过将自博弈出题的“动态前沿”与技能沉淀的“经验记忆”深度耦合,SESA 构建了一个能感知盲区、自主沉淀解法、并将外挂经验反哺内化为参数权重的完整自进化系统。这一框架不仅在开放域问答与多跳复杂搜索上确立了更坚实的方法论,也为未来通用智能体在缺乏人类标注的环境中实现长期、自主、无上限的策略进化提供了值得借鉴的技术路径。