SeqLLM:微信支付风控落地,大模型如何兼顾序列建模与语言能力?
SeqLLM: Augmenting LLMs with Behavioral-Sequence Modeling for High-Stakes Decisions at WeChat Pay
在超大规模移动支付平台的风控体系中,日常决策往往处于“高风险、低容错”的悬崖边缘。以微信支付(WeChat Pay)为例,系统每天需要完成数千万商户的风险巡检与资金流筛查。这类场景最棘手之处在于,无论是单纯审查商户填报的资质文本,还是孤立分析其交易流水统计特征,都无法识别出高隐蔽性的洗钱或欺诈行为。真正确凿的作案证据,几乎只存在于商户文本资料与长期交易行为序列的深层交汇处。
ArXiv URL:https://arxiv.org/abs/2608.03063v1
传统的做法通常在文本大模型与时间序列模型之间构筑隔阂:大型语言模型(LLM)精通复杂长文本理解和逻辑推演,却天生读不懂连续的行为序列;而序列推荐或图算法擅长挖掘行为动态,却无法进行语义推演并给出可追溯的合理解释。直觉上,为大模型注入行为序列建模能力是必然路线,但在工业级真实规模下,让大模型通过持续预训练(CPT)学习行为 Token,往往会引发灾难性的能力崩溃——在千万级行为序列的冲击下,大模型的通用语言理解能力往往会瞬间腰斩。
由腾讯、上海交通大学与香港城市大学联合提出的 SeqLLM 框架直面这一核心矛盾。该研究并不依赖传统“先破坏、再修复”的持续预训练加蒸馏路径,而是通过紧凑的离散字段级词表、文本接地的轻量投影器以及前缀引导能力注入(Prefix-Guided SFT)机制,成功让 Qwen3-8B 等基座在不遗忘通用语言能力的前提下,获得了原生的行为序列建模与联合推理能力。目前,SeqLLM 已在微信支付千万级商户巡检与欺诈拦截两大核心业务中全面落地,将高风险筛查精度从 92.0% 提升至 97.5%,商户端申诉率由 12% 骤降至约 2%,且实现了被拦截商户“零复议翻盘”。
隐蔽欺诈与大模型的“两难困境”
在支付平台的实际对抗中,狡黠的黑灰产团伙往往深谙规则对抗。以一个真实案例为例:某商户在营业资质和平台建档中登记为主营“服装百货”,但在日常运营中,该商户在直播间引导用户购买玉石,并要求买家通过私信发送的静态二维码进行付款。如果风控系统只看商户建档文本与客户零星的投诉碎片,“引导私聊二维码”或许显得可疑,却无法构成强有力的定罪证据;如果只依赖常规行为模型统计其交易总额和笔数,其流水波动也极易被包装在正常消费区间内。
只有当风控系统将这两类异构模态联合审视时,破绽才会完整浮现:其交易流水在时间维度上高频集中在深夜,资金流向跨越全国数十个省份,付款账户大多呈现老年人画像,并且伴随着反复的账单撤销与删除操作。“文本维度的类目不符与私单指控”与“行为维度反常的深夜异地高额密集交易”,在时空交汇点上严丝合缝地印证了非法集资或诈骗的特征。
然而,让大模型同时胜任这两类异构数据的推理极其困难。行业早期的粗暴方案是将行为序列直接序列化为自然语言字符串输入大模型,这不仅导致上下文长度呈几何级数爆炸,还会强行借用自然语言词表来表达严苛的业务行为,在语义空间中造成严重的语义混淆与信号衰减。
另一派路线则效仿多模态,引入专用的行为离散编码(例如借助 VAE 离散化生成 Token),随后通过持续预训练(Continual Pre-training, CPT)将行为知识硬塞给模型底座。以开源领域代表性的 OpenOneRec 架构为例,其必须在 15.6 万条行为序列旁配比高达 400 万条辅助通用语言样本,事后还需引入额外阶段进行知识蒸馏,即便如此也难以彻底遏制通用能力的滑坡。更致命的是,当面临微信支付这种行为序列规模跃升至数千万($\sim 10^7$)量级的真实工业场景时,暴力 CPT 会导致大模型基座的通用语言能力发生断崖式崩溃——实验表明,底座模型的 C-Eval 评测分数会直接从 0.78 剧烈下坠至 0.27。通过不断追加通用文本数据来抵消遗忘的思路,在海量行为流前彻底失效了。
字段级词表与两阶段投影:为行为赋予原生语义
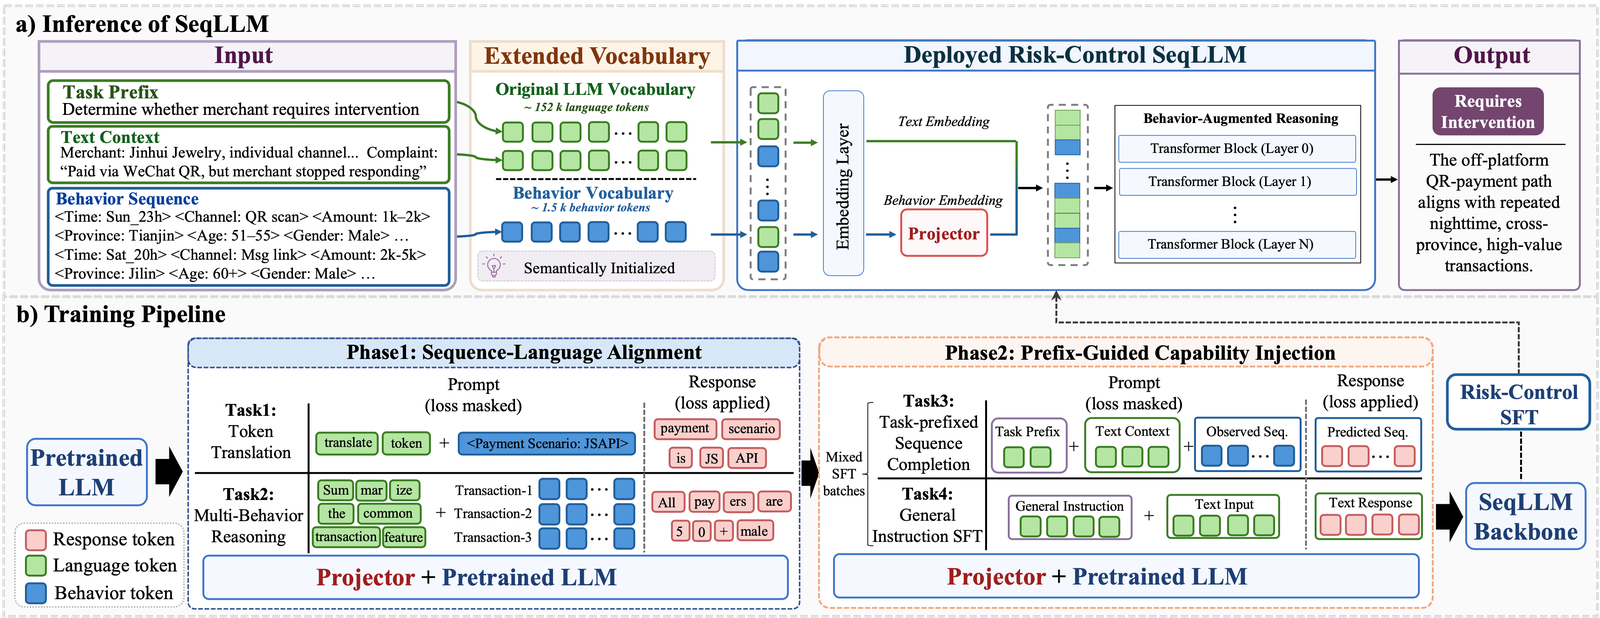
面对模态融合与遗忘的双重挑战,SeqLLM 首先重构了行为数据的表示逻辑。在支付系统中,一次完整的交易事件不仅包含商户与用户 ID,更涉及交易时间、交易金额区间、支付通道、交易状态等高维异构属性。以往部分研究倾向于使用整体事件 ID,但这既无法应对未见过的长尾行为组合,也无法支持决策归因。
SeqLLM 采用“字段级因式分解”(Field-level Factorization)构建紧凑的离散行为词表。每一个交易事件被拆解为其包含的属性子集,各字段的离散取值映射为独立的专用 Token,即通过词表空间累加 $\sum_{i}\vert{}V_{i}\vert{}$ 表达潜在的笛卡尔积空间 $\prod_{i}\vert{}V_{i}\vert{}$。这种设计不仅将原本需要数十个自然语言词元描述的复杂事件压缩至平均约 9 个专用 Token(实现了约 6 倍的上下文压缩比),而且天然支持组合泛化:即便是此前从未出现过的新型交易组合,只要其时间、金额或渠道字段曾被系统认知,大模型就能基于字段交互推导出合理的风险表征,风控人员也可以准确追溯到底哪一个字段诱发了风险警报。
在将这些新生行为 Token 送入大模型主干前,SeqLLM 构建了一个带有残差连接的轻量级行为投影器(Behavior Projector):
\[g_{\psi}(\mathbf{e}) = \mathbf{e} + \text{MLP}_{\psi}(\mathbf{e})\]新加入的行为 Token 在初始化阶段缺乏语义坐标。SeqLLM 并未采用随机初始化,而是提取行为字段的明文标签(如“深夜交易”“异常大额”),计算其对应文本在冻结大模型词嵌入表中的平均语义向量,并对其进行均值与方差归一化对齐。
随后的第一阶段训练采用了“翻译到推理”的两阶段对齐课程(Two-stage Alignment Curriculum):
-
Token 跨模态翻译:强制投影器将离散行为 Token 还原并翻译为自然语言描述,同时利用反向任务验证文本到行为代码的映射,将行为 Token 稳稳锚定在大模型的固有语义空间内;
-
多事件联合语义推理:利用行为序列片段引导模型回答特定归纳问题(例如辨识商户的典型客单价特征或异常操作),促使投影器不仅理解单个事件代码,还能在行为 Token 之间建立上下文语义连贯性。
前缀引导能力注入:为何 SFT 能够战胜 CPT?
完成了行为 Token 的语义对齐后,如何让大模型学会像风控专家一样,从数以百计的时间步长中洞察商户行为模式的长期演变规律?这通常需要引入序列自回归监督(即预测下一个事件)。然而,这也是引发灾难性遗忘的元凶。
标准 CPT 在序列建模时,通常采用全局自回归损失:
\[\mathcal{L}_{\mathrm{CPT}} = -\sum_{t=1}^{N}\log p_{\Theta}(b_{t}\mid b_{<t})\]在海量无标注行为数据训练下,大模型的每一层、每一个注意力机制参数都会被无差别地向“行为 Token 预测”方向拉扯,导致预训练阶段沉淀的自然语言语义拓扑全面退化。
SeqLLM 的破局点在于提出了前缀引导能力注入(Prefix-Guided SFT)机制。研究团队颠覆了“先用无监督预训练硬塞行为流、再做监督微调”的传统认知,将下一个事件的预测重塑为带前缀指令的条件生成任务:
\[\mathcal{L}_{\mathrm{Prefix}} = -\sum_{t=m+1}^{N}\log p_{\Theta,\psi}(b_{t}\mid\mathcal{I},b_{<t})\]在训练过程中,输入序列被显式包裹上结构化的任务提示前缀(Task Prefix $\mathcal{I}$),并且损失计算被严格限制在响应区域的行为 Token 以及交替混合的通用指令数据集上。大模型只有在识别到特定任务前缀时,才会激活专门用于行为序列分析的参数通路;而在未出现该前缀时,原有的语言理解回路得以完整保留。
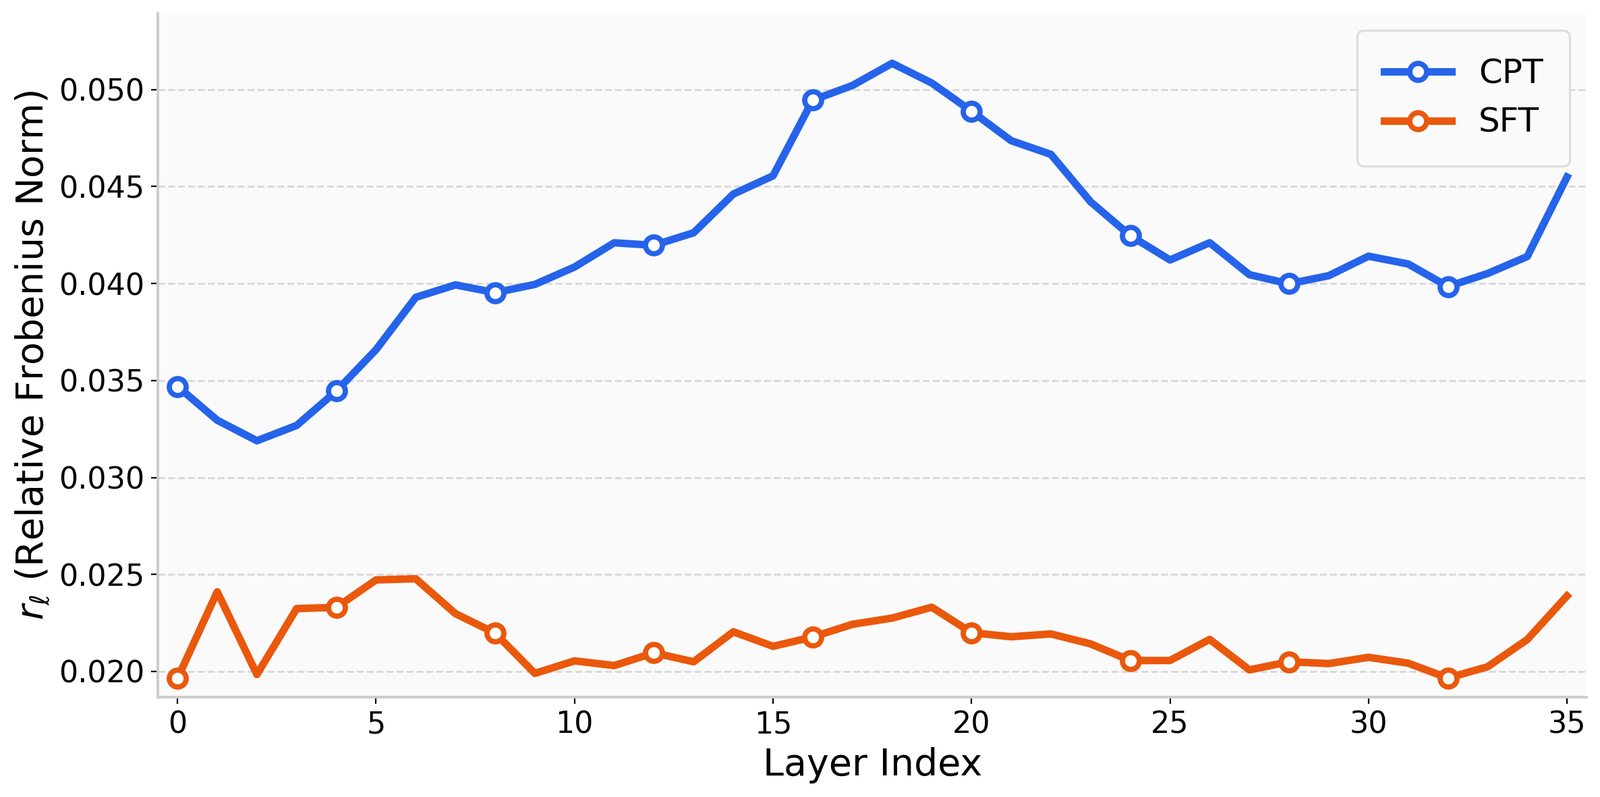
这一机制的底层机理在 Transformer 参数更新层面上得到了直观验证。论文对各网络层的相对权重更新幅度进行了细致监控,对比结果揭示了本质差异:在样本量严格对齐的传统 CPT 训练下,整个大模型特别是处于语义表征核心的中间层网络,其参数权重发生了剧烈偏移,导致原有的语言逻辑结构被破坏;而前缀引导 SFT 带来的参数更新幅度要微小且平缓得多。
这种极具针对性的梯度更新策略,彻底打破了模型学习行为能力与遗忘语言能力之间的负相关锁链。在基于千万级微信真实商户序列的对比测试中,SeqLLM 在下一次行为预测精度上达到了与暴力 CPT 完全一致的顶级水准(HR@10 均达到 0.804 左右),但其在权威中文语言理解基准 C-Eval 上的得分稳定维持在 0.789,而 CPT 基线的 C-Eval 分数则直接跌入谷底,仅剩 0.293。
微信支付实战:高精准筛查与欺诈特征供给
在微信支付的生产实践中,SeqLLM 承担着两套相辅相成的重要角色:一是作为端到端的商户联合审核主模型,二是作为底层欺诈检测系统的行为表征引擎。
针对每日吞吐量达千万级的商户巡检任务,SeqLLM 接收经过前置投影的行为序列与商户多维文本描述,直接判定该商户是否属于高危实体并输出规范的判定逻辑。在长达三个月的线上并行阴影测试(Shadow Evaluation)中,SeqLLM 展现出极高鲁棒性:
在平台最高风险分位的商户核查中,此前基于 DeepSeek 架构优化的生产基线模型准确率为 92.0%,而 SeqLLM 直接将检出准确率拉升至 97.5%。在风控业务中最令人头疼的误杀问题上,SeqLLM 展现了惊人的收敛能力:在系统实施处置动作后,涉事商户的主动申诉率由基线的 12% 急剧压缩至约 2%,并且在所有申诉案件的复核流程中,系统给出的风控结论实现了“零翻盘”(No exonerations),即被拦截且申诉的商户全部被二次核实存在实质违规,未发生一例误伤合法经营者的情形。
而在底层百亿级高并发实时交易欺诈检测流中,SeqLLM 则展示了其作为高阶特征基座的迁移价值。团队将 SeqLLM 预训练产出的离散行为 Token 嵌入向量,直接初始化注入线上实时欺诈检测系统的底层网络。在严苛的线上 A/B 测试中,这一初始化策略带来了巨大跃升:极高危分群检测指标 Precision@Top-0.01% 获得了 26.8 个百分点的绝对提升,Recall@Top-1% 提升了 33.1 个百分点。这不仅改写了该生产欺诈检测模型历次版本迭代的最大增幅纪录,更证明了前缀引导训练学到的行为 Token 空间,具备泛化到各类异构风险场景的扎实语义底座。
破除技术壁垒:从高危风控走向通用推荐
虽然 SeqLLM 的直接驱动力源自微信支付的高严苛风控诉求,但“文本+行为长序列”的异构交互范式本身具备高度通用性。为了验证技术方案的通用迁移能力,研究团队在 MovieLens、Amazon Reviews 以及大规模序列推荐公开评测基准 RecIF 上进行了严格对照。
在 MovieLens 与 Amazon 评测集上,对比通过交叉注意力压缩用户向量的经典基线 User-LLM,SeqLLM 在 Recall@5 指标上取得了最高 32% 的相对增益,不仅对用户长期历史偏好具备更细粒度的解构能力,更彻底规避了 User-LLM 在全量微调模式下语言能力流失的弊端。
在由 OpenOneRec 团队推出的 RecIF 标准基准上,SeqLLM 展现了极高的能效比。结合强化学习后,SeqLLM 在生成候选召回指标 Pass@32 上相比完整的 OneRec-8B 体系提升了 14.2%。更为重要的是计算资源的极度节约:OpenOneRec 依赖大规模持续预训练、多域回放和专门的知识蒸馏流程,而 SeqLLM 仅耗费了其 五分之一的 GPU-Days(训练算力开销缩减 4.8 倍),且完全省去了独立的蒸馏环节。
为了进一步探究模型对行为代码的深层语义认知,论文还构建了包含四项子任务的微观探测基准 RecProbe。在视频-主题匹配(Video-Topic Matching)任务中,SeqLLM 将分类准确率从基线 OneRec-8B 的 0.465 提升至 0.745。这表明经过翻译对齐与前缀注入后的行为代码,在大模型隐空间内不再是冷冰冰的稀疏符号,而是与通用自然语言完全互通的具象概念。
结语与行业启示
长期以来,工业界的大模型落地往往徘徊在纯文本交互的外围,在搜索、推荐与核心风控等依赖大规模离散行为流的硬核腹地,传统序列模型与图网络依然占据统治地位。SeqLLM 的价值在于打破了“要么牺牲序列精度,要么毁灭语言智力”的伪命题。它证明了大模型完全有能力在不伤及语言中枢的前提下,原生融合细粒度的物理世界行为序列。
这项来自微信支付实战的技术方案,为多模态大模型的扩展边界提供了一个兼具学术严谨与工业工程美感的样本:抛弃代价高昂且难以掌控的持续预训练范式,转而利用解耦的字段语义词表与轻量任务前缀引导梯度收敛。随着这种融合范式的演进,大模型不仅能够担当业务系统的辅助解释者,更将作为感知全域数据的决策神经中枢,在海量激增的复杂商业风险面前,做出更快、更准且真正可信的终局裁决。