SPIRAL:自监督对齐跨路径偏差,长文本视觉压缩逼近原生54分
Same Semantics, Different Paths: Self-Improving Alignment for Vision-Text Compression
处理数十万甚至上百万 Token 的超长上下文,是目前大语言模型在实际落地中最沉重的计算负担。由于 Transformer 架构的自注意力机制在序列长度上呈二次方或线性伴随显存膨胀,处理超长文档时庞大的 KV Cache 往往会迅速吃光显卡显存。为了绕开这个瓶颈,学术界和工业界近来兴起了一种被称为视觉文本压缩(Vision-Text Compression,简称 VTC)的新思路:把动辄上万字的长篇文本像排版网页一样渲染成一张张高分辨率图片,再送进多模态大模型的视觉编码器(ViT)提取特征。一张密密麻麻的排版图像,可以把数千个文本 Token 压缩为几百个视觉 Token,直接换来数倍的 Token 压缩率与推理加速。
ArXiv URL:https://arxiv.org/abs/2608.02109
但这条看似巧妙的捷径,却隐藏着一个被长期忽视的结构性陷阱。在标准基准测试 VTCBench 上,业界领先的多模态开源模型 Qwen3-VL-8B 在直接阅读原生纯文本时能够取得 55.60 分,而一旦将同样的文本渲染成图片走 VTC 路径,其综合得分便剧烈下跌至 35.10 分。
这种性能崩溃究竟源于渲染过程中的信息丢失,还是源于模型内部表征的断层?最新研究明确指出,问题的核心不是“如何压缩得更小”,而是多模态模型内部存在着严重的跨路径不一致性(cross-path inconsistency)。为此,研究者提出了名为 SPIRAL(Self-improving Path Integration and Realignment)的自监督对齐框架。该框架不需要任何外部标注或更大的教师模型,仅利用大模型自身的原生文本理解能力去纠正渲染图像的理解偏差,便将 Qwen3-VL-8B 在 VTC 下的得分从 35.10 提升到了 54.02,几乎抹平了与原生文本输入之间的差距,甚至击败了参数规模大其 30 倍的未对齐大模型。
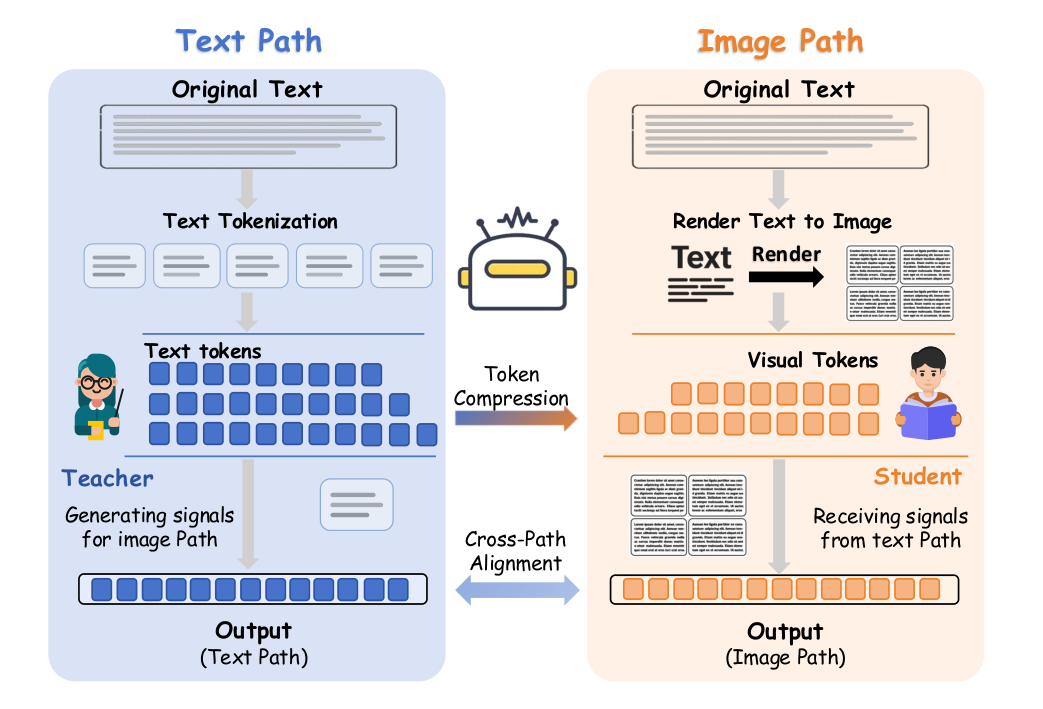
视觉长文本压缩的隐藏瓶颈:跨路径不一致性
为什么把纯文本画在图上,大模型就“看不懂”了?直觉上容易归咎为分辨率不足或字符渲染模糊,但实验证明事实并非如此。多模态模型的视觉编码器(通常是 ViT)在预训练阶段主要摄取的是自然图像,其注意力偏向于辨别物体边缘、纹理、字形排版以及视觉几何轮廓,而不是深层的自然语言逻辑。
当同一段语义内容 $x$ 输入模型时,系统实际上存在两条平行的通路:
一条是文本路径(Text Path),原始文本经过分词器(Tokenizer)直接转换为文本 Token,其表征直接继承了语言模型深厚的语义理解与因果推理逻辑;
另一条是图像路径(Image Path),文本先经过排版引擎 $r(x, s)$ 渲染为高密度位图,再由 ViT 打碎为视觉 Patch Token 并映射进语言模型的隐藏空间。
虽然这两条路径共享同一个多模态大模型基座,但在图像路径中,ViT 输出的表征充斥着大量的视觉渲染属性(字体、字号、间距、换行),这些冗余的低级感知特征遮蔽了文本原有的语言学语义。在对渲染参数施加轻微视觉扰动的敏感度测试中,原生模型的下游表现往往会发生剧烈波动。这表明模型在图像路径下高度依赖表层的图形线索,一旦字形排版微调,理解能力便随之崩塌。
这一发现彻底重构了 VTC 领域的核心命题:提升压缩性能的关键,不是一味追求把字印得更小、排得更密,而是要想办法让图像路径学出来的隐藏表征,重新对齐回原生文本路径的高质量语义空间。
更关键的是,这一观察同时蕴藏着最优雅的解法。既然两套输入共享同一个基座模型,且该基座在纯文本模式下的表现本就相当出色,那么模型自身的文本路径,就是最好的天然教师,根本无须耗费昂贵的算力引入外部大模型,也无须雇佣人工标注微调数据集。
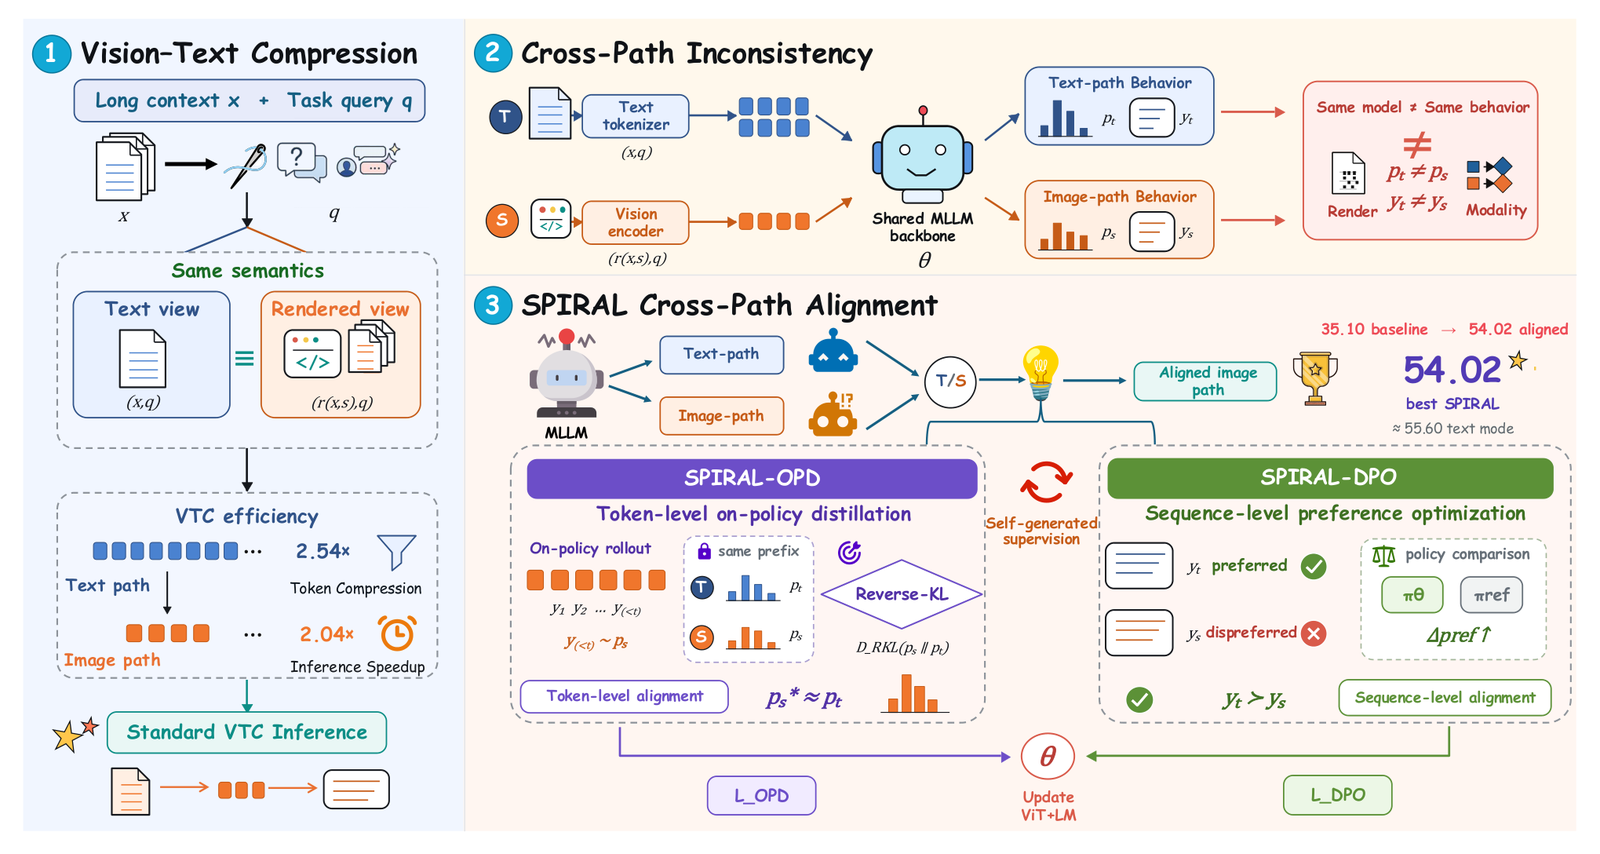
SPIRAL 双重粒度对齐:Token 级与序列级的互补机制
为了将图像路径诱导回正确的语义轨道,SPIRAL 框架设计了两种互补维度的自监督对齐机制:Token 级别的同策蒸馏(On-Policy Distillation,简称 OPD)与序列级别的直接偏好优化(Direct Preference Optimization,简称 DPO)。
局部保真:Token 级同策蒸馏(OPD)
在细粒度的长上下文信息检索中,哪怕丢失一个数字或错看一个专有名词,推理链条就会全盘断裂。单纯依靠常规的离线蒸馏(Offline Distillation)容易诱发严重的“训练与测试分布不匹配”——如果在训练时给学生喂入的标准路径完全来自文本端的最优状态,模型在实际推理面对图像输入时,一旦走出一步错误的分布,便无法自行恢复。
SPIRAL 引入了同策策略(On-Policy)。给定包含渲染图像 $r(x, s)$ 与问题 $q$ 的输入,首先让处于图像路径下的当前策略自回归采样生成答案轨迹:
\[y \sim p_{\mathcal{S}}(\cdot \mid r(x,s), q)\]沿着模型自己在视觉模式下滚出来的行为轨迹,在每一步 $t$ 上,计算文本路径真实后验分布 $p_{\mathcal{T}}$ 与图像路径预测分布 $p_{\mathcal{S}}$ 之间的散度损失:
\[\mathcal{L}_{\mathrm{OPD}} = \sum_{t \in \mathcal{Y}} D\Big(p_{\mathcal{T}}(\cdot \mid y_{<t}, x, q), \, p_{\mathcal{S}}(\cdot \mid y_{<t}, r(x,s), q)\Big)\]这种逐步的监督信号非常致密。在模型自主探索的真实错误状态上,文本通路充当了一个在旁边实时把关的考官,逐步纠正视觉通路在局部 Token 分布上的漂移。随着训练推进,视觉通路产生的自生成轨迹质量越来越高,反过来又促成了更加准确平稳的对齐目标,形成了一条自我提升的正向循环。
全局连贯:序列级直接偏好优化(DPO)
逐 Token 的局部对齐虽然能够保障字词级别的忠实度,但在面对需要全局推理与跨段落记忆的长文本任务时,局部合理的 Token 拼接依然可能导致全局回答结构松散甚至跑题。此外,On-Policy 采样因为需要在训练步中完整 Rollout 序列,在大规模数据扩展时的计算开销相对昂贵。
为了补全全局语义连贯性,SPIRAL 同时探索了序列级偏好对齐。在同一套上下文和问题下,原生文本路径由于没有视觉语义漂移,其生成的完整回复天然被视作胜出偏好项($y^+$);而未经对齐的图像路径生成的完整回复则被视作被惩罚的败选项($y^-$)。
利用 DPO 损失,SPIRAL 引导模型直接在序列概率层面扩大两者的相对优势:
\[\Delta_{\theta} = \log\pi_{\theta}(y^{+} \mid r(x,s), q) - \log\pi_{\theta}(y^{-} \mid r(x,s), q)\] \[\Delta_{\mathrm{ref}} = \log\pi_{\mathrm{ref}}(y^{+} \mid r(x,s), q) - \log\pi_{\mathrm{ref}}(y^{-} \mid r(x,s), q)\] \[\mathcal{L}_{\mathrm{DPO}} = -\log\sigma\big(\beta(\Delta_{\theta} - \Delta_{\mathrm{ref}})\big)\]序列级对齐并不强制要求每个位置的概率分布严格贴合,而是给予解码策略更高的宏观自由度,引导图像路径产出在整体逻辑、论证结构和记忆广度上更加逼近文本输出的高质量回答。更重要的是,DPO 不需要在线 Rollout,计算开销更低,极易在大规模成对样本上进行算力扩展。
值得注意的是,传统的监督微调(SFT)只是一种最简单的离线跨路径逼近,容易受限于表层拟合;而 SPIRAL 针对性地解耦并独立验证了 OPD 与 DPO 两大策略,展示出两种粒度截然不同的优势剖面。
实验评测:如何从 35.10 跨越至 54.02?
评估长文本视觉压缩的真伪价值,最严格的试验场莫过于涵盖信息检索、多步推理以及全局记忆的综合基准 VTCBench。
以 Qwen3-VL-8B 为基座的核心实验中,未经对齐的 VTC Baseline 得分仅有 35.10。经过 SPIRAL 对齐后,整体表现出现了质的飞跃:
SPIRAL-OPD 取得了 54.02 的总分,几乎全盘追平了纯文本输入模式下的 55.60 极限分数;
SPIRAL-DPO 则在推理和长程记忆任务上拿下了全场最高的单项成绩(推理得分 44.17,记忆得分 34.14)。
在更具挑战性的长距离极端场景下,基准 Baseline 的检索性能随着上下文从 1k 扩增到 32k 时出现断崖式下跌,在 32k 长度时仅剩 63.37 分;而借助细粒度逐步校准的 SPIRAL-OPD 表现出了极强的鲁棒性,在 32k 上下文依然锁定了 85.61 分的检索准确率,性能整整高出 Baseline 22 个百分点。尤为难得的是,训练阶段喂入模型的样本长度其实最高仅有 8k,这证明对齐后的语义抗干扰能力能够在更长的上下文空间中自然外推。
这种能力并不是特定模型架构带来的偶然红利。研究者将同样的训练对齐流程复现到另一个完全不同的开源视觉模型 InternVL3.5-8B 上,SPIRAL-OPD 和 SPIRAL-DPO 同样将原本孱弱的 13.46 分分别拉升至 22.61 分与 20.33 分,多项任务得分近乎翻倍。
在域外泛化测试中,SPIRAL 在 LongBench、2WikiMultihopQA 以及 GSM8K 等没有参与训练的任务集上同样展现出显著优势。例如在数学长推理数据集 GSM8K 上,经 DPO 对齐后的图像通路取得了高达 90.20 的成绩。相比之下,传统的 SFT 在多跳问答(2WikiMultihopQA)上甚至出现了负优化(从 40.94 掉到 36.31),这进一步印证了离线监督在复杂推理任务上的僵化缺陷,凸显了同策与偏好对齐机制的泛化底气。
为什么两套机制能够互补?
数据扩展性与消融分析揭示了两种粒度内部深层的机制权衡。
首先是样本利用效率与扩展潜力的取舍。在训练数据仅有 10k 个样本的极低资源配置下,SPIRAL-OPD 依靠高密度的逐步反馈,瞬间就能激发出 49.94 的强悍性能,表现出极高的样本利用效率;在 30k 样本量下进一步抬升到 54.02。但由于 On-Policy 在线采样的计算成本显著更高,当训练集扩展至 100k 时,DPO 的工程扩展优势便显露无疑。DPO 在 10k 时起点略低(43.29),但随着数据量线性扩张,在 30k 达到 50.27,最终在 100k 时稳健爬升至 53.77,几乎逼平 OPD 的上限。
换言之,在算力受限、样本有限且偏重精密检索提取的场景下,OPD 是更经济精准的选择;而在拥有大量配对文本语料、聚焦高阶思维链与多步骤宏观推理时,DPO 则提供了计算友好且上限明朗的扩展通道。
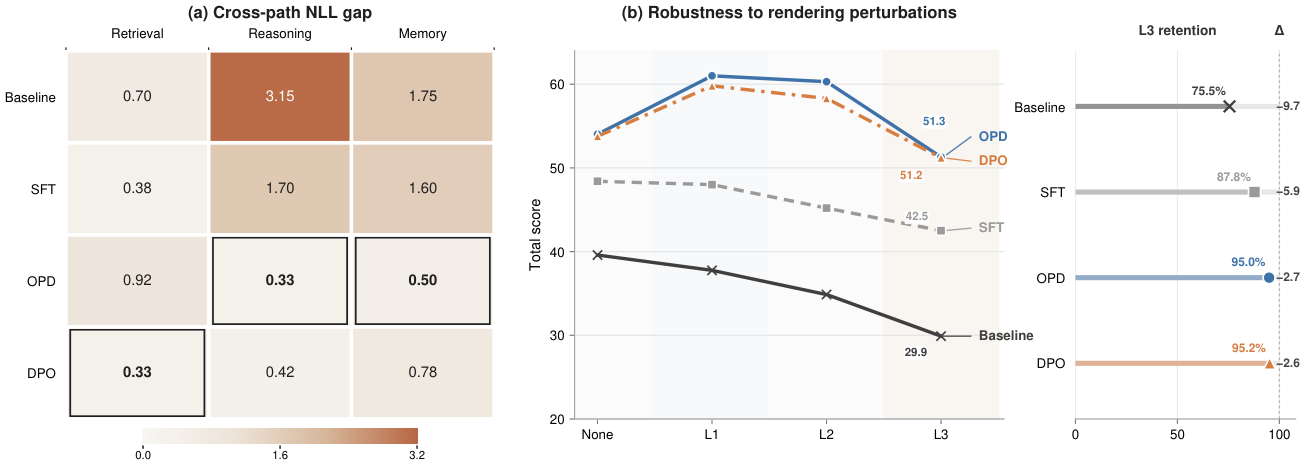
其次是对视觉干扰的根本免疫能力。上图展示的负对数似然损失差距(NLL Gap)与鲁棒性实验,给出了直观的理论解释。在未经对齐的 Baseline 模型中,图像模式下的 NLL 显著高于文本模式,二者存在宽阔的表征断层;而在面对渲染级扰动(改变字体大小、页边距、行高)时,Baseline 的得分在最严苛的 L3 扰动下断崖式暴跌 14.9 分。
反观经过 SPIRAL 处理后的模型,图像模式与文本模式的 NLL 差距被大幅压扁。在面对相同的 L3 排版扰动时,SPIRAL-OPD 仅仅下降 2.7 分,SPIRAL-DPO 仅仅下降 2.6 分。这一对比有力地表明,SPIRAL 并非让模型强行死记某种特定的排版版面,而是真正完成了表征去偏,促使 ViT 编码出的视觉 Patch 能够自动剥除浅层视觉属性的噪声,在语义投射层与纯文本表示实现对齐。
消融实验中对训练参数范围的探讨也印证了这一点:如果仅仅微调 ViT 视觉编码器,或者仅仅微调后面的 LM 语言主干,模型的综合得分都会严重落后于全量模型更新。因为跨路径一致性本质上是在跨模态交互的动态过程中发生的,只有将图像解析、跨模态投影与自回归生成视作一个有机闭环进行联合调整,才能让视觉输入在庞大的语言网络中自由穿梭而不失其真意。
总结与展望
利用多模态视觉处理超长文本,正在成为打破传统 Transformer 上下文成本壁垒的重要途径。但如果不解决模型在视觉编码时“重字形、轻语义”的表征偏移,压缩带来的成本优势就会完全被精度崩塌所抵消。
SPIRAL 的核心价值在于跳出了“继续死磕压缩算法本身”的既有思路,从表征对齐的深层视角审视多模态内部的通路矛盾,并巧妙利用大模型“自己的文本比自己的视觉更聪明”这一天然非对称优势,通过完全自监督的方式实现了以己为师。
当前的研究仍有探索空间,例如多轮迭代的自进化对齐、OPD 与 DPO 的混合目标联合优化,以及面向超高密度排版的分辨率缩放法则等。但 SPIRAL 已经给出了明确的启示:长文本视觉压缩的核心瓶颈不在于压缩率,而在于模态语义的保真度。当视觉表征能够完全平滑地契合语言原本的深度语义时,将文本“画”给模型看,才会真正从一种新奇的实验尝试,演进为长上下文推理降本增效的终极解法。