DREvo:不是堆砌历史,而是动态校准!Agent框架自演化提升16.2%
DREvo: Distilling Recalibrated Historical Experience for Harness Self-Evolution
在大语言模型(LLM)构建自主智能体(Agent)的实践中,模型底座往往只决定了理解与生成的下限,而包裹在模型外层的执行框架——即 Harness,才真正决定了 Agent 在真实复杂环境中的工程表现。Harness 承载着上下文组装、长短期记忆管理、外部工具调度以及输出解析等核心职责。从早期 SWE-agent 的交互式命令行,到 Terminus 与 OpenHands 这类沙箱控制台,优秀的 Harness 架构无一不是人类专家历经数周甚至数月手工排查报错、追踪执行轨迹(Execution Traces)后细致调优的产物。
ArXiv URL:https://arxiv.org/abs/2607.26722v1
为了摆脱这种对专家经验的高度依赖,学术界与工业界近期将目光投向了“框架自演化”(Harness Self-Evolution)。类似 Meta-harness、AHE 以及 ACE 等方案,试图通过“提议—评估—反馈”的闭环,让大模型充当提议者(Proposer),根据历史运行轨迹与报错总结不断修改自身的代码框架。然而,这种看似美好的自演化范式在实践中频繁遭遇瓶颈:随着演化轮次增加、积累的历史经验越来越丰富,Agent 的任务成功率不仅没有平稳上升,反而出现了剧烈的非平稳震荡(Non-stationarity)。演化搜索经常陷入“前进一步、后退两步”的怪圈,在有限的预算内很难稳定收敛到高水准的 Harness 架构。
针对这一顽疾,来自香港科技大学、浙江大学、东南大学等机构的研究团队提出了全新的自演化框架 DREvo(Distilling Recalibrated Historical Experience)。该研究指出,历史经验不能被无条件地当作静态真理使用,必须在代码状态演变的过程中被动态“重新校准”。通过函数级锚定、状态相关校准与角色引导的搜索意图提炼,DREvo 在领域推理与复杂 Agent 任务上不仅抹平了性能震荡,还相比现有基准分别取得了 16.2% 和 14.2% 的显著提升。
为什么积累了历史经验,演化依然会剧烈震荡?
传统框架自演化的标准范式通常是历史驱动的顺序优化:在第 $t$ 轮,提议者模型接收初始或上一轮的代码 $h_{t-1}$ 以及累积的历史经验库 $\mathcal{R}_{t-1}$,生成新版 Harness 代码 $h_t$;随后将其放入评测环境 $\mathcal{E}$ 中执行,收集新的运行日志与评测反馈 $\tau_t$,再将该记录追加进经验库中。
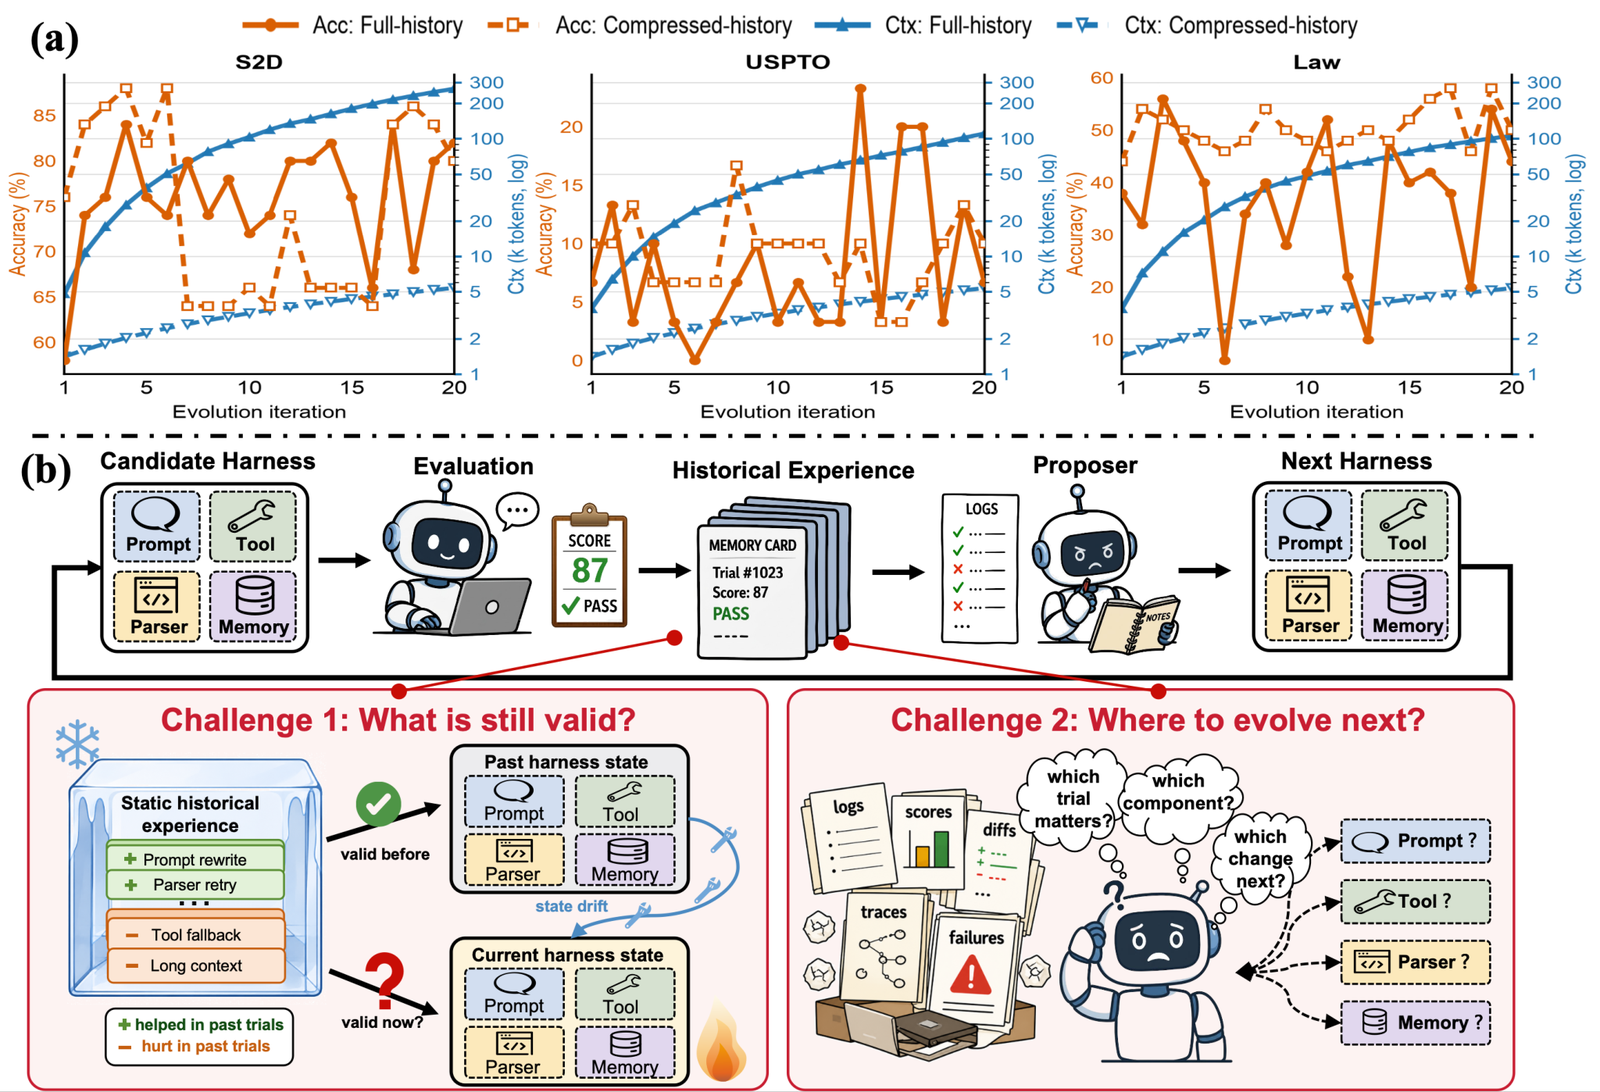
研究团队在使用当前顶级推理模型(如拥有 1M 上下文的 Claude 3 Opus)作为提议者进行长轮次演化实验时发现,无论是直接投喂完整的原始历史,还是提供压缩后的历史摘要,Agent 在化学反应预测(USPTO)、医学诊断(S2D)和法律推理(Law)等数据集上的准确率曲线都呈现出剧烈的锯齿状上下起伏。甚至在某一轮准确率已经达到很高水平后,下一轮模型根据历史总结做出的修改却可能导致性能骤降。
深入剖析提议者模型的决策过程后,作者团队将这种搜索失控归结为现有范式在利用历史经验时的两大根本缺陷:
首先是“什么经验依然有效?”(What is still valid)。在代码自演化过程中,历史经验具有极强的“状态依赖性”(State-dependent)。某一轮对上下文拼接逻辑的修改之所以能够提升性能,完全建立在那一轮特定的工具调用方式和输出解析函数的基础之上。随着后续迭代中其他组件的代码被重写,早期的前置条件已经不复存在。现有方案往往把历史成败记录作为静态真理喂给模型,导致提议者被陈旧的证据误导;更糟糕的是,某些在初期被证明为负向的改动,在后续组件升级后其实可能变为行之有效的方案,却因为在历史记录中被打上“错误”标签而被提议者永久弃用。
其次是“下一步该往哪演化?”(Where to evolve next)。一个完整的 Agent Harness 包含成百上千行代码,涵盖多个高度耦合的模块。当提议者面对长篇累牍的执行日志或多轮历史反馈时,不仅要在大脑中隐式推断成败与具体代码行的因果关系,还要同时决定本轮究竟是该“探索(Exploration)新方向”还是“利用(Exploitation)已知经验”,抑或是“规避(Avoidance)已知缺陷”。由于缺乏显式的搜索意图生成机制,这种复合决策完全依赖 LLM 的隐式概率推理,极其容易因单次采样的随机性而导致搜索方向发生大幅漂移。
DREvo 的解题思路:从原始日志到显式搜索意图
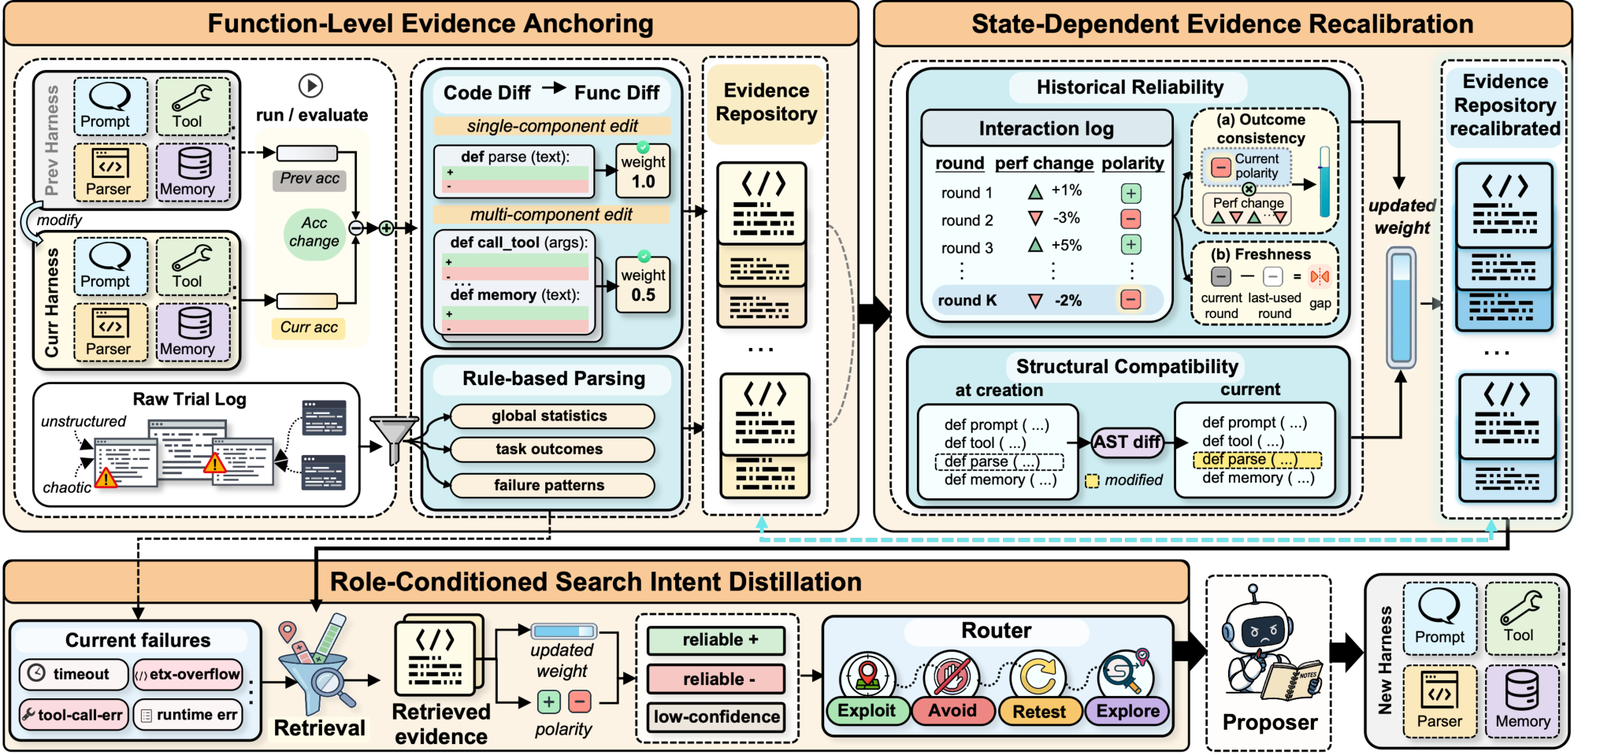
为了从根本上消除代码状态漂移带来的认知偏差,DREvo 将松散的历史日志转化为高密度的结构化证据,并在每次迭代中建立严密的动态校准流水线。整个体系由三个环环相扣的核心模块构成,对应着对“证据粒度”、“时效性”和“搜索指引”的系统性重塑。
1. 函数级证据锚定(Function-Level Evidence Anchoring)
传统的历史库保存的是整轮迭代的宏观记录:输入整份 diff 代码和整个测试集的 Macro 结果。这使得提议者很难知道到底是修改了哪个函数才引起了特定的执行报错。
DREvo 首先引入了函数级证据锚定。通过对前后两版代码进行抽象语法树(AST)分析,提取出具体发生变更的函数集合 $\mathcal{C}{t}^{\Delta}$。随后,系统借助 LLM 对本轮执行的详细轨迹与测试报错进行组件级归因,将粗粒度的运行记录拆解为以独立函数为载体的证据单元 $e{t,c}$。每个证据单元不仅包含修改前后的局部代码片段、观测到的执行反馈,还打上了明确的极性标签 $\rho_e \in {+1, -1}$(代表该修改引起了性能的正向提升还是负向回退)。这种细粒度分解使得后续的状态追踪与局部因果推断成为可能。
2. 状态相关证据校准(State-Dependent Evidence Recalibration)
拆解出函数级证据后,DREvo 并没有直接使用它们,而是在每一轮新代码生成前,对历史库中的每一个证据单元 $e$ 进行动态的有效性重估。这一评估由两个独立且互补的维度共同决定:
其一是历史可靠性 $r_t(e)$。一个历史建议是否可靠,取决于它在过往多次被引用时的一致性,以及它产生的距离当前轮次的时间跨度。如果在过去的演化中,类似修改多次产生了与最初判定一致的性能变化,其一致性得分 $\operatorname{cons}_t(e)$ 就会增加;同时,系统引入时间衰减因子 $\operatorname{fresh}_t(e) = 0.9^{t-\ell_t(e)}$,对过于久远的证据进行自然的权重降解。
其二是结构兼容性 $q_t(e)$。这是 DREvo 最具创见的设计之一。代码经验是否过时,最直接的证据是当前 Harness 中对应函数的实现与当初产生该经验时的代码实现相差多远。DREvo 利用 AST 计算两个函数状态之间的树编辑距离(Tree Edit Distance, TED):
\[q_t(e) = 1 - \frac{\operatorname{TED}(T_e, T_t)}{\lvert T_e \rvert + \lvert T_t \rvert}\]如果当前代码树 $T_t$ 相比产生证据时的代码树 $T_e$ 发生了巨大的结构变化,说明函数的上下文环境已大幅漂移,兼容性得分 $q_t(e)$ 便会趋近于 0。
最后,系统采用调和平均数将历史可靠性与结构兼容性整合成综合置信权重 $w_e = \frac{2 r_t(e) q_t(e)}{r_t(e) + q_t(e) + \epsilon}$。这种严苛的聚合机制意味着“一票否决”:即使一条经验在历史上再辉煌、复现再稳定,只要当前底层代码结构发生了剧烈改变,$w_e$ 也会被直接压低,彻底防止提议者被“刻舟求剑”式的陈旧经验所误导。
3. 角色引导的搜索意图提炼(Role-Conditioned Search Intent Distillation)
当历史证据被赋予了动态权重 $w_e$ 之后,接下来的关键问题就是如何将其转化为确定性的代码修改指令。DREvo 摒弃了将所有证据一股脑塞入 Prompt 让提议者自由发挥的做法,而是引入了显式的意图提炼机制。
系统首先将检索到的高相关度证据集根据权重阈值 $\theta$ 和极性 $\rho_e$ 划分为三个行为角色空间:
-
利用角色(Exploit Space, $\mathcal{X}_t$):权重高且极性为正($w_e > \theta, \rho_e = +1$),代表在当前代码结构下依然高度可靠的有效经验,提议者应当沿用或深化该设计;
-
规避角色(Avoid Space, $\mathcal{A}_t$):权重高且极性为负($w_e > \theta, \rho_e = -1$),代表在当前环境下已被反复证明有害的“确定性陷阱”,提议者在修改时必须严格绕开;
-
重访/探索角色(Revisit Space, $\mathcal{T}_t$):权重较低的证据($w_e \leq \theta$),这部分经验或者因为过于陈旧、或者因为函数结构已被大幅重构而失效。它们恰恰构成了最有价值的探索边界——先前失败的做法在新的代码骨架下很可能产生意想不到的正面效果。
在进入代码生成阶段前,系统先通过意图提炼器生成一份极度聚焦的文本搜索意向 $s_t$。该意图显式地指明:“本轮应针对哪个核心函数,采取哪种角色的策略,依据哪几条校准后的证据进行修改”。提议者 LLM 最终只需要在 $s_t$ 的明确约束下执行纯粹的代码实现工作,大幅降低了决策的认知负荷,从源头上遏制了搜索漂移。
实验评测:不仅性能登顶,更带来了稳健的演化收敛
为了全面检验 DREvo 的实际效果,研究团队在两类极具挑战性的场景上进行了严格的横向对比与深度测试:一类是侧重复杂上下文编排与推理策略的领域推理任务(包含化学 USPTO、医学 S2D、法律 Law);另一类是重度依赖环境交互、长程调用与工具容错的真实 Agent 任务(涵盖操作系统终端交互评测 Terminal-Bench 2.0,以及顶尖的代码修复基准 SWE-Bench Verified)。
在实验设定上,演化提议者统一采用具备超长上下文处理能力的 Claude 3 Opus,评测底座模型则在领域推理任务中采用开源的 GPT-OSS-120B,在复杂 Agent 任务中采用 DeepSeek-V4-Flash。为了体现演化预算的实际约束,领域任务限定演化 20 轮,Agent 任务限定演化 10 轮。
从最终评测数据来看,DREvo 在所有 5 个基准测试中均超越了包括 Meta-harness、AHE 和 ACE 在内的全部历史驱动演化基线,在领域推理任务上取得了平均 16.2% 的相对增益,在复杂 Agent 任务上也斩获了 14.2% 的平均优势。
特别是在代码修复极具代表性的 SWE-Bench Verified 上,DREvo 演化出的 Harness 展现出了跨越不同任务难度的普遍适配性。在细分仓库与难度梯度的对比中,无论是在中等偏难的 Matplotlib、Sympy 代码库,还是在涉及各种极端边界条件的复杂 Bug 修复中,DREvo 都展现出了更高的测试通过率。这证明了其演化出的框架并非单纯过拟合某些特定提问方式,而是在交互协议、错误捕获与状态重试机制等底层逻辑上形成了实质性的工程改进。
更为关键的证据来自演化轨迹分析。对比基线方案频繁的上下震荡,DREvo 在有限的演化轮次中呈现出近乎单调递增的平滑上升曲线。消融实验的数据进一步解构了三个组件各自承担的核心功能:
-
仅保留函数级锚定(A):在三项推理任务上分别带来了 8.0、2.3 和 3.0 个百分点的提升。这说明只要将粗粒度的大段日志落实到具体函数上,LLM 提议者就已经能大幅减少胡乱修改的无用功;但在逻辑更复杂的 Terminal-Bench 2.0 上,仅仅拆分函数而缺乏时效性评估,并不能带来增益。
-
引入状态相关校准(A + R):一旦加入了基于 AST 树编辑距离与历史可靠性的动态校准,所有任务的性能全线跳升,其中 Terminal-Bench 2.0 取得了 6.7 个百分点的直接飞跃。这直接证实了作者最初的核心判断:在组件状态频繁变迁的动态系统中,重新评估陈旧经验的有效性是保证 Agent 自演化不偏航的绝对前提。
-
融入角色引导意图提炼(A + R + D):当意图生成器将校准后的经验划分为“利用、规避、重访”并给出明确的搜索意向后,系统的综合性能达到巅峰,在 Terminal-Bench 2.0 上相较 A+D 组合高出整整 5.6 个百分点。实验同时表明,如果脱离了状态校准(R)而直接强行提炼意图(A+D),提议者在面对简单任务时虽有爆发力,但在高难度长程任务中会频繁误入歧途,再次证明了校准与提炼之间不可割裂的共生关系。
从静态 Prompt 优化走向动态系统演化
长久以来,学术界对于 Agent 优化的探索很大程度上局限在 Prompt Engineering 或记忆检索模块的微调上。然而,当大模型真正落地于全自动软件工程(SWE)或系统级运维等场景时,限制其能力的瓶颈往往不在于底座模型读不懂需求,而在于 Harness 没有提供足够鲁棒的文件读写沙箱、状态回滚保护和高效的上下文折叠机制。
DREvo 的探索展示了一种极具潜力的技术路径:将软件工程本身的抽象语法分析(AST)与演化搜索深度结合,把松散的自然语言报错与具体代码组件进行强因果绑定。更重要的是,它为长轮次自演化系统揭示了一个普适规律——在状态动态演进的复杂系统中,“遗忘”与“重新审视”和“学习”同等重要。过去被抛弃的路径在新框架下可能是奇兵,过去被奉为圭臬的规则在新架构里可能是羁绊。
随着以 Claude Code 为代表的专业工程 Harness 系统日益复杂,依靠纯人工调优框架已经逼近边际效益的拐点。通过精细化的证据校准机制克服自演化过程中的性能震荡,不仅能够帮助开发者在有限的 API 调用成本内快速搜索出适配特定任务的最佳 Agent 框架,也为未来大模型自主构建工具、自我迭代运行环境的深水区探索铺平了道路。