DLAM:把隐动作用高斯分布建模,视频预训练让真机成功率达到73.8%
DLAM: Distributional Latent Actions with Temporal Constraints
在具身智能(Embodied AI)与视觉-语言-动作(Vision-Language-Action, VLA)模型的研究中,高质量的真机演示数据始终是极度昂贵的稀缺资源。相比之下,网络上无动作标签的人类视频、日常场景视频以及跨本体机器人视频却近乎取之不尽。如何从海量无标签视频中汲取物理世界的动态变化先验,并将其无缝注入到下游机器人的动作控制策略中,是近年来隐动作模型(Latent Action Model, LAM)探索的核心课题。
ArXiv URL:https://arxiv.org/abs/2607.27138v1
传统的隐动作模型通常依赖视频重构任务来学习状态转移(Transition)。这种纯粹“自监督预测未来图像”的思路存在一个固疾:编码器学到的潜在表征很容易被相机视角晃动、光照明暗变幻或背景杂乱动态所带偏。这类特征虽然能在像素级重构上取得不错指标,却与机器人执行抓取、放置等物理操控所需的因果动作大相径庭。为了给隐动作注入物理世界的一致性,近期以 ALAM 为代表的结构化隐动作方案引入了时序合成(Composition)与时序可逆(Reversal)等几何约束。然而,这些方法无一例外都将两帧之间的动作用一个“确定性的单点”向量来表示。一旦面对多步复合的长时间视野,局部推断的微小残差便会在级联运算中被迅速放大,导致动作先验漂移甚至崩溃。
针对这一确定性表征的结构局限,阿里、高德、奇瑞、南京大学、上海交通大学及浙江大学等机构的联合研究团队提出了 DLAM(Distributional Latent Actions with Temporal Constraints)。这项工作不再把视觉转移动作压缩为一个静态的孤立坐标,而是将其建模为带均值和逐维方差的对角高斯分布。通过为高斯后验设计尺度归一化的时序复合与可逆约束,DLAM 既让均值严格对齐视觉观察变化,又让逐维方差扮演了自监督隐式正则化的角色。在下游策略迁移中,DLAM 仅使用冻结的均值表征与机器人真机动作联合进行流匹配(Flow Matching)生成,不增加额外的推理开销,便在 MetaWorld、LIBERO 以及真实机械臂任务上展现出显著优于以往确定性隐动作基线的操控表现。
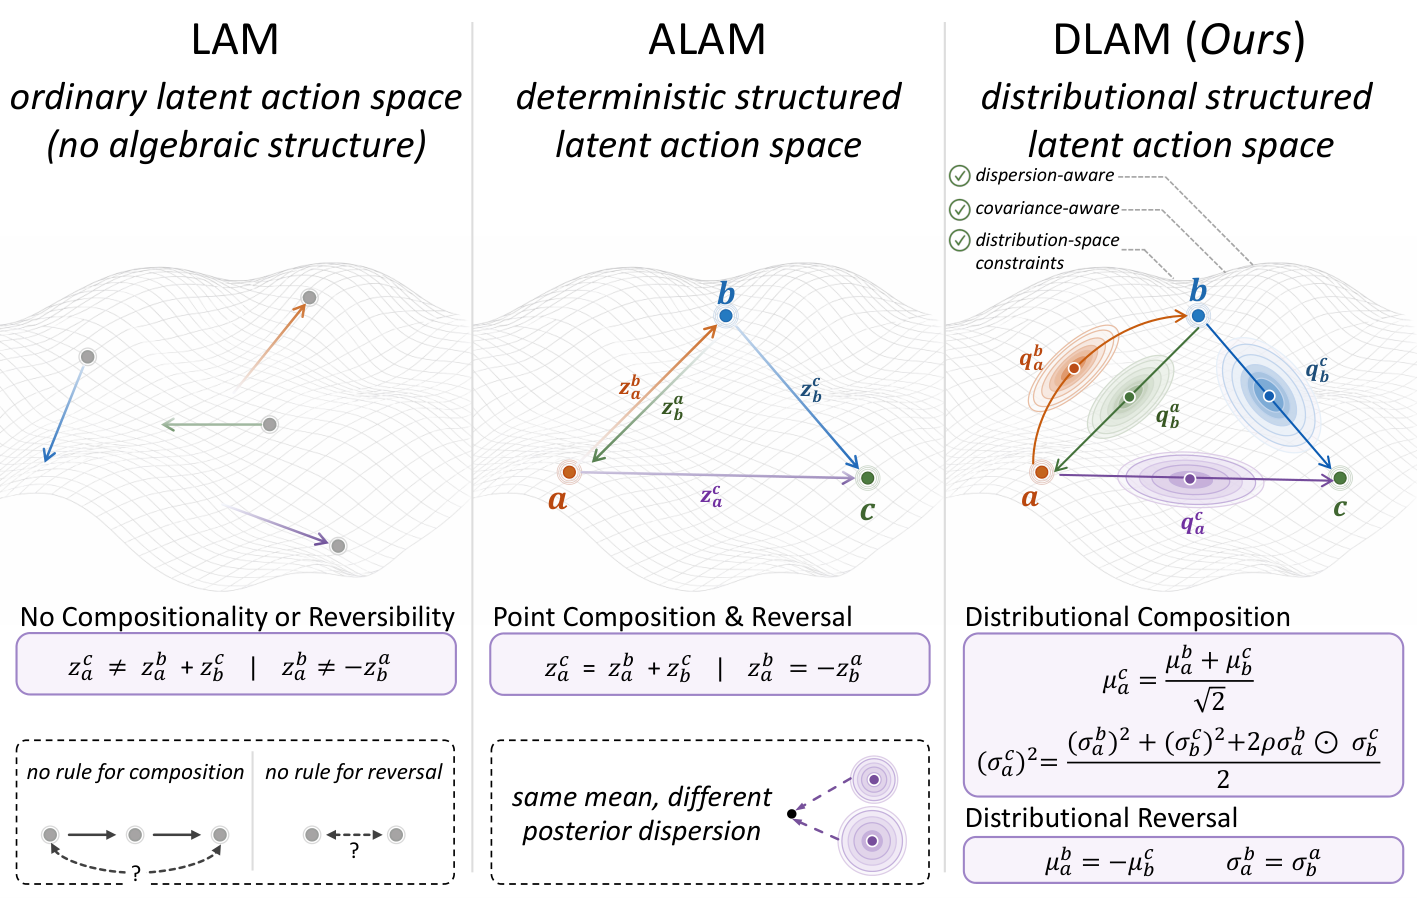
从确定性单点到对角高斯转移
理解 DLAM 的切入点在于区分“视频可预测性”与“动作可控性”。若单纯以重建下一帧为目标训练自编码器,网络往往倾向于抄捷径,记录无关于操作的局部像素扰动。为了纠偏,近年来的结构化隐动作模型开始向代数群论(Group Theory)借力:假设从状态 $A$ 移动到 $B$ 的动作加上从 $B$ 移动到 $C$ 的动作,应该在表征空间内等价于直接从 $A$ 移动到 $C$ 的一步长动作;同理,从 $B$ 移回 $A$ 的逆向动作在方向上应当直接取反。
这些约束确实赋予了表征更强的时序一致性,但把每一次动作都死板地定死在一个固定点向量上,隐藏着严重的误差级联风险。现实中的机械臂操作或物体位移充满局部不确定性,在无标签视频中提取的帧间转移必然带有推断残差。如果每一步转移都是确定性点,在长时序上把多段转移递归拼接时,残差没有任何缓冲释放的空间,复合向量与直接推断向量之间的欧几里得偏差会沿着时序步长急剧发散。
DLAM 的破局方案是将确定性点升级为分布。具体而言,给定视频连续帧对 $(O_i, O_j)$,编码器输出对应槽位上的对角高斯分布:
\[q_{i,\kappa}^{\,j}=\mathcal{N}\!\left(\mathbf{\mu}_{i,\kappa}^{\,j},\operatorname{diag}\!\big((\mathbf{\sigma}_{i,\kappa}^{\,j})^{2}\big)\right)\]其中 $\mathbf{\mu}$ 表示转移的中心均值,对数方差 $\mathbf{\ell} = \log \mathbf{\sigma}^2$ 被截断在固定区间内以防数值溢出。
这里必须厘清一个关键设计取舍:DLAM 引入方差,并不是为了像传统随机视频生成(Stochastic Video Generation)那样去采样多条并行的可能未来,也不是为了提供严格校准的贝叶斯不确定性度量。它的核心目的,是为编码器提供一个与均值强绑定的、可微分的自监督辅助梯度通道。在像素重构阶段,解码器仅接收均值 $\mathbf{\mu}$ 与参考帧特征,强制将均值锚定在真实发生的像素变化上;而方差则参与到专门设计的时序代数约束中,约束编码器在表征不同尺度动作变化时的几何延展性。
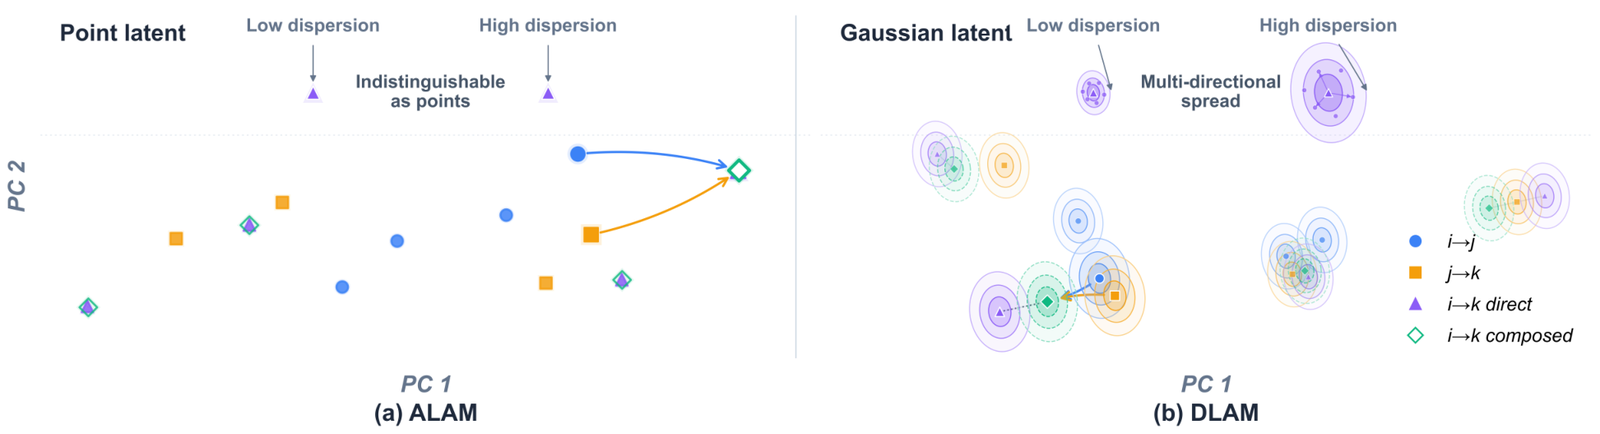
约束分布:相关感知的均值与方差复合法则
在确定性设定下,动作的复合通常是简单的向量加法。然而,当把两个连续的动作变量提升为高斯随机变量 $\mathbf{Z}{a}^{\,b}$ 与 $\mathbf{Z}{b}^{\,c}$ 时,它们的代数叠加就需要重新被严密审视。
DLAM 采样等间隔帧三元组 $(O_a, O_b, O_c)$,其中两两间隔满足 $b-a = c-b = k$。在这个三元组构成的时序小闭环中,存在两条走向 $c$ 的路径:一条是由编码器直接处理跨度为 $2k$ 的帧对 $(O_a, O_c)$ 得到的分布 $q_a^c$;另一条是先走一步 $(O_a, O_b)$、再走一步 $(O_b, O_c)$ 经由复合运算得到的分布 $\overline{q}_a^c$。
为了防止随着时序复合步数的增加使潜变量方差与范数无限膨胀,DLAM 采用了带有尺度缩放因子的归一化加和形式:
\[\mathbf{Z}_{a\rightsquigarrow c}=\frac{\mathbf{Z}_{a}^{\,b}+\mathbf{Z}_{b}^{\,c}}{\sqrt{2}}\]由此推导出的复合分布均值满足标准线性组合:
\[\overline{\mathbf{\mu}}_{a}^{\,c}=\frac{\mathbf{\mu}_{a}^{\,b}+\mathbf{\mu}_{b}^{\,c}}{\sqrt{2}}\]更为关键的是方差的复合。相邻两个动作段 $\mathbf{Z}{a}^{\,b}$ 与 $\mathbf{Z}{b}^{\,c}$ 共享了中间帧 $O_b$,从物理因果和视觉连续性上看,二者绝非互不相干的独立变量。若盲目假设独立性,合成方差便会系统性低估时序耦合。DLAM 为此引入了一个轻量且参数共享的相关系数 $\rho$:
\[\operatorname{Cov}(\mathbf{Z}_{a}^{\,b},\mathbf{Z}_{b}^{\,c})=\operatorname{diag}\!\left(\rho\,\mathbf{\sigma}_{a}^{\,b}\odot\mathbf{\sigma}_{b}^{\,c}\right)\]此时,复合后的对角方差公式拓展为:
\[(\overline{\mathbf{\sigma}}_{a}^{\,c})^{2}=\frac{(\mathbf{\sigma}_{a}^{\,b})^{2}+(\mathbf{\sigma}_{b}^{\,c})^{2}}{2}+\rho\,\mathbf{\sigma}_{a}^{\,b}\odot\mathbf{\sigma}_{b}^{\,c}\]这项改动虽然只增加了一个极小的标量参数,却优雅地补齐了物理世界惯性运动在潜动作方差维度的数学映射。
在时间对称性方面,对于反向帧对 $(O_b, O_a)$,可逆算子 $\mathcal{R}$ 要求其逆转物理过程:均值必须严格反号,而由于不确定性和信息量具有几何各向同性,其逐维方差必须完全保留:
\[\mathcal{R}\!\left[\mathcal{N}\!\left(\mathbf{\mu},\operatorname{diag}\!\big((\mathbf{\sigma})^{2}\big)\right)\right]=\mathcal{N}\!\left(-\mathbf{\mu},\operatorname{diag}\!\big((\mathbf{\sigma})^{2}\big)\right)\]最终,时序复合损失 $\mathcal{L}{\mathrm{comp}}$ 和时序可逆损失 $\mathcal{L}{\mathrm{rev}}$ 通过计算预测分布与目标分布之间的 Frobenius 范数残差共同建立,涵盖均值对齐项与对数方差对齐项。通过这种局部三元组监督,DLAM 在不强加刚性全局群结构的前提下,自发诱导出一个具备强局部几何连贯性的隐动作空间。
策略迁移:非侵入式流匹配联合生成
通过海量无动作视频完成预训练后,DLAM 必须有效赋能下游真实的机械臂策略。过去一些隐动作方法尝试训练额外的“潜动作到真实动作”解码器(Latent-to-Action Decoder),或者彻底推翻现存 VLA 模型结构,引入繁琐的双阶段微调流程。这类方案不仅增加了部署复杂度,还容易在交叉本体迁移时遭遇领域鸿沟。
DLAM 采取了一种更加务实且模块化的策略。在下游策略训练时,DLAM 的图像重构解码器被彻底丢弃,预训练好的隐动作编码器完全冻结。给定一段由真实机器人遥操作采集的成功演示轨迹,研究人员利用冻结的 DLAM 编码器,顺序提取未来连续若干帧之间的转移均值 $\mathbf{\mu}$。
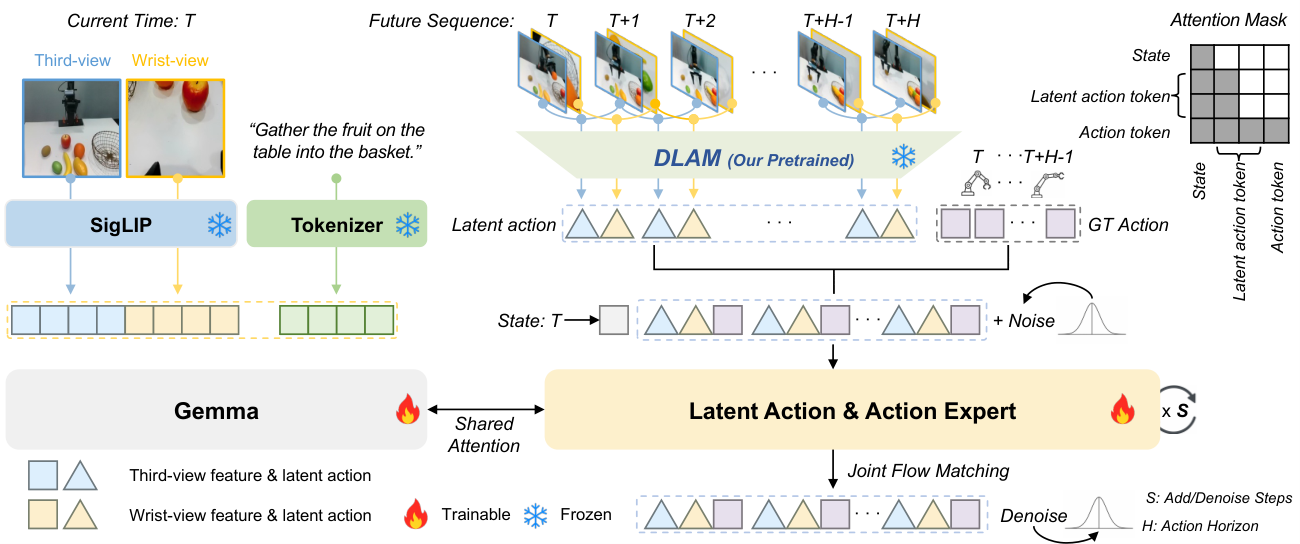
这里体现出 DLAM 的另一处务实取舍:下游任务完全抛弃方差输出,仅将转移均值序列作为辅助目标。正如前文所述,方差的使命已经在预训练表征塑造中达成;而在具体控制中,均值本身凝聚了去噪后的核心物理运动意图。
在策略骨干的选择上,DLAM 接入了当前在连续动作生成上表现优异的 $\pi_0$ 模型架构(以 PaliGemma-2B 为视觉语言底座,Gemma-300M 为动作专家网络)。策略网络同时接收当前第三人称视角和手腕相机的图像观察以及自然语言任务指令,通过流匹配(Flow Matching)目标,同时去噪生成两条输出流:一条是机器人直接可执行的笛卡尔末端轨迹或关节动作,另一条则是未来连续时间步对应的 DLAM 隐动作均值轨迹。
两条流在模型内部共享视觉与语言上下文,使得动作专家网络在解算机械臂转角的同时,被迫理解潜在的视觉变化空间规律。更关键的是,未来视频帧与冻结的 DLAM 编码器只在离线训练阶段用于计算损失;在实际部署推理时,机械臂只需输入当前观测,网络并行吐出两组预测,但物理系统只执行真实动作流。这种非侵入式设计实现了“用视频动力学先验为策略塑形,却无需在真机推理时耗费任何额外视觉预测算力”。
实验评测:长时序鲁棒性与基准击穿
为了检验表征的泛化力,DLAM 的预训练直接基于来自 Open X-Embodiment 与 CALVIN 等 11 个完全没有动作标签的机器人视频数据集混合体,在 64 张 AMD MI308X GPU 上完成了 57 个 Epoch 的端到端训练。随后,研究团队从底层动力学几何一致性、视频重构质量以及下游操控成功率三个层面进行了多维度的评估。
在保留数据集的转移一致性诊断中,研究人员用长度感知探针对超出直接监督跨度(即大于 $2k$,甚至延伸至 $10k$)的时序间隔进行了复合与可逆残差测试。实验数据表明,随着时序跨度拉长,确定性基线 ALAM 的残差呈现出陡峭上升的趋势,这意味着单点误差在长视野下发生了失控的级联累积;相反,DLAM 的复合与可逆残差不仅在绝对数值上处于明显低位,并且曲线随着步长增加表现出极佳的平缓性。在跨度为 $3k$ 至 $5k$ 的端点视频重构实验中,DLAM 的直接重构 PSNR 相比 ALAM 提高了 3.45 dB,多步复合累积重构 PSNR 提高了 1.17 dB,感知指标 LPIPS 在直接重构和累积重构上分别降低了 45.6% 和 26.1%,印证了高斯分布建模对缓解长程误差发散的本质有效性。
而在最为关键的下游控制评测中,这种表征层面的几何优越性直接转化为了执行层面的高可靠性:
-
MetaWorld MT50 全量任务基准:涵盖 50 种不同难度的桌面机械臂操控。在完全相同的 $\pi_0$ 策略微调框架下,纯动作训练的 baseline 成功率仅为 47.9%,而挂载了 DLAM 均值辅助流后,多任务平均成功率大幅提升至 87.6%,相比纯动作基准提高了 39.7 个百分点,并击败了包括 RT-2、OpenVLA 以及确定性隐动作模型 ALAM(85.0%)在内的全部对比基线。值得注意的是,提升幅度最显著的正是需要精密长程规划的 Very-Hard 难度分级,DLAM 将成功率从 ALAM 的 82.0% 提升到了 91.3%。
-
LIBERO 仿真基准:评估包含 Spatial、Object、Goal 与 Long 四大套件的泛化能力。DLAM 在该基准上达到了令人惊叹的 99.0% 的总平均成功率,在极其依赖长程因果连贯性的 LIBERO-Long 任务中达到了 98.0%,相较 ALAM(95.3%)和 OpenVLA(52.7%)表现出极大的优势。
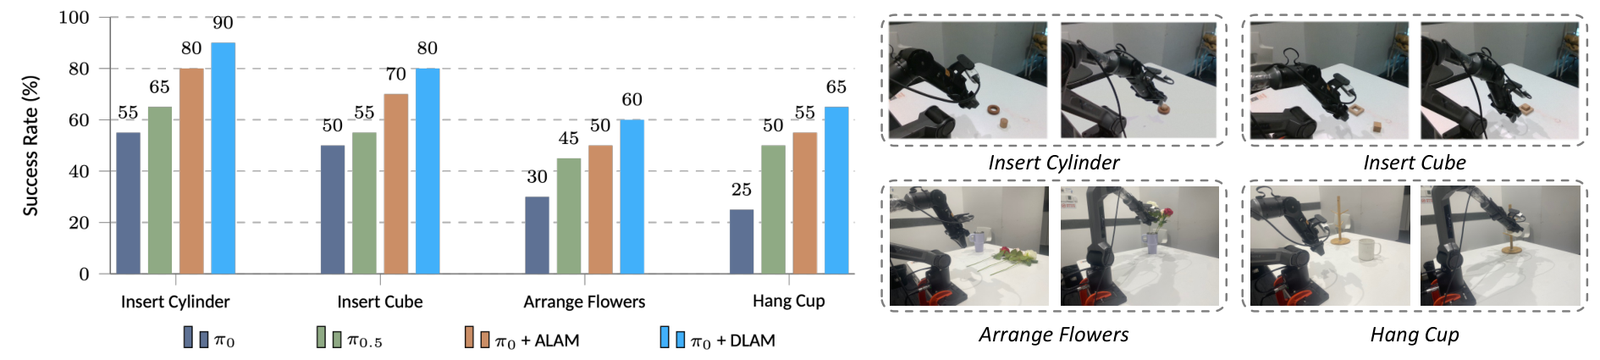
真实世界的物理操控实验更是检验动作先验成色的试金石。研究人员在一台 Piper 6 自由度机械臂上部署了包括圆柱插入(Insert Cylinder)、方块插入(Insert Cube)、插花(Arrange Flowers)和挂杯(Hang Cup)在内的 4 组复杂真实任务。结果显示,挂载 DLAM 的策略在所有 4 项真机任务中均取得了最高胜率,平均成功率达到 73.8%。作为对比,未引入视频先验的原生 $\pi_0$ 仅有 40.0%,规模更大的 $\pi_{0.5}$ 达到 53.8%,而确定性先验的 ALAM 停留在 63.8%。在每一个独立的真机子项上,DLAM 均稳定超越确定性基线 10 个百分点。
消融实验揭示的机制分工
为了拆解各个组件在最终成功率中的贡献,研究团队进行了严密的消融实验。对比的四个变体均在完全相同的训练集、骨干参数与计算预算下运行:
-
无时序约束基准(No temporal relations):仅保留高斯编码器和像素重构先验,移除复合与可逆约束;
-
纯均值匹配(Matched mean-only):强制令 $\sigma=1$ 且 $\rho=0$,退化为仅对均值应用归一化时序复合与可逆;
-
独立方差学习(Learned variance, $\rho=0$):恢复逐维方差预测与方差约束,但在复合时假设前后帧互相独立;
-
完整 DLAM 模型:在方差复合中加入学习到的共享相关系数 $\rho$。
消融数据清晰地揭示了不同技术设计的职责分工:
从无时序约束切换到“纯均值匹配”时,视频累积重构 PSNR 从 21.236 dB 跃升至 22.109 dB,MetaWorld 策略成功率从 76.6% 提升至 82.1%。这说明尺度归一化的均值时序几何约束是驱动视频重构质量提升以及基础控制能力建立的主要引擎。
进一步引入对角高斯方差($\rho=0$)后,重构质量保持在相当水平,但由于方差通道为编码器施加了尺度层面的自监督张力,策略成功率进一步攀升至 85.3%。最终,当激活考虑前后帧运动依赖的共享相关系数 $\rho$ 时,模型在累积重构 PSNR(22.400 dB)、时序残差以及下游控制成功率(87.6%)上均刷新了最佳表现,全套机制相比无约束基准带来了 11.0 个百分点的总增益。这一递进证明,方差建模与相关感知复合并非数字游戏,而是与均值约束互为表里,共同夯实了动作空间的结构完整性。
总结与启示
DLAM 为视觉动力学与机器人动作生成的结合带来了一个极具启发性的思路转变:在利用无标签视频挖掘环境动力学表征时,面对现实世界的时序残差与不确定性,我们不应强求网络把充满噪声的状态跃迁压制进死板的确定性单点,而应通过统计分布赋予其弹性和缓冲容忍度。
同时,DLAM 在工程落地层面的克制同样值得称道。尽管在预训练阶段构造了完备的高斯分布与相关系数矩阵,但在面对下游控制落地时,它果断选择仅导出信息密度最高的均值序列,以轻量级辅助任务的形式嵌入流匹配框架,既不给下游网络增加重型结构负担,又规避了推理阶段的算力冗余。这种将分布理论用于表征正则化、将确定性均值用于最终控制的解耦思路,无疑为大规模利用 Action-Free 视频数据训练通用机器人基础模型提供了极具实用价值的技术范式。