ARCTIC:从逐行审查到代码批判,漂移检测让失准再降5.76分
From Code Review to Code Critique: Intent, Drift, and Spotlight for AI-Generated Diffs at Scale
在过去一年里,软件工程领域最明显的变化之一,就是 AI 编程智能体(Coding Agent)正以人类难以企及的速度制造代码。一个提示词或者一个任务单,智能体就能在几分钟内修改几十个文件、生成上千行代码变动(Diff)。但这种产能爆发很快将软件开发卡在了一个新的瓶颈点:同行评审(Peer Review)。
ArXiv URL:https://arxiv.org/abs/2607.29516
传统代码审查的核心假设,是团队里有经验的工程师产出代码的节奏相对平稳,团队成员有足够的心智带宽去仔细逐行检查。如今这个假设彻底失效了。面对动辄几千行的机器生成代码,人类审查者根本看不过来,大量大型变更甚至在未经实质审查的情况下就被迫合入系统。更麻烦的是,现有的所谓“AI 审查工具”多数只是在代码风格、格式规范等细枝末节上喋喋不休,而在人类最关心的核心逻辑、安全隐患与性能退化上表现得极其疲软。雪上加霜的是,智能体在漫长的推理与工具调用链条中,经常会出现“跑偏”,即生成了表面上能跑通但完全脱离开发者真实意图的代码(Agentic Drift),现有的审查机制对此几乎毫无防备。
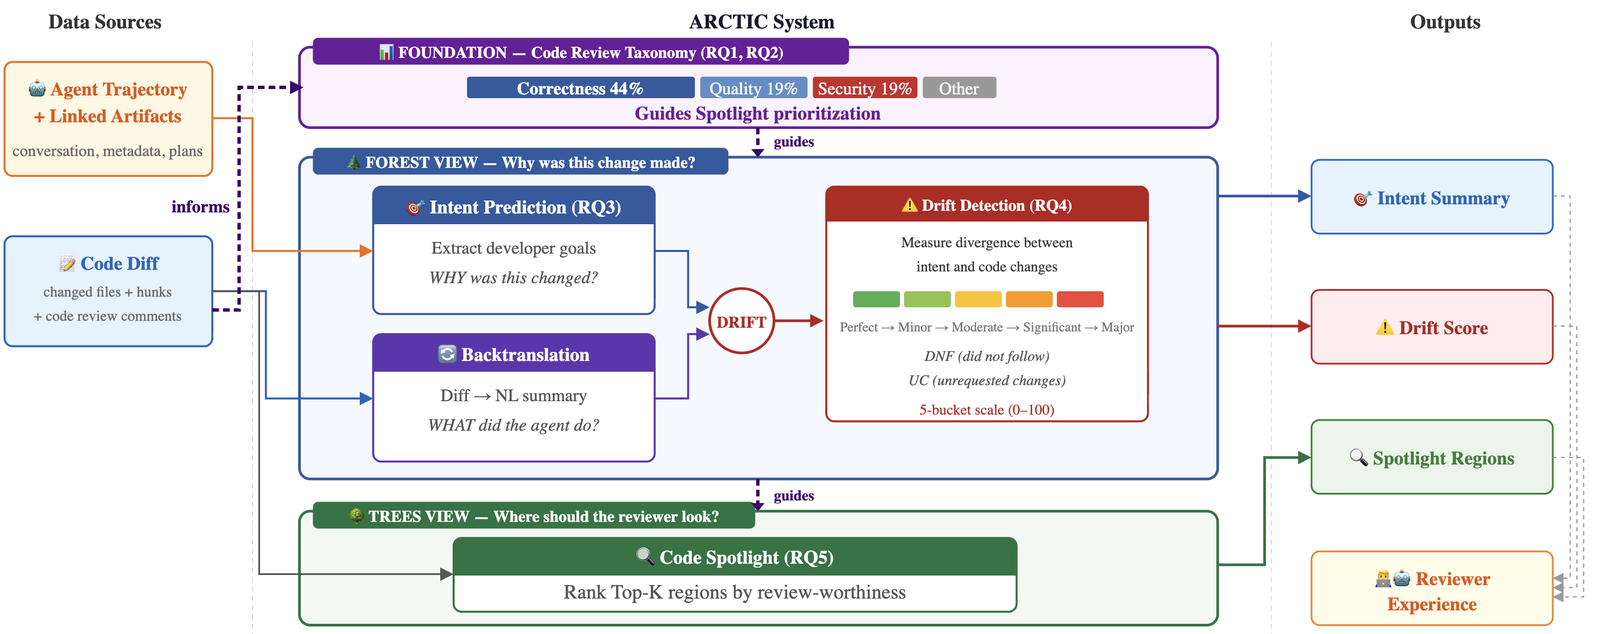
针对这一困局,来自工业界的研究团队提出了全新审查系统 ARCTIC。这项工作的核心立意,是将以往针对语法和样式的机械式“代码审查”(Code Review),重构为面向全局架构与关键风险的“代码批判”(Code Critique)。系统通过意图预测(Intent Prediction)、漂移检测(Drift Detection)以及代码聚光灯(Code Spotlight)三项机制,使代码失准分数进一步下降了 $5.76$ 分,并在仅消耗五分之一 Token 的前提下,实现了缺陷定位能力的数倍跃升。
现有 AI 代码审查为何沦为“噪音制造机”?
为了搞清楚人类专家在审查时到底在看什么,研究团队首先建立了一个扎实的地基。他们收集并深入分析了超过 $18{,}000$ 条被工程师实际采纳的人类与高质量 AI 审查批注,通过反复归纳与校验,提炼出了覆盖软件审查核心关切的六维分类体系(Taxonomy):正确性与可靠性(Correctness & Reliability)、代码质量(Code Quality)、安全性(Security)、代码设计(Code Design)、最佳实践(Best Practices)以及可读性与风格(Readability & Style)。
基于大模型多标签分类流水线对真实数据的标注结果显示,人类资深工程师在审查时有着极其鲜明的重心:高达 $44.4\%$ 的精力都死磕在“正确性与可靠性”上,紧随其后的是“代码质量”($19.2\%$)和“安全性”($19.1\%$)。换句话说,八成以上的人类审查关注点都集中在系统的健壮度与底层安全防护,而对于代码格式、最佳实践这类琐碎事项,人类只分配了极少的注意力。
当研究人员把市面上主流 AI 审查工具生成的 $2{,}000$ 条批注映射进同一套分类维度时,暴露出极其刺眼的断层。为了量化这种偏离,研究采用相对差异公式:
\[\text{Relative Difference}=\frac{\text{AI\%}-\text{Human\%}}{\text{Human\%}}\times 100\]数据对比显示,现存 AI 审查工具在“安全性”上的批注比人类基准少了整整 $89.5\%$,在“正确性与可靠性”上少了 $42.6\%$;相反,它们在“代码设计”上过度发散了 $+350\%$,在“最佳实践”上狂刷了 $+327.8\%$。
这种错位揭示了当前 AI 审查工具普及率低下的本质原因:工具并不是写不出意见,而是在关键缺陷上失语,在低价值区域制造大量信息噪音。当智能体生成了巨大的 Diff 时,这种噪音只会成倍消耗审查者的注意力。
见木又见林:ARCTIC 的系统设计哲学
面对大规模机器生成代码,ARCTIC 彻底放弃了“在每一行代码下插评论”的传统思路,提出将审查视角解耦为两个层级:宏观层面的“森林视角”(Forest View)与微观层面的“树木视角”(Trees View)。
森林视角不关心局部变量怎么命名,而是追问全局目标。它聚焦两个核心问题:开发者最初让智能体写代码的“意图”(Intent)到底是什么?最终代码与这个意图相比,有没有发生“智能体漂移”(Agentic Drift)?
为了让系统理解“为什么改动”,ARCTIC 实现了意图预测流水线。意图不同于代码变更摘要,摘要只回答“改了什么”,而意图必须解释“为什么改”。在智能体辅助开发的场景下,开发者的目标往往分散在多轮对话记录、任务计划和工单元数据中。ARCTIC 采用多源结构化抽取方案,在基准测试中,基于智能体的意图预测方法取得了 $0.860$ 的 F1 分数,显著高于通用 Zero-Shot 基线,能够准确还原开发者的业务初衷。
有了意图基准,系统便能对“智能体漂移”进行量化。智能体在执行复杂长任务时,极易擅自添加未经要求的额外功能,或者悄悄曲解原来的约束条件。ARCTIC 采用“反向翻译”(Backtranslation)的方法来捕获漂移:系统先将最终的代码变动反向提炼为自然语言摘要,再利用大模型对比该摘要与原始意图之间的差异,输出五级离散评分与 $0$ 至 $100$ 的连续漂移分值。在 $118$ 个平衡测试样本上,这套自动化漂移检测与人类专业标注者之间的一致性达到了惊人的二次加权 Kappa(QWK)值 $0.907$(线性加权 LWK 为 $0.776$),平均绝对误差(MAE)仅为 $10.31$。这意味着系统能够极其敏锐地抓出那些“看起来逻辑完整,实则南辕北辙”的幽灵修改。
而在树木视角,ARCTIC 引入了“代码聚光灯”(Code Spotlight)机制,以此解决大规模 Diff 中的注意力分配难题。聚光灯并不向开发者推送几十条零散的行级评论,而是综合分析整个变更的风险拓扑,挑出最值得人类审查的 Top-K 核心代码区域(Regions),并明确标注出审查该区域的具体理由。在包含 $298$ 个 Diff 的基准评测(CRBench)中,Spotlight 在质量预估指标上比现有主流 AI 审查工具高出 $2.4$ 倍,在缺陷定位准确度上提升了 $3.3$ 倍,同时消耗的 Token 数量减少到了原来的五分之一,端到端延迟降低了 $6$ 倍。它把宝贵的专家心智精确引导到了最容易出事的核心逻辑上。
人机协同重构:从阻塞式审查到作者自助合入
再强大的算法如果必须依赖繁琐的交互,也无法在真实研发流程中跑通。ARCTIC 将上述能力封装为模块化的服务接口,并重塑了工程师的代码提交工作流。
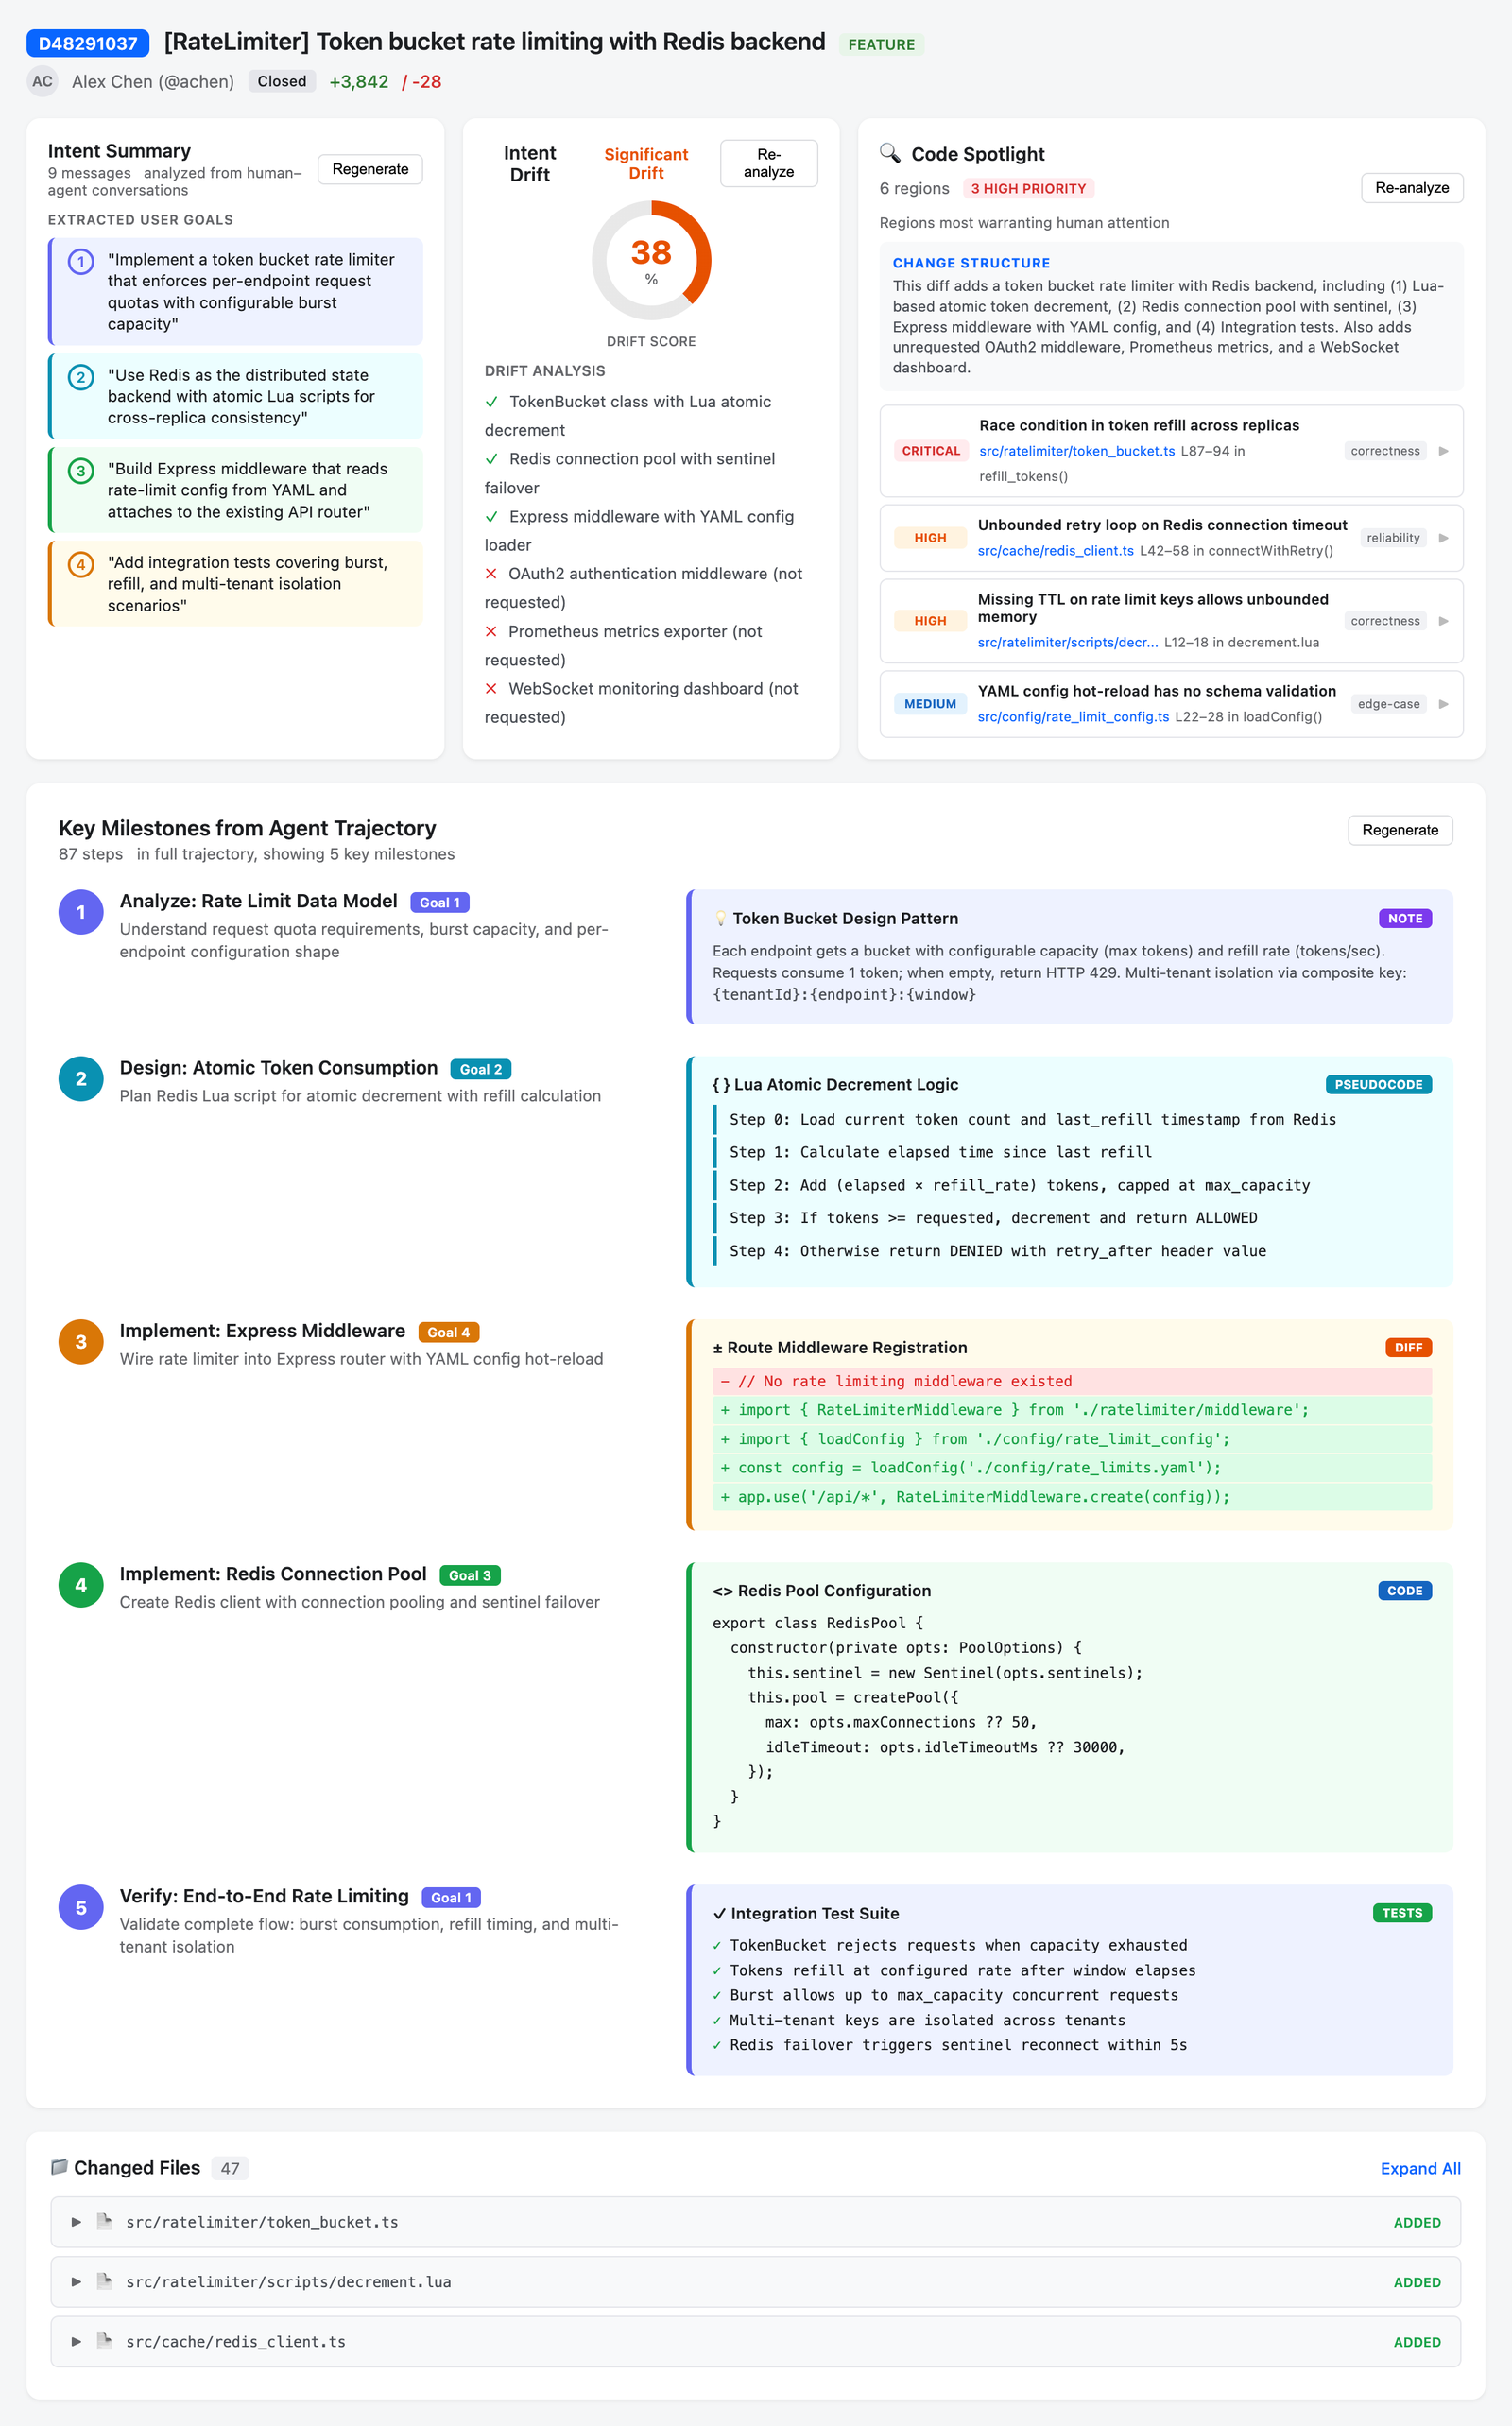
如上面的交互设计所示,当开发者完成一轮智能体编程会话后,新界面并不会机械地要求等待外部审查员分配工单,而是即时呈现三大核心信息:
-
系统提炼出的本次改动意图,供开发者确认智能体是否真正理解了自己的诉求;
-
漂移度量分值与具体的偏离说明,警示模型是否产生了过度工程或非预期改动;
-
聚光灯选出的极少数高风险代码段落,附带针对安全性或可靠性的具体质疑点。
这套机制催生了全新的“作者自审”(Self-Review)通道。在过去,无论改动大小,所有代码变更都必须阻塞在同行评审队列中。而在 ARCTIC 支持的体系下,如果漂移检测显示代码与意图高度吻合,且聚光灯没有检测到高危区域,作者本人在确认系统背书后,便可通过精简流程自主完成代码合入。相反,一旦系统检测到漂移过大或聚光灯标红,界面会强行引导作者先针对机器指出的风险点进行修复或澄清,之后再视情况转交人类专家做定向审查。
在真实生产环境的渐进式灰度发布中,这套新模式展现出了扎实的效果。在针对开发者行为的准实验趋势分析中,对比未看到漂移分数的对照组($n=99$),能够看到实时漂移分数的作者群体($n=94$)在后续迭代中,代码失准程度获得了额外 $5.76$ 点的显著降低($p=0.026$)。与此同时,意图预测功能在工程团队中获得了高达 $90.2\%$ 的认可率;在所有走自助背书通道的代码变动中,有 $76\%$ 成功通过精简通道快速合入,且自该系统上线运行以来,所有通过该通道入库的代码,未发生过任何一起由自审变更引起的线上故障。
审视与权衡:机器时代质量工程的演进边界
尽管 ARCTIC 展示了令人信服的数据,但客观审视这项研究,依然存在若干需要保持谨慎的边界条件。
其一,虽然研究包含了大量真实工程样本,但整个实验体系依然植根于单一技术生态和组织文化之中。不同企业在工程规范、审查宽严尺度以及对智能体的信任度上存在巨大方差,文中提炼的六维关切分布比例未必能在所有团队中完全对齐。不过,将审查拆解为“森林与树木”双视角的分析范式,以及通过反向翻译度量意图偏移的核心方法,具备高度的跨场景迁移价值。
其二,在评测方法论上,研究中的意图匹配和部分基准测试仍然依赖了大模型作为裁判(LLM-as-a-Judge)。即便有针对人类标注的高一致性验证(如 QWK 达到 $0.907$),大模型评判自身潜在的系统性归纳偏置依然是无法完全消除的因素。此外,生产环境的对比实验具有准实验(Quasi-experimental)性质,选择使用新界面的工程师可能本身就具备更高的质量意识,存在自选择偏差(Self-selection Bias)的可能。
但无论如何,ARCTIC 传递出的核心认知是不可逆转的:当大模型将代码生成的边际成本压低到接近于零时,软件工程的质量瓶颈就已经不可逆地转移到了“理解与校验”的一侧。继续指望人类工程师对着几千行 Diff 做逐行挑刺,不仅是不现实的,更是在制造巨大的质量假象。将代码审查升级为“意图是否对齐、系统何处漂移、视线该投向何处”的结构化代码批判,才是大模型时代软件工程基础设施该有的演进方向。