FinDeepIndicator:公式能拿70分终答仅40%,金融Agent卡在哪?
FinDeepIndicator: Benchmarking Deep Research Agents in End-to-End Financial Indicator Construction
在各类关于大语言模型能力的宣传中,金融领域常被视作最具商业价值的试验田之一。无论是快速生成研报摘要,还是张口背出市盈率、资产负债率或杜邦分析法公式,现在的通用大模型几乎表现得像个熟练的金融系毕业生。然而,当真正让模型以深度研究智能体(Deep Research Agent,简称 DR Agent)的形态接入网络,尝试解决一个看似基础的实际业务问题——比如“计算 IBM 在 2019 年到 2021 年期间资产负债率的最小值”时,系统的实际表现往往令人大跌眼镜。
ArXiv URL:https://arxiv.org/abs/2608.00764
这种落差揭示了当前金融基准评测的一大硬伤:绝大多数既有数据集要么直接在上下文里把财报数字“喂”给模型,只考察简单的算术四则运算;要么只对比最终生成的一串数字对不对,对中间的推导路径完全放任自流。当模型最终输出错误时,研究者根本无法判定它究竟是忘了公式、查错了财报科目,还是在最后一步的极值比较中犯了糊涂。
为了打破这种“黑盒式”的表面繁荣,一项名为 FinDeepIndicator 的新研究应运而生。这项研究首次建立了一套覆盖完整工作流的过程级评估框架,全面检验深度研究智能体在真实网络环境下,从零开始端到端构建金融指标的能力。其结论既具启发性又颇为残酷:即使是当今最顶尖的模型系统,在指标公式理解上普遍能够拿到 70% 以上的高分,但一旦进入开放环境的数据收集与实际计算,最终答案的准确率会瞬间暴跌至 40% 左右。模型并非“不懂”金融,而是被卡在了现实金融数据混乱、异构的数据收集泥潭之中。
金融分析的真实痛点:不是“知不知”,而是“能不能做”
在现实世界的量化分析与基本面研究中,金融指标是连接底层杂乱数据与高层决策的核心桥梁。无论是市盈率(P/E)、移动平均线(MA),还是宏观层面的通胀率(CPI)与利差,它们不是天然存在的静态实体,而是需要分析师根据明确逻辑动态构建的派生变量。
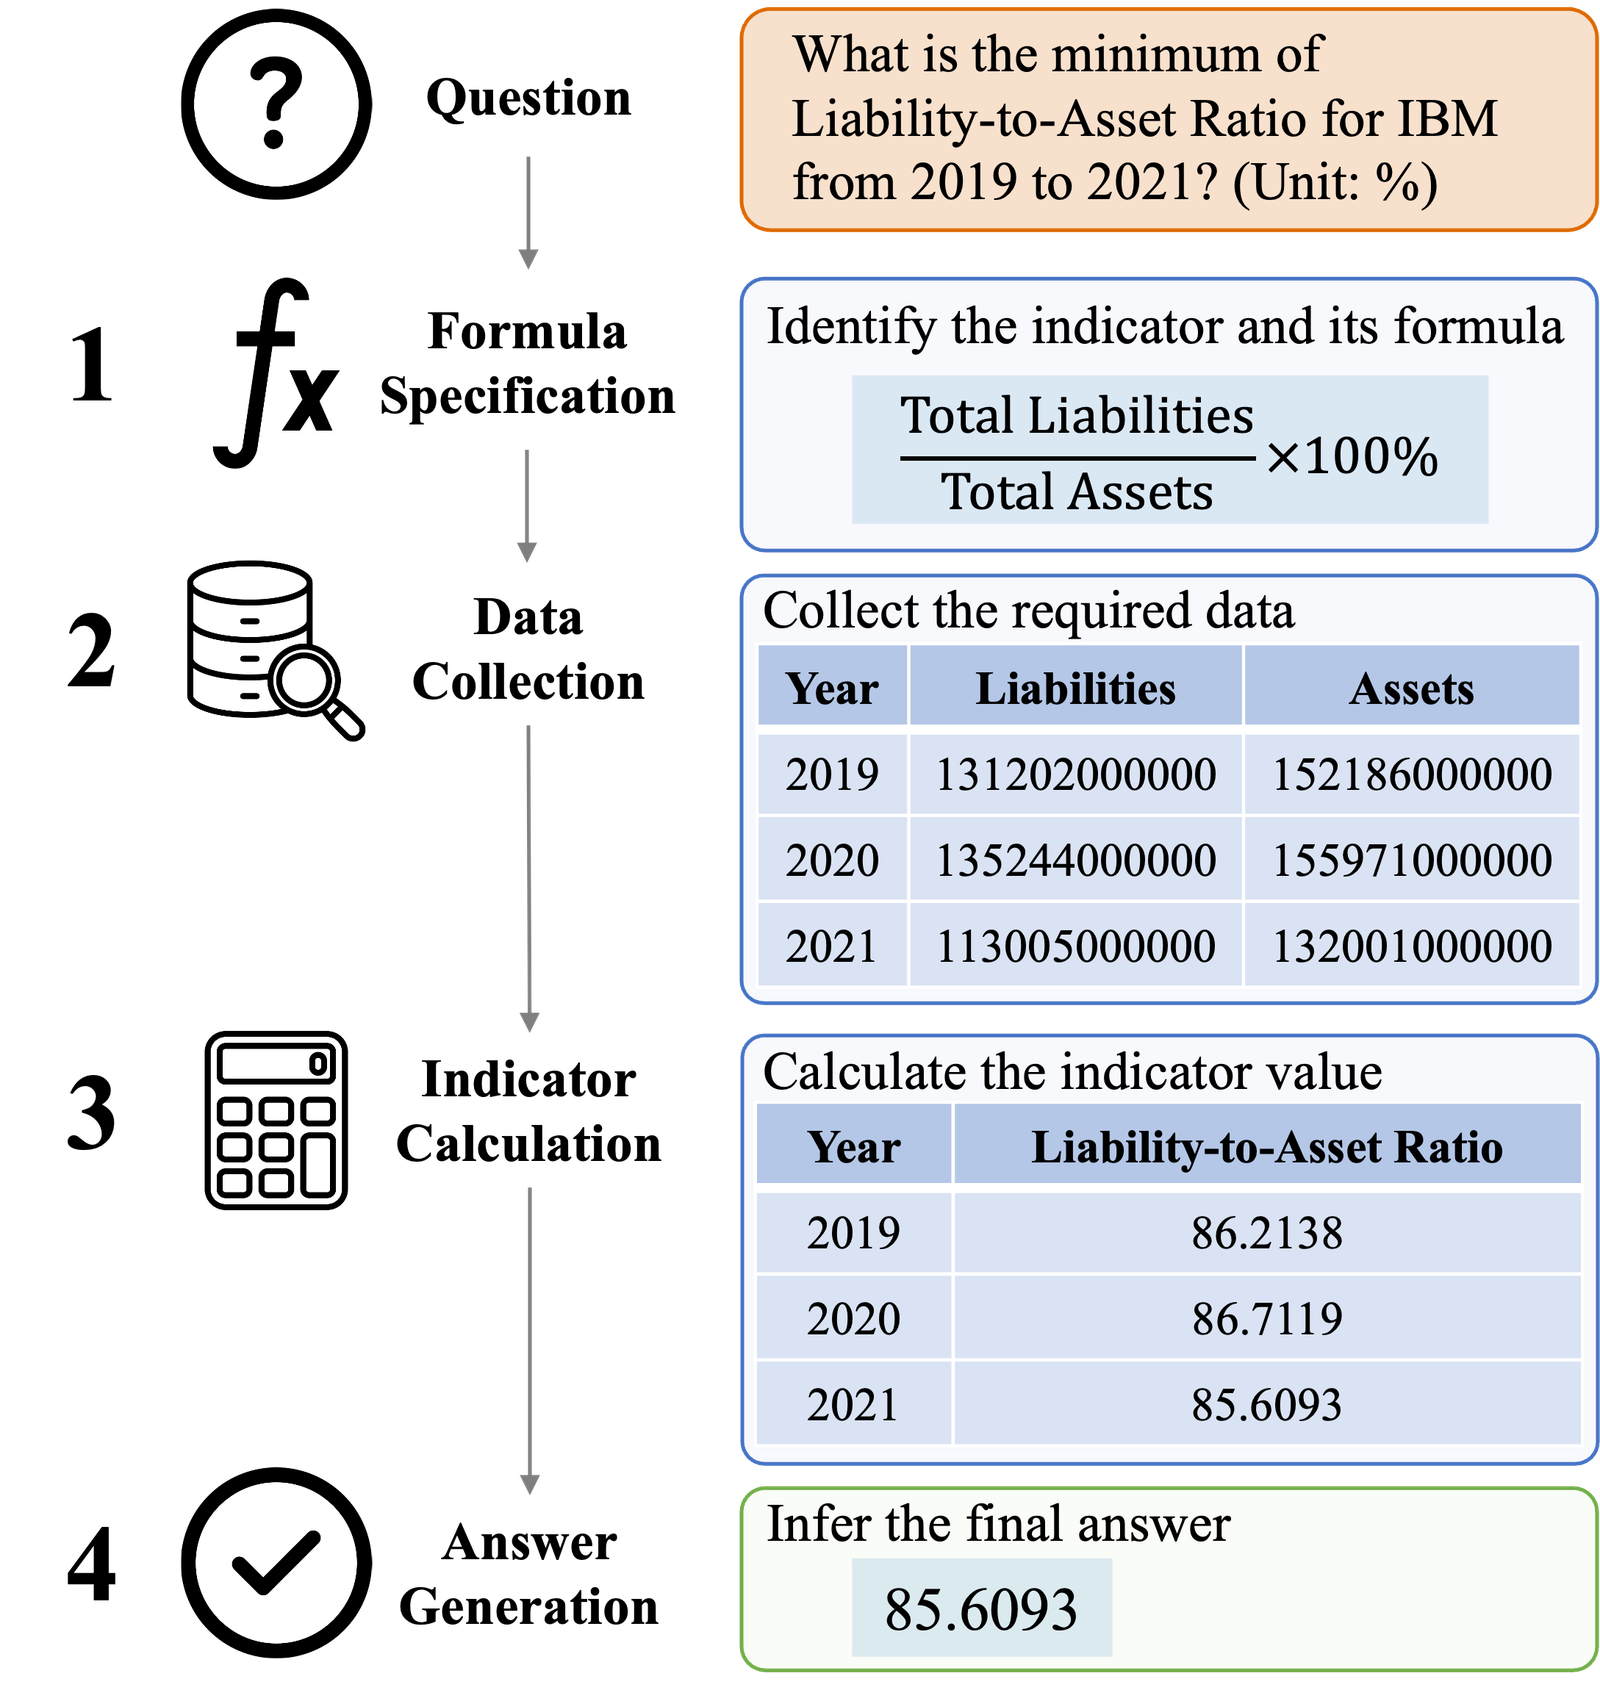
一个典型的端到端指标构建过程绝非单一的问答交互。如上图所示,当用户提出 IBM 历史资产负债率极值的查询时,Agent 必须经历严密的多步链条:首先,它需要在知识库或提示词中定位出“资产负债率”的数学定义,即总负债除以总资产乘以 100%;其次,它必须自主使用搜索引擎或爬虫,在海量财报披露与网页中精准找到 IBM 在 2019、2020 与 2021 各年度对应的总负债与总资产数据,并确保会计口径与币种单位完全对齐;随后,它要逐年执行数值计算得出比率;最后,再在这三组衍生指标中检索并返回最小值。
如果评测只盯着最终输出的一组数字,就很容易把“瞎猫碰上死耗子”视作推理成功,或者把检索失误误诊为逻辑崩溃。更为关键的是,传统评测通常假设所有数据都已经规整地排在上下文窗口中,这种“开卷考试”完全绕过了金融分析中最繁重、最容易出错的“找数据”阶段。FinDeepIndicator 的核心初衷,就是把开卷考变为真实的闭卷实操考,逼迫 Agent 直面开放互联网中的异构噪音。
解构四大阶段:FinDeepIndicator 如何拆穿“幻觉”
为了精确锁定 Agent 的能力边界,FinDeepIndicator 提出了一个过程级(Process-level)评估体系,将指标构建切分为四个清晰的生命周期阶段:
-
公式规范化(Formula Specification):评估模型是否能准确理解自然语言指令背后的金融概念,并转化为标准的数学公式。
-
数据收集(Data Collection):检验 Agent 能否自主在公开网络中检索到正确时段、正确实体、正确会计科目的原始数值。
-
指标计算(Indicator Calculation):在容差机制(Tolerance-aware)的约束下,评估模型对收集到的数值执行数学运算的精准度,包容合理的舍入误差但严格拦截数量级偏差。
-
答案生成(Answer Generation):考察模型在多时间步、多实体的衍生结果中,能否正确完成排序、极值筛选、同比环比等聚合逻辑。
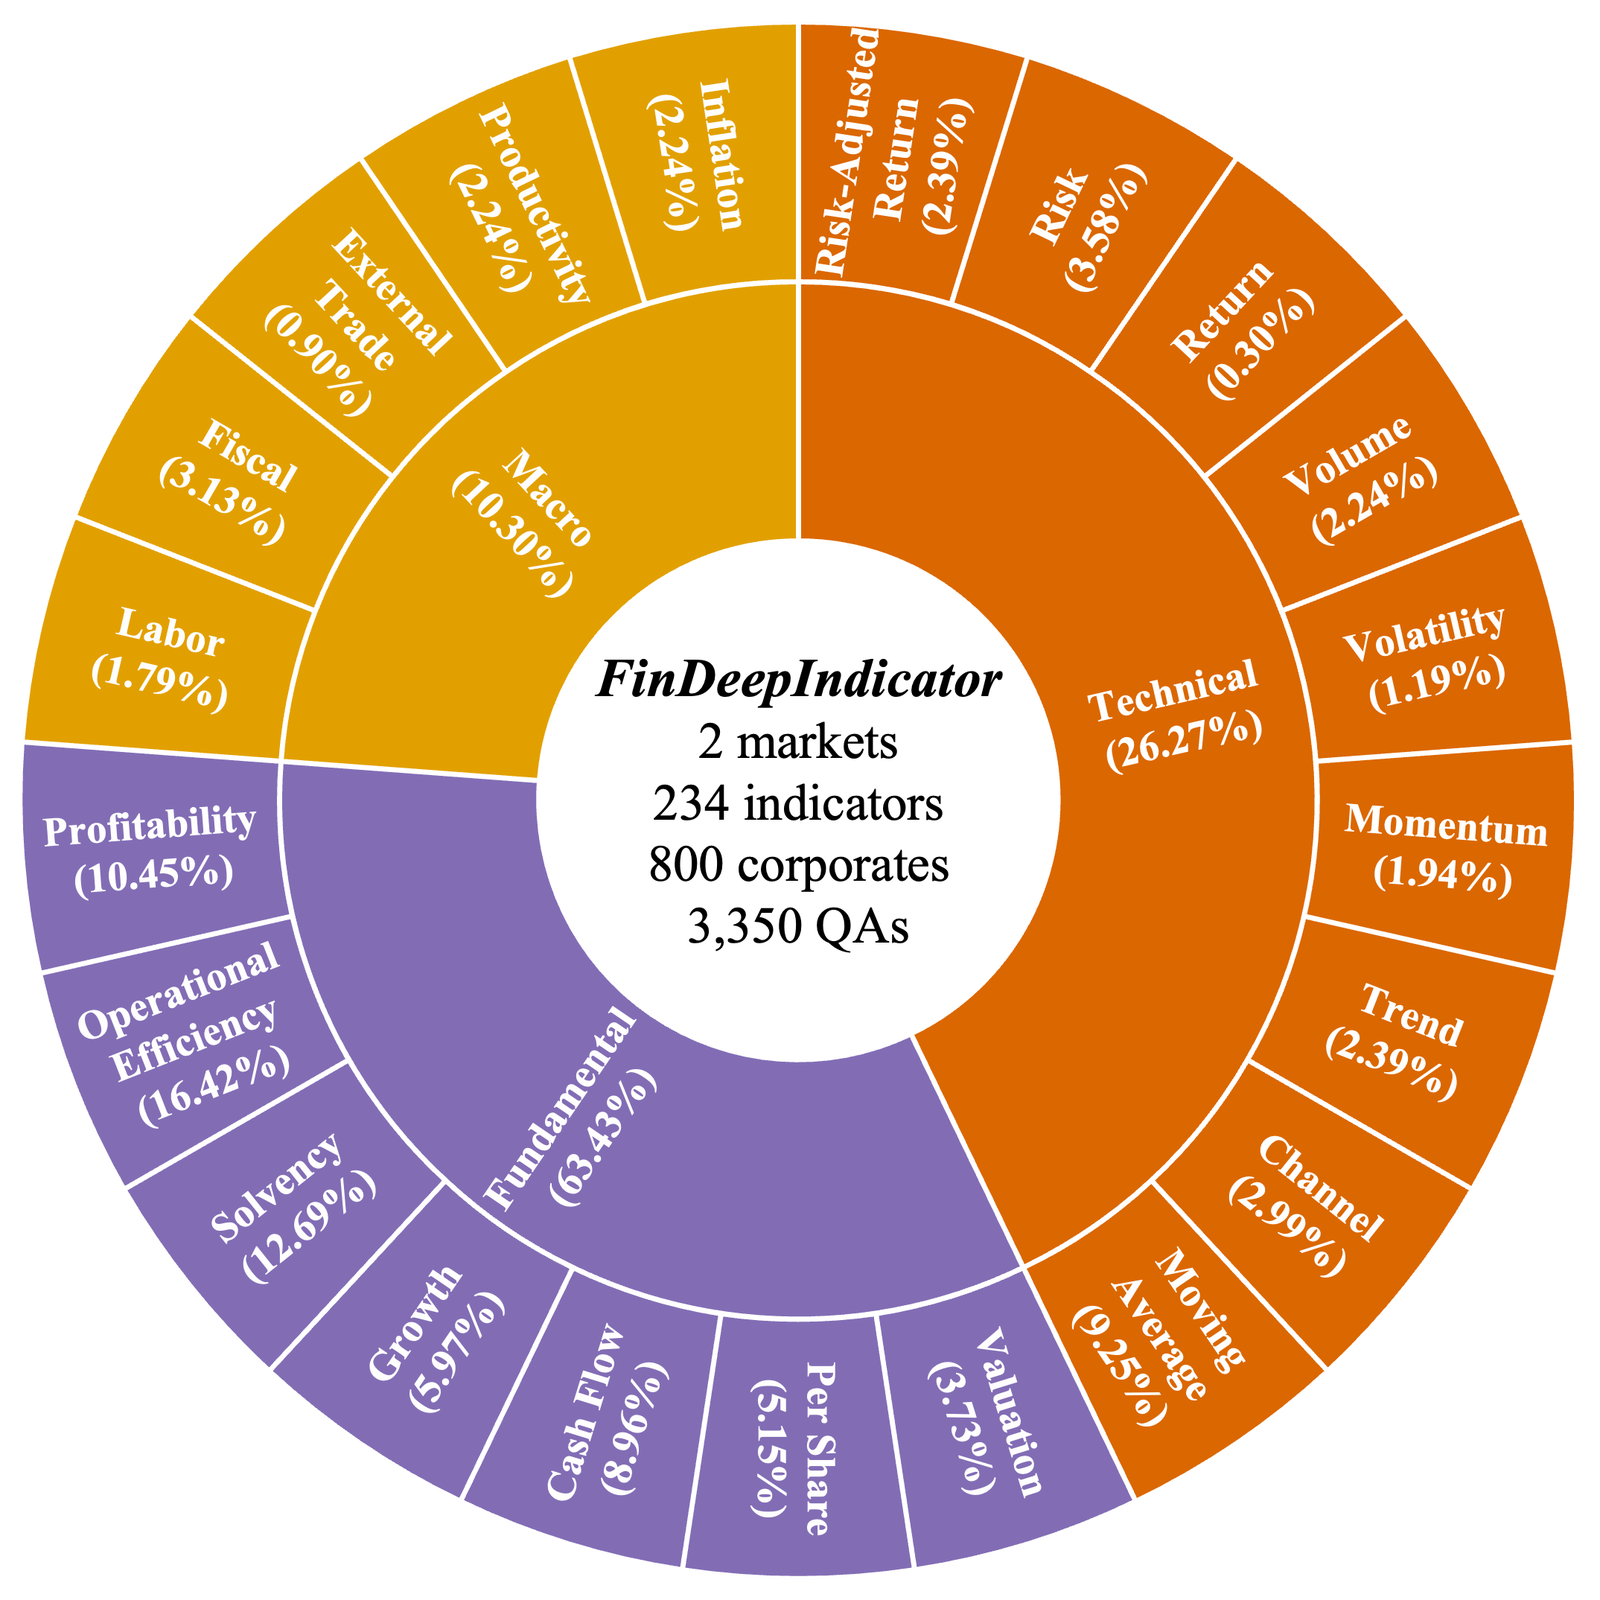
为了支撑这一整套细粒度拆解,研究团队梳理出了一套极其详尽的金融指标本体体系。如上图所示,该基准划分为基本面(Fundamental)、技术面(Technical)和宏观经济(Macroeconomic)三大主干,进一步下设 21 个精细子类别,共计收录 234 个标准化金融指标。这其中不仅包含了流动性、偿债能力、盈利能力等传统财务指标,还涵盖了动量、波动率以及涉及对外贸易、财政收支和劳动力市场的复杂宏观时间序列。
对于每一个指标,研究团队均人工固化了其标准名称、计算公式、所需原始输入以及可执行的 Python 校验脚本。这种高密度的元数据结构,使得评测可以在任何一个中间节点对模型的回答进行自动提取与事实核查,彻底告别了依靠模糊文本打分的弊端。
规模与质量:跨越中美双市场与十年的严苛检验
支撑一个高可信度基准的基石在于数据本身的厚度。FinDeepIndicator 并非几百道手工拼凑题目的玩具集,而是构建在大规模真实市场数据之上的工程化系统。
整个基准总计包含 3350 个精选问答对,覆盖了美国与中国两大主流金融市场,时间跨度长达 10 年,囊括了 800 家具有代表性的上市公司。为了确保问题的语言多样性与逻辑复杂性,研究设计了从单跳直接计算到多跳时序聚合的 170 套问答模板,并划分为 Easy、Medium 与 Hard 三种递进难度。
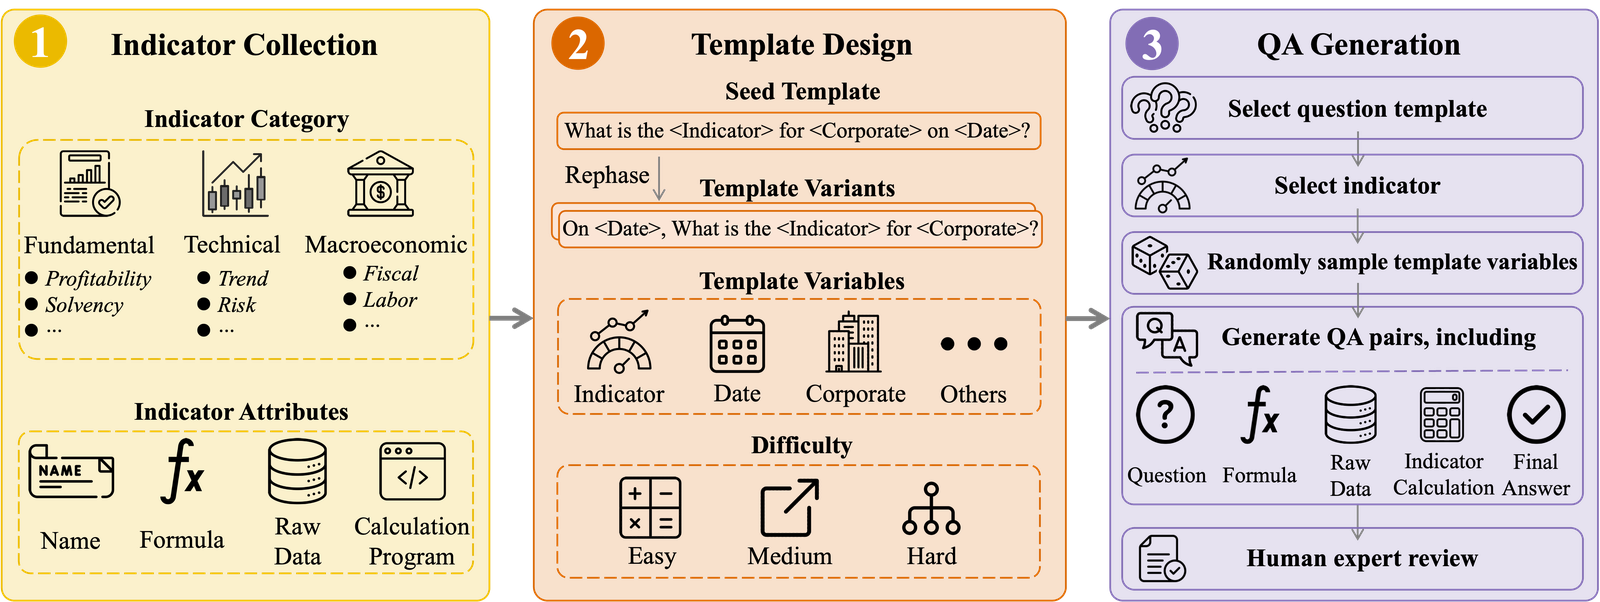
如上图流水线所示,整个生产流程从底层的元数据沉淀、模板设计,一路推进至变量实例化抽样。在生成每道问题时,系统会把公司代码、目标年份、计算约束等参数注入模板,并同步派生出该题目的标准中间过程与真值结果。为了防止程序自动化生成的样本出现逻辑瑕疵或网页失效导致的“无解题”,研究团队引入了专家抽样审查机制,对数据可用性、公式严谨性与计算链路执行双重核验,确保基准内部逻辑自洽。
实验揭秘:从 70% 到 40% 的断崖式溃败
研究团队对业界主流的前沿大模型进行了系统化测试,评估对象涵盖了搭载 Google Search 搜索能力的单体大语言模型(如 Qwen3.6-Max、Claude-Sonnet-4.6、Gemini-3-Flash、DeepSeek-V4-Flash、GPT-5 系列),以及在搜索表现最优模型上构建的多步骤深度研究智能体(DR Agents)。
实验得出的第一个震慑性结论,便是前文提到的“断崖式下跌”。
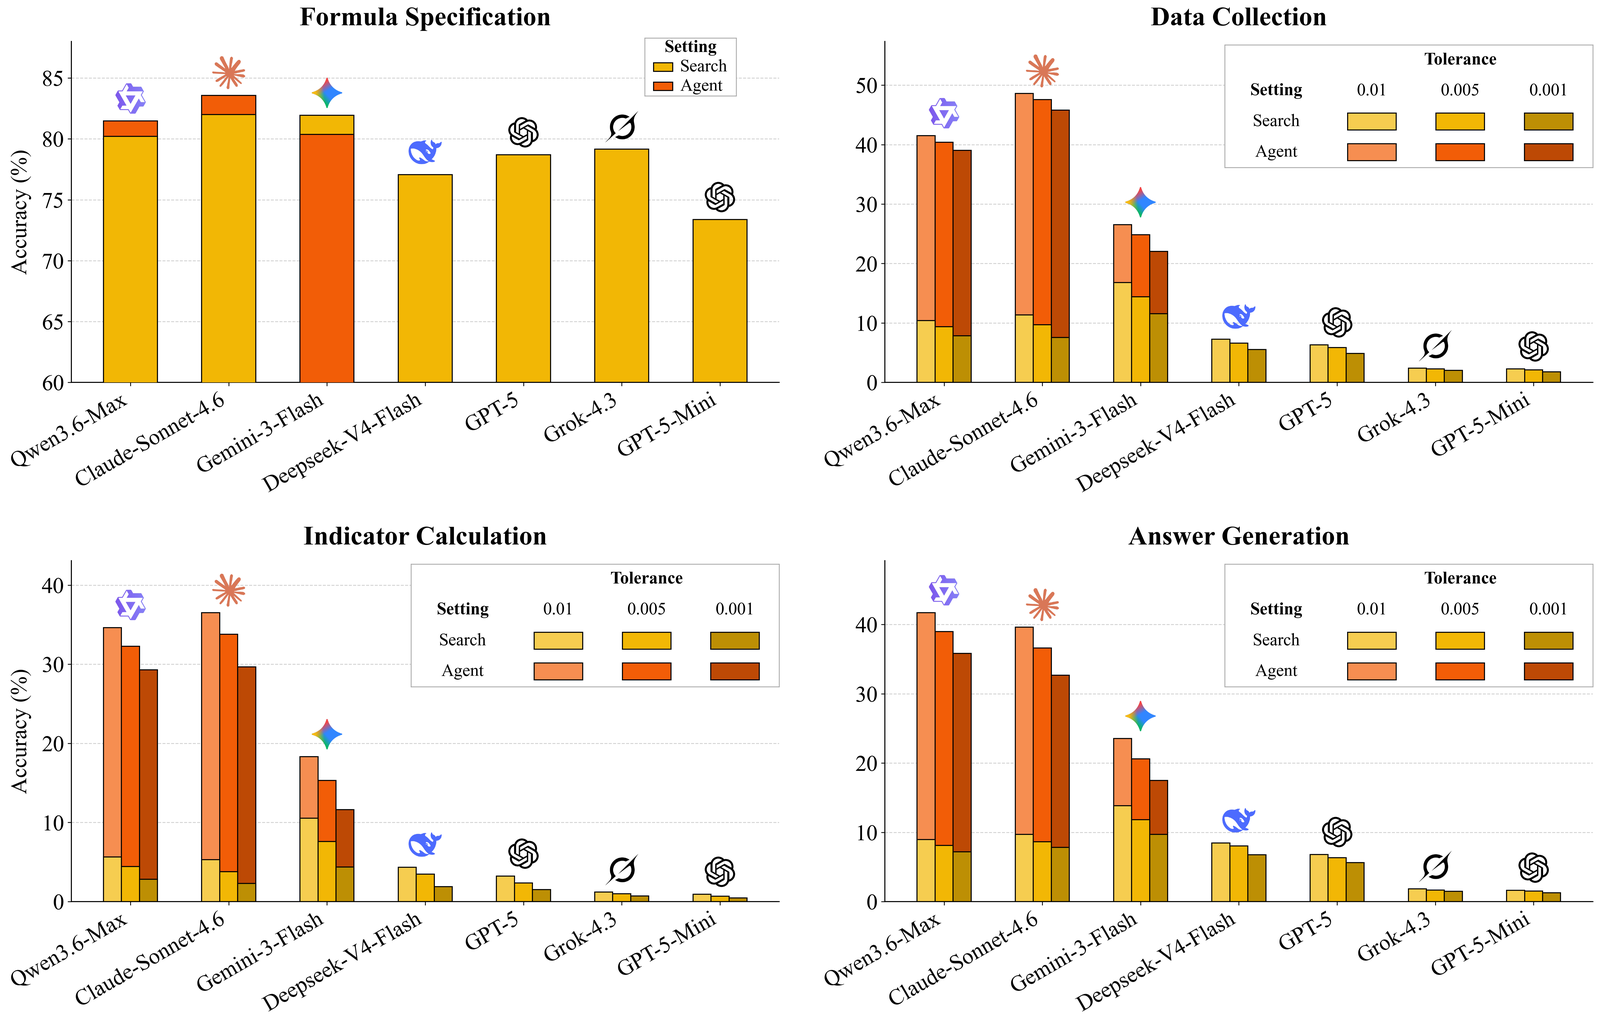
观察上图可以清晰地看到:绝大多数先进系统在公式规范化(Formula Specification)阶段都有着不俗的底子,准确率轻松跨越 70%,甚至部分模型逼近 80%。这说明模型在预训练阶段已经充分吞吐了金融教科书与百科全书,对“什么是资产回报率”“布林带怎么算”了然于胸。
然而,一旦行进到数据收集(Data Collection)环节,曲线陡然坠落,平均性能跌幅高达 40 个百分点左右。即便赋予了 Agent 长期规划与自主迭代搜索的权限,最强的深度研究智能体在最终答案生成(Answer Generation)上的准确率也仅在 40% 上下徘徊,单体搜索模型的表现则更为低迷。这一断层明确地证实:阻碍大模型成为合格金融分析助手的核心死穴,根本不是公式推理能力不足,而是它在浩瀚的互联网上根本抓不准、对不齐底层的原始数据。
中美市场与任务难度的双重拷问
细分维度的实验展现出更多耐人寻味的现象。在针对中美两个独立市场的横向对比中,不同模型显露出了截然不同的适应性。
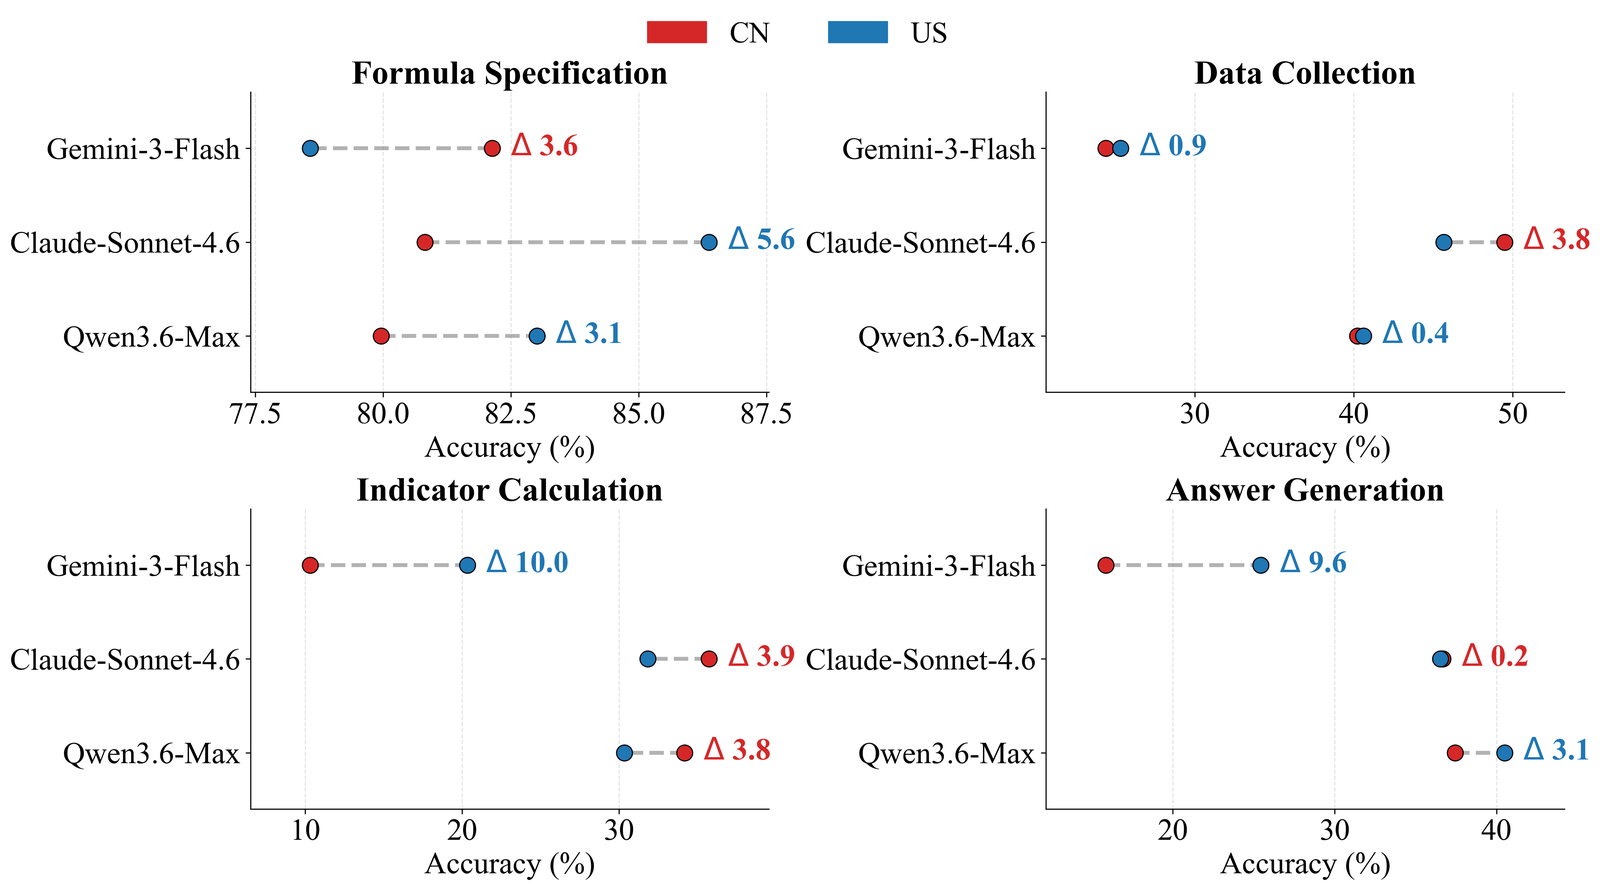
数据显示,像 Gemini-3-Flash 这类模型在美股市场的表现明显优于中国市场,在最终答案准确率上有超过 9.6% 的落差;而 Claude-Sonnet-4.6 则在中国市场展现出极强的韧性,在数据收集与中间计算环节反超美股表现。这种跨市场能力的撕裂,深刻反映了底层训练数据的地域分布倾斜,以及两大市场在公开财报格式、披露渠道结构和文本命名惯例上的本质差异。美国 SEC 的 EDGAR 系统披露高度标准化,而中文网络环境中的财报数据源往往分散在交易所官网、行业门户或第三方财经媒体中,数据抓取与口径对齐的难度截然不同。
而在面对不同任务难度(Easy、Medium、Hard)时,模型之间的耐压特质也完全不同。
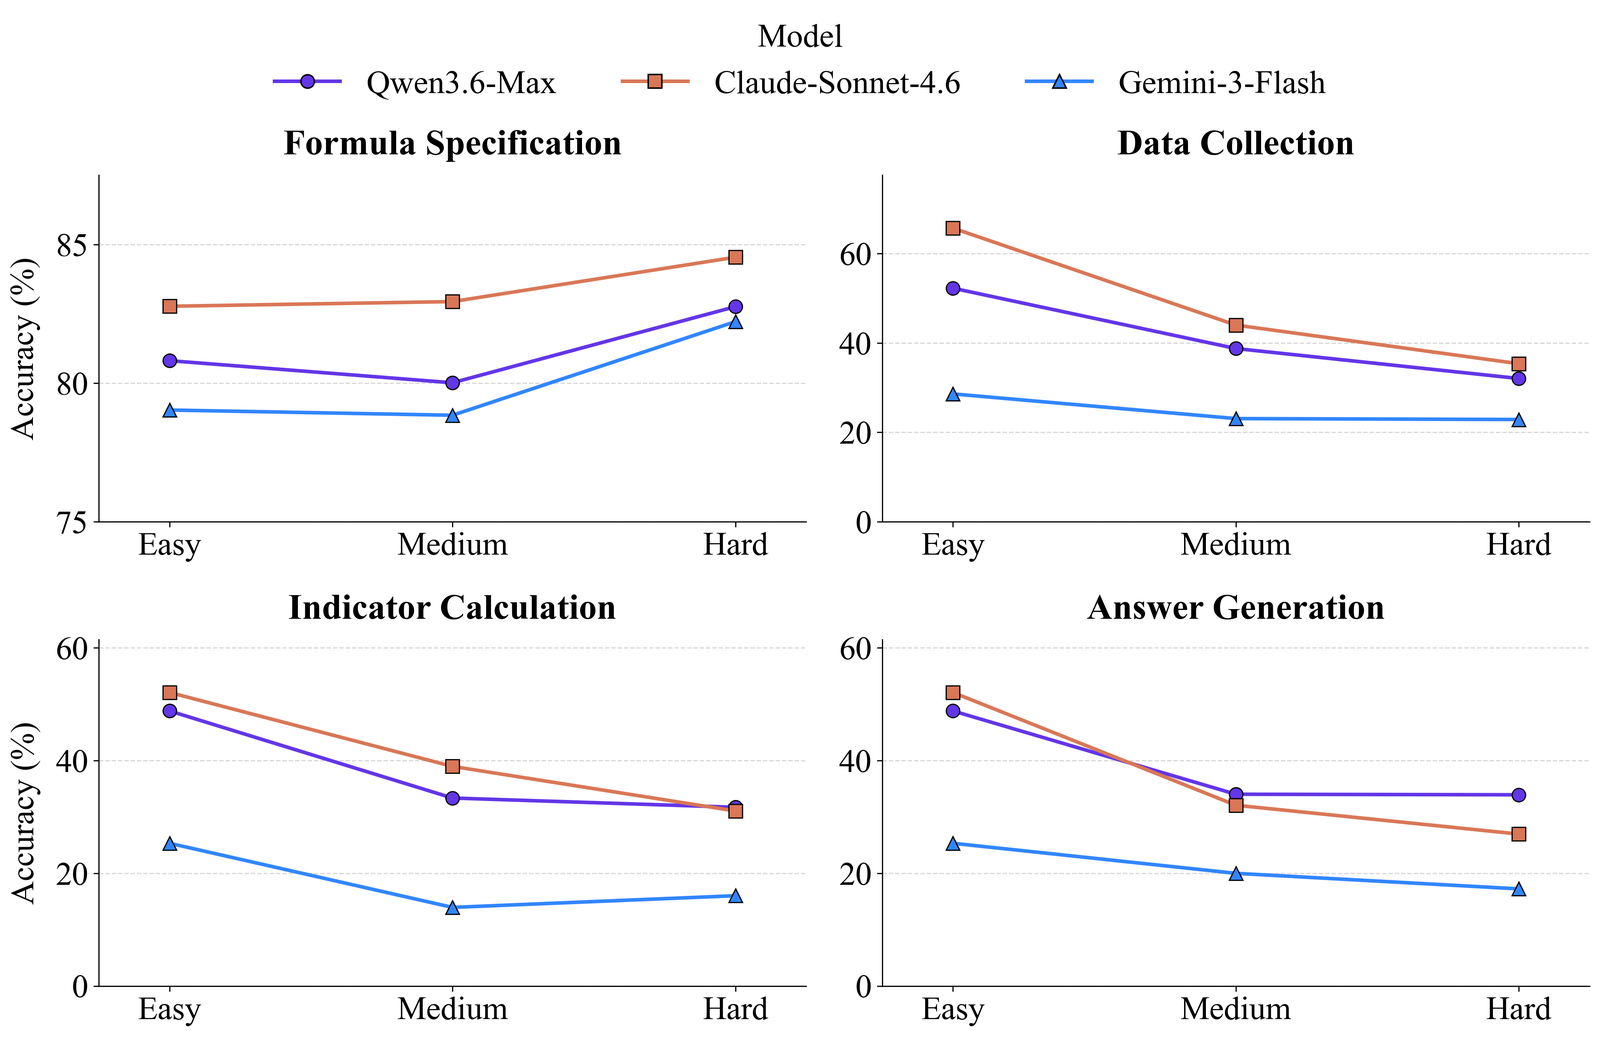
直觉上,随着从直接计算演变为跨年度极值比较和多跳过滤,所有模型的成绩都应当持续走低。实验中 Claude-Sonnet-4.6 确实呈现出这种阶梯式下滑态势,在简单任务上它凭借精细推理拔得头筹,但在复杂链条下容易疲劳出错;而 Qwen3.6-Max 展现出了令人意外的稳健度,在从 Medium 到 Hard 的难度递增过程中,其最终答案准确率几乎未见衰减,最终在最艰难的硬核测试集上逆势登顶。这证明当任务涉及长上下文与多级临时状态缓存时,智能体的任务规划与状态维持能力比单步精细度更为致命。
宏观经济数据:所有大模型的共同“滑铁卢”
如果说基本面和技术面指标尚且有据可循,那么宏观经济指标则成为了所有受试模型的集体梦魇。
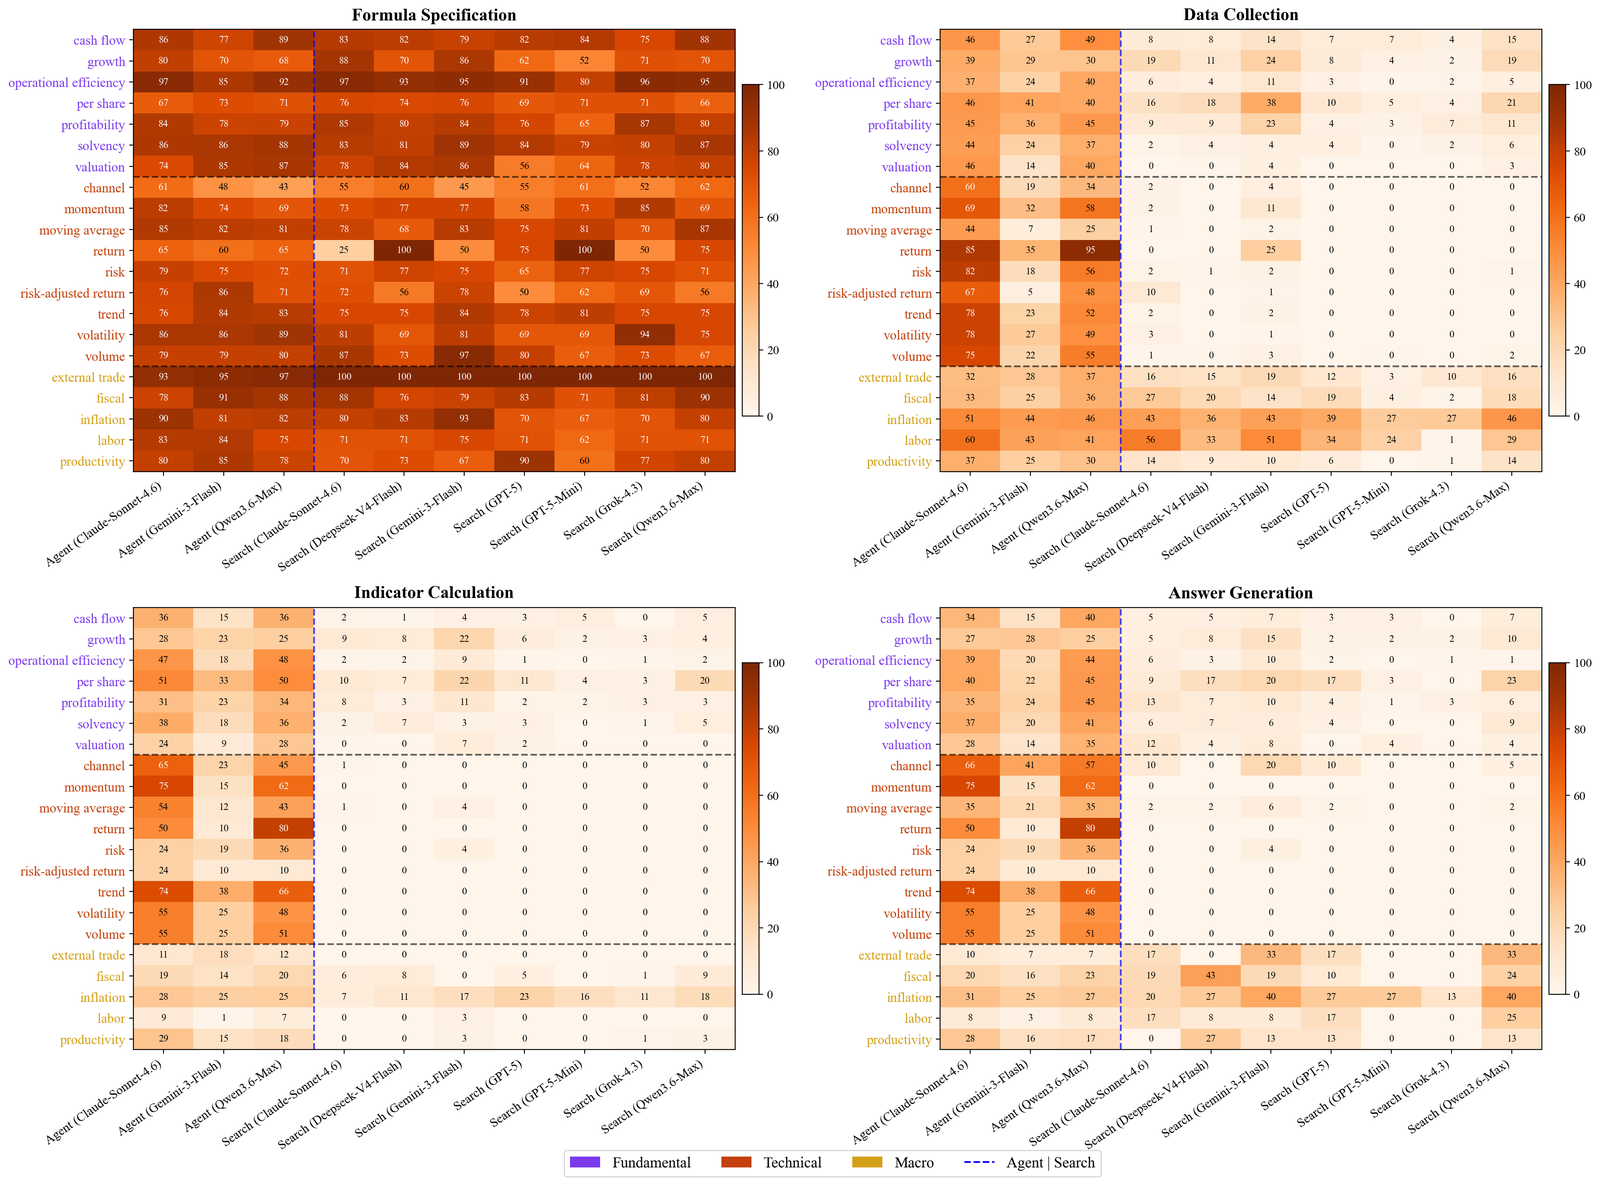
在 21 个子类别的全景透视中,宏观经济分类下的“对外贸易(External Trade)”“财政(Fiscal)”“劳动力(Labor)”与“生产力(Productivity)”表现惨烈,绝大部分模型在这些类目下的最终准确率跌破了 30%。
宏观指标之所以成为重灾区,主要在于其高度动态且混乱的统计属性。与上市公司定期披露的 10-K 或季报不同,宏观经济数据涉及不同的统计局、央行以及多边国际组织,其发布频率各异(周频、月频、季频、年频),季节性调整口径频出,且经常在初值发布后经历数轮历史数据修正。当 Agent 带着模糊的时间戳在网络中抓取 CPI 或进出口数据时,极易将未季调数据与季调数据混淆,或者误将初步核算值与最终修正值拼凑在同一条公式中,最终导致整个计算全盘皆输。
把数据喂到嘴边会怎样?一项关键消融实验
为了进一步坐实“数据收集才是核心短板”这一假设,研究团队设计了一组非常精彩的消融实验:如果人为剥离网络搜索过程,将正确的原始数据直接作为背景信息喂进 Prompt 中,Agent 的表现会发生怎样的形变?
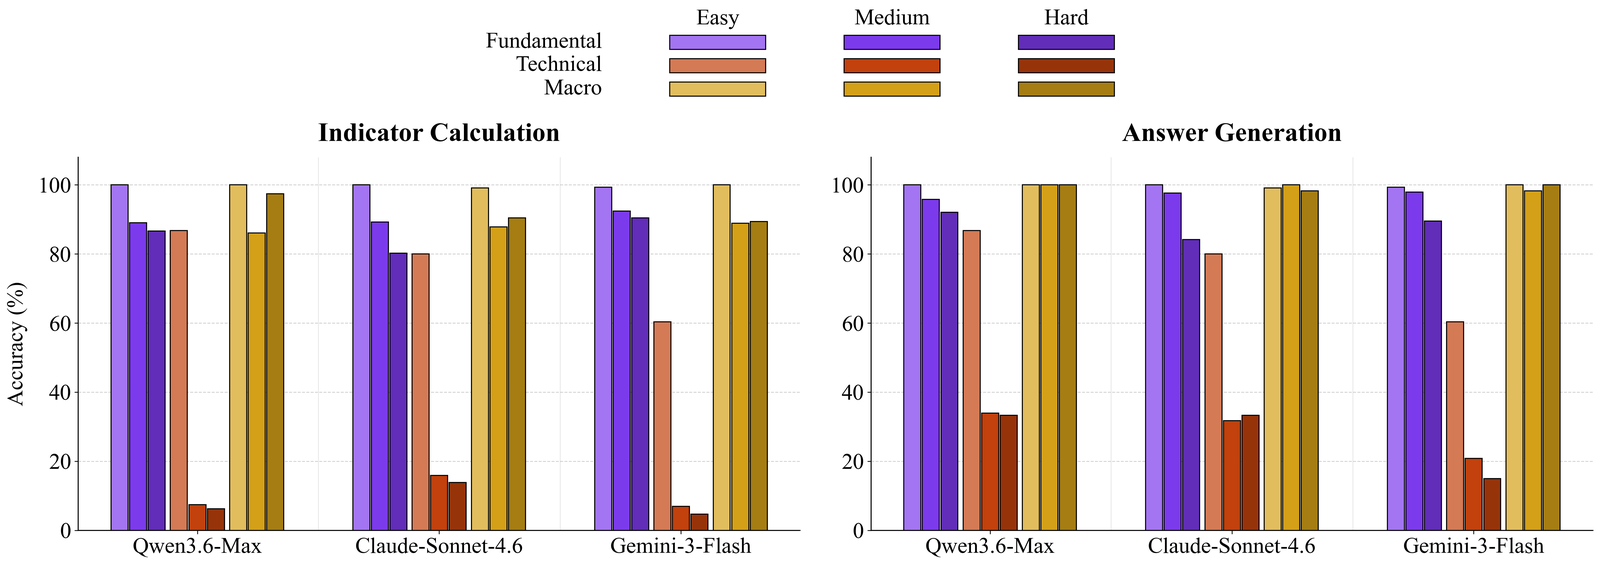
结果令人深思。当摆脱了检索枷锁后,模型的计算准确度整体大幅反弹,但在不同指标类别之间展现出了极具分化的走势:
在宏观经济指标上,无论题目难度如何提升,模型的性能曲线几乎维持平稳。这印证了一个关键洞察:宏观指标的算术逻辑通常非常简短(如计算差额、比率或同比),宏观题目的核心难关 100% 集中在寻找数据源上,一旦数据就位,模型不会在计算上犯难。
而在技术指标(Technical Indicators)上,局面发生了反转:即便原始行情序列完全摆在面前,随着任务难度增加,模型的准确率依然发生了极为剧烈的滑坡。这是因为技术指标涉及大量跨周期的滚动窗口计算、指数平滑加权以及多重极值判断,极度依赖严格的代码执行或连续数理推导。大模型在处理这类纯长程数值运算时,注意力漂移和累积舍入误差会再次成为新的绊脚石。
在失败案例的统计中,除了检索漂移和数值算术错误外,研究团队还捕捉到了约 1.0% 的纯逻辑溃败。例如,Agent 历经千辛万苦算出了三年的指标数值,但在最后一步却忽视了指令中“统计指标大于零的年份数量”的要求,反而直接把最后一年的数值当作答案返回。这说明长链条交互带来的目标遗忘(Goal Drift),仍然是自主智能体底层不可忽视的系统隐患。
对未来金融 AI 的启示:走出象牙塔的深度研究
FinDeepIndicator 的出现,给当前盲目乐观的“AI 金融分析师”叙事泼了一盆清醒的冷水。从这项扎实的基准研究中,业界与学术界可以提炼出几项至关重要的技术演进线索:
通用搜索(Web Search)无法胜任专业级金融投研。靠通用搜索引擎抓取网页碎片,对于严谨的金融指标计算来说不仅效率低下,而且极易引入致命的口径偏差。未来的金融级 Deep Research Agent 必须深度绑定结构化的金融专业终端(如彭博、Wind 等 API)以及具备高保真度表格解析能力的专用文档解析器。Agent 不仅要学会“搜关键词”,更要学会校验“会计科目附注”与“数据发布版本”。
代码解释器(Code Interpreter)应成为金融 Agent 的强制标配。消融实验已经表明,大语言模型哪怕仅依赖自身注意力机制来做多步浮点数运算与时序滑动统计,准确率依旧会随链条拉长而崩塌。指标计算的唯一可靠路径,是让大模型专职负责“公式推导”与“Python 脚本编写”,将具体的数值代入与矩阵运算彻底交由确定性的计算沙盒执行。
评估必须走向“过程级”,拒绝结果欺骗。如果继续沿用过去那种只比对最终数字的简单评测集,模型提供商便有充分的动机通过 Prompt 工程在最终格式上走捷径,从而掩盖中间链条中严重的幻觉与错误归因。只有像 FinDeepIndicator 一样,对公式、数据、分步计算与最终决策进行四段式全链路解剖,才能真正倒逼模型在长程任务规划与工具调用上建立起可验证的可靠性。
金融领域的决策成本极高,容错率几乎为零。大模型要真正从“金融唠嗑工具”蜕变为“金融生产力工具”,就必须跨过从概念背诵到严密执行这道幽深的鸿沟。FinDeepIndicator 所刻画的,正是这道鸿沟的具体深度与真实轮廓。