GESTO:以人为中心的时空记忆网络,破解动态场景下的具身推理难题
GESTO: Human-Centric Spatio-Temporal Memory for Reasoning in Dynamic Scenes
让服务机器人真正走进家庭或办公环境,仅仅让它“看清眼前有什么”是远远不够的。当用户抛出一个自然的生活疑问——“今天早上有人用哪个马克杯喝了咖啡?”“我倒完水后把水壶搁哪儿了?”或者“洗碗机里的盘子洗过了吗?”——机器人面对的便不再是简单的静态物体识别,而是需要对动态时空环境进行回溯推理。
ArXiv URL:https://arxiv.org/abs/2608.10886v1
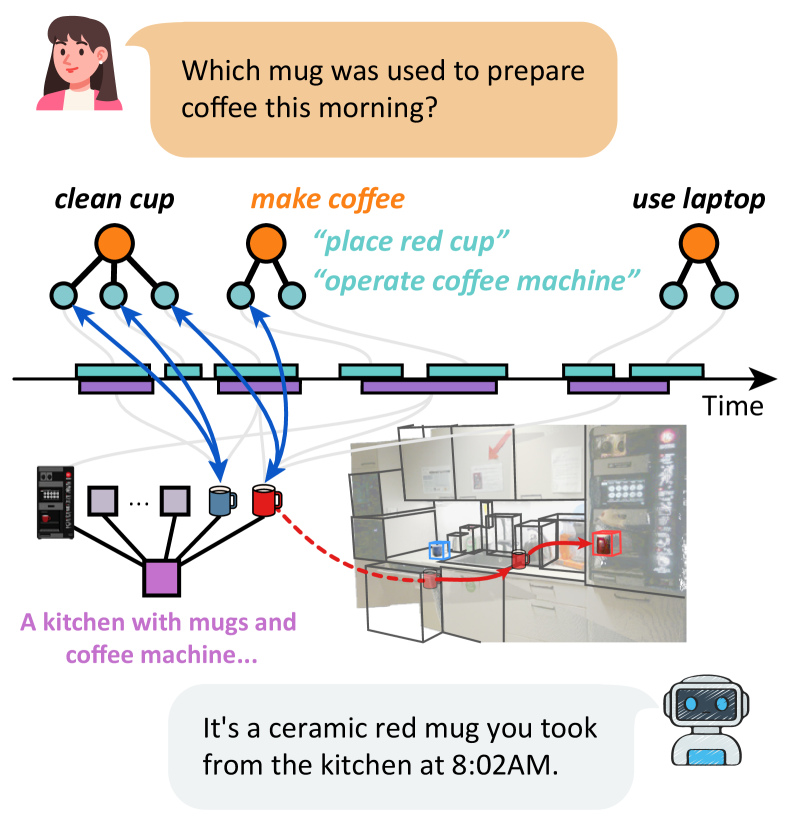
要回答这类问题,机器人必须建立一套兼具三维空间结构与时间行为轨迹的长期记忆。现有的 3D 或 4D 场景图(Scene Graphs)虽然能追踪物体的几何位置和时间演变,但缺乏对“人类行为结构”的抽象理解;而在计算机视觉的行为识别领域,大多数动作表征要么完全脱离持久的三维物理世界,要么极度依赖人工标注好的动作起止时间点和预绑定的物体信息。
为了打破空间几何与人类动态行为之间的隔阂,来自 Google Research、马普所(IMPRS-IS)、慕尼黑工大(TUM)、KTH 及斯图加特大学的研究团队联合提出了 GESTO(Grounded Event and Spatio-Temporal memOry)。该系统通过构建双层人类活动层级,将其精准锚定在底层的 4D 场景图上,实现了完全无外部干预的“自下而上”时空记忆自动构建与智能问答。
机器人时空记忆的脱节困境
近几年,3D 场景图作为具身智能的空间记忆载体取得了长足进展。从最初的 Hydra 实时分层建图,到近期结合大模型的开集语义与 4D 动态追踪方案(如 DAAAM 或 Khronos),机器人已经能够记录某个物体“在什么时间出现在什么坐标”。但这些方案在本质上仍然是“以物体为中心”的被动记录:系统记录了杯子在上午 9 点移动到了茶几上,却不知道这一移动是因为“有人在准备早餐”,还是仅仅被保洁人员顺手挪开。
与之相对的人类活动识别与情境图谱(如 Event-Grounding Graphs, EGG),虽然意识到了将事件与物理空间绑定的重要性,但在系统落地时往往存在两个致命短板:
其一,事件结构扁平,缺乏从“拿取杯子”这类原子级动作(Atomic Interaction)向“煮咖啡”这类目标驱动事件(Goal-Driven Event)的层级抽象;
其二,严重依赖“作弊上帝视角”,往往预先假定传感器流中已经切分好了动作发生的起止时间戳,并且人工指定了参与该动作的具体物体 ID。
一旦剥离这些人造先验,要求机器人在连续的 RGB-D 传感器流中自主完成从像素级感知到高层抽象推理的全流程,现有架构就会迅速失效。GESTO 正是为了填补这一关键空白而生。
耦合双层层级:GESTO 的表征哲学
GESTO 的核心思想,是将动态场景在数学上统一表示为一个耦合图结构 $\mathcal{G}^{+} = (\mathcal{G}{\mathrm{S}}, \mathcal{G}{\mathrm{A}}, \mathcal{L})$。这套表征包含了两个平行的层级系统,以及穿梭在二者之间的动态锚定链。
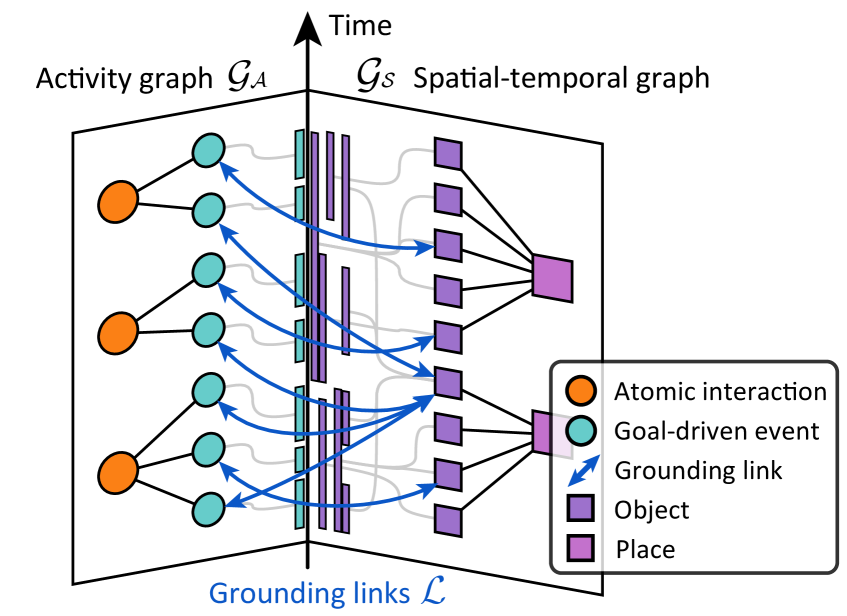
如上图所示,右侧平面是时空场景图 $\mathcal{G}_{\mathrm{S}}$。它自底向上由持久化的 3D 物体节点构成,并汇聚到高层的房间/区域等空间地点节点中。
左侧平面则是全新的活动图谱 $\mathcal{G}_{\mathrm{A}}$。它由两级行为构成:底层是带精确时间戳的“原子交互”(如“握住杯柄”“操作按键”),顶层则是语义连贯的“目标驱动事件”(如“冲泡咖啡”“清洗餐具”)。
而连接这两个独立维度的桥梁,就是接地链接 $\mathcal{L}$(Grounding Links)。链接在最细粒度上将原子交互与底层的持久物体节点绑定,使得上层的抽象事件能够自然继承物理空间与坐标,同时让物理世界的物体具备了能够被活动行为反向索引的元数据。
全自动构建:从原子感知到情境消歧
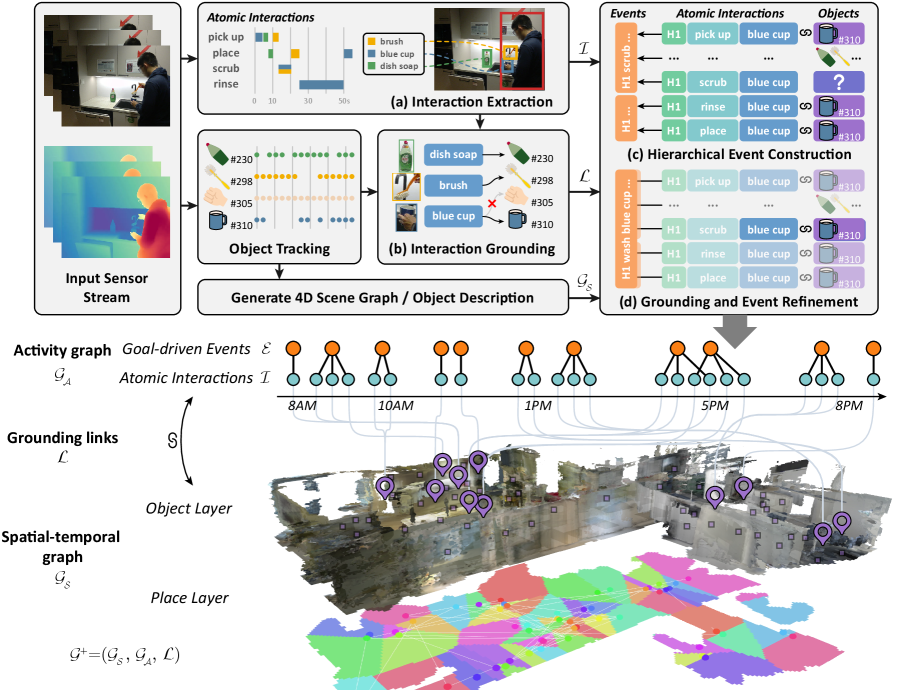
面对机器人搭载的连续 RGB-D 视频流,GESTO 的构建流程分为交互抽取、事件聚合与双向精炼三个关键阶段。
1. 原子交互提取与初步几何绑定
系统在检测到视野内有人类活动时,会自动将长流切分成 15 秒的连续视频切片,并利用视觉语言大模型(实验中采用 Cosmos-Reason2)提取其中的原子人机交互行为。针对每个检测到的动作,模型输出所操纵物体的描述(如“蓝色马克杯”)以及交互窗口内的逐帧边界框。随后,结合 FastSAM 生成的物体分割掩码与场景图中的三维物体投影,通过掩码交并比(mIoU)与语义相似度过滤,生成初始的几何与语义关联 $\mathcal{L}^{(0)}$。
2. 大语言模型驱动的目标驱动事件归纳
仅有零散的动作碎片不足以支撑复杂的长程因果推理。GESTO 利用大语言模型将零散的交互聚类为具有统一意图的高层事件 $\epsilon = (\mathcal{I}{\epsilon}, s{\epsilon})$。例如,“拿杯子”、“装咖啡豆”、“启动咖啡机”被统一归纳为“准备咖啡”。聚类严格遵循人类行为认知规律:保持颗粒度均衡(不至于窄至单次抓取,也不至于泛化到“在厨房做事”这一级别),区分同类但外观不同的物体,并在时间维度上对交互序列形成连续的时序划分。
3. 关联与事件的双向交互精炼(Refinement)
这是 GESTO 算法中最具启发性的设计。现实场景中,传感器的遮挡、视角盲区常常导致初步的几何匹配失败,产生大量未能成功锚定物体的孤立动作。然而,活动语境本身蕴含着巨大的消歧线索:如果一个人在一连串“准备咖啡”的明确交互中伸手去拿一个看不清全貌的柱状物,事件的高层上下文就能反推该物体极大概率就是咖啡杯。
GESTO 通过交替精炼公式:
\[\mathcal{L}^{(1)} = \mathcal{R}_{\mathcal{L}}\left(\mathcal{L}^{(0)}; \mathcal{E}^{(0)}\right), \quad \mathcal{E}^{(1)} = \mathcal{R}_{\mathcal{E}}\left(\mathcal{E}^{(0)}; \mathcal{L}^{(1)}\right)\]利用初始事件集 $\mathcal{E}^{(0)}$ 提供的上下文,重新判定并补全原本未匹配成功的几何链接,形成扩展链接 $\mathcal{L}^{(1)} = \mathcal{L}^{(0)} \cup \mathcal{L}_{\mathrm{inferred}}^{(1)}$;随后根据补全的物理依据再次微调事件边界。这一步打通了高层认知对底层感知的逆向反馈路径。
4. 关系感知工具调用智能体
构建完成的耦合图谱 $\mathcal{G}^{+}$ 最终对接给一个关系感知(Relation-Aware)的具身问答智能体。团队扩展了工具调用接口,让智能体不仅能执行传统的物体坐标检索,还能顺着拓扑关系进行跨域穿梭:沿空间轴查询某区域内曾发生过的所有事件,或沿事件轴调取某次任务所触碰过的一系列物品实体与起止时间,从而实现精准溯源。
实验评测:剥离外部先验后的硬核表现
为了验证 GESTO 在完全自主建图条件下的真实鲁棒性,研究团队采用了标准基准数据集展开测试。该基准涵盖文本问答(Text)、真伪判断(Binary)以及精确时间定位(Time)三大类问题。
此前表现最好的代表性方案是 EGG。但需要指出的是,原版 EGG 运行在极具优势的“半人工特权”配置下:输入数据中已经给定了干净的动作起止时间区间与确定的跨事件物体 ID。而当采用完全由无监督算法自动构建时,现有主流时空记忆框架的推理表现往往会剧烈滑坡。
| 评测维度 / 查询类型 | DAAAM | ReMEmbR | EGG (依赖外部事件区间先验) | GESTO (全自动无先验) |
|---|---|---|---|---|
| 文本问答 (Text Acc) | 0.52 | 0.44 | 0.69 | 0.71 |
| 真伪判断 (Binary F1) | 0.61 | 0.55 | 0.78 | 0.75 |
| 时间查询 (Time Acc) | 0.48 | 0.38 | 0.78 | 0.70 |
| 空间到事件 (Space2Event) | 0.42 | 0.35 | — | 0.73 |
| 事件到空间 (Event2Space) | 0.49 | 0.41 | — | 0.75 |
实验数据表明,在完全剥离外部先验的完全自主建图条件下,GESTO 的综合表现逼近甚至在部分指标上超越了享有特权输入的 EGG 基线:
在文本问答维度上,GESTO 取得了 0.71 的高分,超越了外部辅助下的 EGG(0.69);在真伪判断和时间定位上,分别拿到了 0.75 和 0.70 的优异成绩。相比之下,那些纯粹依赖物体移动轨迹、缺乏人类活动层级建模的对比方案(如 DAAAM 与 ReMEmbR),在处理涉及交互行为的问题时准确率普遍被压制在 0.50 左右。
此外,针对机器人应用中极为高频的“双向跨域推理”需求,研究人员专门补充构建了包含 40 组查询的全新测试集:
-
Space2Event 查询(输入空间/物体,反查人类活动):例如“这个红色的椅子通常被用来做什么?”GESTO 斩获了 0.73 的得分。
-
Event2Space 查询(输入抽象行为,反查物理实体与地点):例如“人们午餐后通常聚在哪个房间?”GESTO 达到了 0.75 的高精度。
消融实验进一步剖析了 GESTO 各设计模块的不可替代性:
若去掉前段的视频片段切分(Video Fragmentation),让大模型直接吞吐长视频,受限于视觉 Token 窗口,交互检测会出现严重漏检,文本准确率随之从 0.71 跌至 0.57;
若剥除双向交互精炼机制(Grounding Refinement),因传感器噪声丢失链接的交互动作将彻底无法对齐到底层物体,图谱推理能力大幅缩水;
而一旦剔除高层事件层级(Event Hierarchy),退化为单纯的原子动作平铺,系统在面对复杂语义问答时将失去上下文约束,彻底失去对长程任务的检索组织能力。
跨视角迁移:第一视角视频中的零样本适配
虽然 GESTO 初衷是解决安装在机器人底盘上的传感器建图,但该拓扑记忆框架本身对相机拍摄视角没有任何先验偏见。
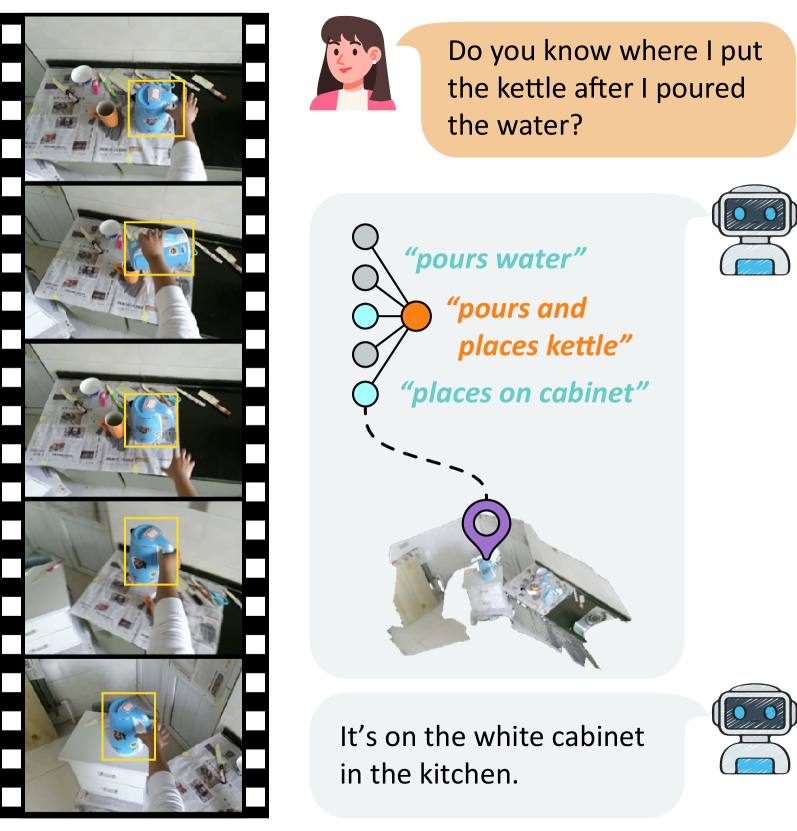
为了验证其泛化潜力,团队将未经重新训练的 GESTO 算法直接部署在来自 EgoLive 与 HOI4D 的第一视角人机交互视频流上。如图 4 所示,当用户佩戴智能眼镜提问:“你知道我倒完水后把水壶放哪里了吗?”
系统自动在构建的时空记忆图谱 $\mathcal{G}^{+}$ 中顺藤摸瓜:定位到“倒水”事件所关联的原子交互“拿起水壶倒水”,沿着时序边缘找到其紧接着的下游交互“将水壶放在柜子上”,最终成功返回高置信度回答:“在厨房的白色矮柜上”。这一实验有力地证明了 GESTO 在智能家居、AR/VR 辅助设备等不同载体间迁移的通用价值。
总结与未来展望
GESTO 的核心突破在于明确了一个关键认知:在动态人类生活环境中,有效的场景记忆绝非只是给 3D 点云附加上密密麻麻的文本标签,而是必须将持久的三维几何与目标驱动的人类行为深度咬合。
通过将时空图谱分层抽象,GESTO 成功让具身智能体既懂得以物理实体为锚点的空间感知,又拥有了以目标为导向的社会活动常识。尽管系统目前在应对超长周期的周期性规律提炼(如自动挖掘家庭成员固化日常作息)方面仍有扩展空间,但其展示的“感知-抽象-精炼”自监督循环,无疑为下一代兼具常识感知与因果回溯能力的家庭服务机器人提供了至关重要的基石。