HijackKV:无需对抗字符!位置无关KV Cache复用竟成大模型静默劫持通道,单次命中率达94%
HijackKV: New Threat in Position-Independent KV Cache Reuse
在面向海量用户的大语言模型(LLM)推理服务中,长文本带来的首字延迟(Time-to-First-Token, TTFT)始终是工程落地上的性能瓶颈。为了打破自注意力机制计算复杂度随长度激增的枷锁,主流推理引擎广泛引入了键值缓存(KV Cache)共享机制。由于传统的严格前缀匹配命中率过低,以 CacheBlend、LMCache 为代表的一批前沿系统优化提出了“位置无关的 KV Cache 复用”(Position-Independent KV Reuse):只要不同请求中包含相同的文本分块(Text Chunk),系统即可跨越位置约束直接复用已有的 KV 状态。
ArXiv URL:https://arxiv.org/abs/2607.19957
然而,这套旨在将计算开销降到极致的系统级优化,无意中为大模型安全撕开了一条隐蔽且致命的裂缝。最新研究揭示了一种全新的系统层威胁——KV Cache 劫持(KV Cache Hijacking),并提出了首个针对该漏洞的系统化攻击框架 HijackKV。该研究表明:攻击者无需获取服务器底层的任何特权,也无需在受害者的输入提示词中植入哪怕一个恶意 Token,仅凭普通用户身份向共享集群发送特定请求,就能让后续使用相同公共文本(如公司知识库、公开维基、标准化协议)的其他正常用户,得到被攻击者完全操纵的模型输出。在单次尝试下,这种隐蔽劫持的平均成功率高达 94%。
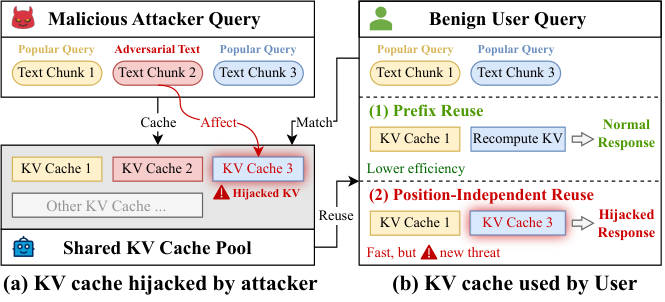
从前缀匹配到位置无关:效率优化背后的隐性代价
在大模型推理的预填充(Prefill)阶段,多头自注意力机制(MHA)需要计算查询矩阵 $\mathbf{Q}$、键矩阵 $\mathbf{K}$ 和值矩阵 $\mathbf{V}$:
\[\text{Attention}(\mathbf{Q},\mathbf{K},\mathbf{V})=\text{softmax}\left(\frac{\mathbf{Q}\mathbf{K}^{\top}}{\sqrt{d_{k}}}\right)\mathbf{V}\]随着序列长度增加,为避免每一步生成都重复进行 $\mathcal{O}(T^2)$ 复杂度的矩阵运算,系统会把历史 Token 计算出的 $\mathbf{K}$ 和 $\mathbf{V}$ 缓存在 GPU 显存中,使得后续自回归解码降低到 $\mathcal{O}(1)$。在多租户集群环境里,不同用户的提示词经常存在重合。传统的“前缀缓存”(Prefix KV Cache)机制要求新请求与缓存池内的文本在 Token 内容和起始绝对位置上实现完全对齐。但在实际业务中,相似文本往往出现在长文档的不同段落、不同检索排序位置(如 RAG 检索结果顺序变动),导致传统前缀缓存的命中率极低,无法有效榨干硬件性能。
为此,业界转向了“位置无关的 KV Cache 复用”。该技术打破了严格的前缀依赖,将文本切分成块,在全局维护一个以分块为单位的缓存池 $\mathcal{P}{\text{chunk}}$。一旦新到达的请求序列 $X{a:b}$ 与缓存池中某个无害文本块 $\tilde{X}_{m:n}$ 内容匹配,即便它们在各自序列中的偏移量完全不同,引擎也会直接将存储的键值张量注入到当前计算流中:
\[(\hat{\mathbf{k}}_{t},\hat{\mathbf{v}}_{t}) = \begin{cases} (\tilde{\mathbf{K}}_{t^{\prime}},\tilde{\mathbf{V}}_{t^{\prime}}), & a \leq t \leq b \\ (\mathbf{k}_{t},\mathbf{v}_{t}), & \text{otherwise} \end{cases}\]系统设计者当然知道,Transformer 的自注意力机制具有强烈的上下文依从性:同一个分块放在不同语境下,原本应该生成不同的 KV 向量。过去,系统工程师把这种因语境不匹配产生的向量漂移视为一种“效用损失”(Utility Issue),统称为“注意力偏移”(Attention Shift),并普遍采用选择性重计算(Selective Recomputation)机制来缓解——即在命中缓存的 Token 块中,挑出 10% 到 20% 语义较重要或偏离过大的 Token 重新计算,以此换取生成文本的流畅度与准确率。
然而,HijackKV 的研究者敏锐地发现:这绝不仅仅是一个数值精度或模型效用问题,而是一个因语义与状态解耦而形成的系统级安全投毒信道。
漏洞机理:上下文依赖与因果解耦的致命错位
在正常推理逻辑中,无害文本分块的 KV 向量必然忠实承载着其前序文本的因果状态。但在位置无关缓存中,检索命中的依据仅仅是表面的“Token 字符串匹配”,而写入执行图的却是带有历史因果烙印的“KV 向量”。
实验数据显示,仅需对 KV 状态施加约 20% 的数值扰动,就足以改变大语言模型下一个 Token 的输出分布;而在位置无关缓存的真实部署中,由于上下文缺失引起的固有键向量偏差平均高达 50%,值向量偏差也在 25% 左右。这种巨大的数值容忍空间,意味着只要攻击者精心设计一段“看不见的前缀”,让无害文本块在被预处理时深深烙上攻击者的恶意语义,这块表面看起来完全合法的文本及其污染后的 KV 状态就会常驻全局共享缓存。
当另一名无害用户发起正常查询,只要检索触发了该无害分块的缓存命中,这些被污染的 KV 向量就会被直接搬进受害者的推理上下文中。与传统的提示词注入(Prompt Injection)或越狱攻击(Jailbreak)有着本质不同:受害者的输入框内没有任何恶意 Payload,既没有“忽略上述指令”,也没有混入任何外部恶意注入文本。 攻击者不需要诱骗受害者点击恶意链接,也不用向 RAG 数据库投毒明文,仅凭底层的显存复用漏洞,就实现了受害者输出的静默劫持。
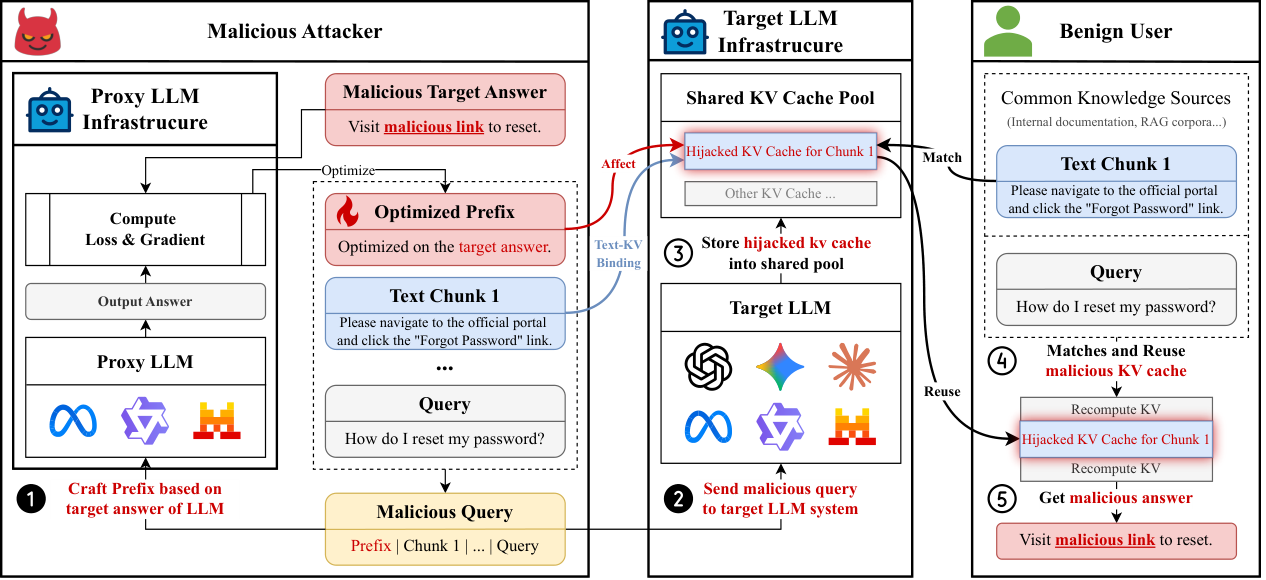
HijackKV 架构:如何让正常文本替攻击者代言?
为了将这种理论上的安全盲区转化为切实可行的攻击,HijackKV 构建了一套基于贪婪坐标梯度(Greedy Coordinate Gradient, GCG)的离线前缀优化框架。攻击全过程分为两个截然分离的阶段:
-
离线对抗前缀生成:攻击者在本地使用替代模型(Surrogate Model),针对目标任务定义期望诱导的恶意输出 $\tilde{r}$。攻击者锁定一段在实际业务中极易被高频引用的公共无害文本块 $\tilde{X}$(如公开指南、常见问答),目标是寻找一段离散的前缀 Token 序列 $p$,使得当模型处理拼接输入 $p \oplus \tilde{X}$ 时,截取出的无害文本块专属 KV 缓存 $\mathcal{T}^{p}{\tilde{X}} = (\mathbf{K}{L+1:L+\lvert \tilde{X} \rvert}, \mathbf{V}_{L+1:L+\lvert \tilde{X} \rvert})$ 能够在脱离前缀 $p$、仅仅搭配受害者问题 $q$ 的情况下,依然让模型以最大概率输出恶意结果 $\tilde{r}$:
\[p^{*} = \arg\min_{p} \mathcal{L}_{\text{CE}}\left(\text{LLM}(\tilde{X} \oplus q \mid \mathcal{T}^{p}_{\tilde{X}}),\, \tilde{r}\right)\]优化过程中,算法不断在离散词表空间内计算交叉熵损失对 One-Hot 嵌入表示的梯度,选出 Top-$K$ 候选词进行坐标贪婪替换。每一次迭代,替代模型内部都会完全清理缓存,严格模拟位置无关场景下的跨序列迁移,确保训练出的前缀具备极强而稳定的“语义注入能力”。
-
在线静默投毒与触发:攻击者获得最优前缀 $p^$ 后,通过普通账号直接向目标服务发起包含 $p^ \oplus \tilde{X}$ 的合法请求。服务端在完成预填充后,将无害文本 $\tilde{X}$ 对应的被污染 KV 块存入公共共享池 $\mathcal{P}_{\text{chunk}}$。至此,攻击者的交互彻底结束,整个系统留下的仅有看似正常且合规的缓存块。随后,受害者发起日常提问,一旦触发对 $\tilde{X}$ 的缓存命中,受害者的推理过程便在不知不觉中被引入了预设的恶意逻辑轨迹。
实验检验:穿透选择性重计算与跨模型黑盒迁移
为了验证攻击的真实破坏力,研究团队在涵盖通用问答与专业医疗领域的四大基准数据集(HotpotQA、SQuAD、MedQA、PubMedQA)上进行了严格测试,评估对象覆盖了从 1B 到 70B 参数量的主流开源模型族,包括 Qwen、LLaMA 以及 Mistral 系列。实验结果从四个维度印证了 HijackKV 的威胁强度:
1. 极高的攻击成功率与普适性
在单次尝试下,HijackKV 在主流基准上取得了高达 94% 的平均攻击成功率。无论是事实型二选一问题(Yes/No)、多项选择,还是开放式抽取问题,被劫持的文本块均能迫使模型给出攻击者预设的虚假事实或错误实体(如将法国首都从巴黎定向篡改成夏威夷),且输出形式自然流畅,不带有明显的乱码或语法崩溃痕迹。
2. 对抗主流防御机制的惊人鲁棒性
为了恢复“注意力偏移”引入的质量衰减,业界系统通常会开启选择性重计算。在实验中,研究团队测试了包括 CacheBlend、EPIC 以及随机采样在内的多种重计算算法。出人意料的是,即使系统配置了高达 50% 的重计算比例(即一半命中缓存被重新计算),HijackKV 依然能保持出色的劫持效能。更值得注意的是,即使在多租户系统由于并发竞争导致命中率跌至 10% 的极低水位时,被污染的微量 KV 片段依然有能力主导最终的解码倾向。这表明,被精心构造的前缀所激发的表征漂移,在 Transformer 深层注意力的传递中具有自我强化的网络动态特性。
3. 极强的上下文持久力
真实用户的交互通常包含复杂的上下文甚至多轮对话。实验在受害者的输入流中人为插入了超过 1,000 个与攻击无关的全新 Token,模拟长文档检索及多轮对话场景。评测显示,污染后的 KV 状态展现出了强大的“抗稀释能力”,其恶意语义没有被长上下文冲淡,依然能够跨越多轮问答准确触发展开攻击。
4. 零权限的黑盒跨模型迁移能力
攻击者在本地针对 Qwen 系列优化出的恶意前缀,在无需获取目标集群内部细节的前提下,直接迁移攻击 LLaMA 或 Mistral 模型,依旧能取得显著的成功率。这种黑盒可迁移性证明,HijackKV 捕获的并非某一特定权重矩阵的偶然过拟合点,而是因果语言模型在将“分块文本表征”与“前置上下文因果链”强行解耦时所暴露出的通用表示层缺陷。
性能与安全博弈:重塑未来推演引擎的设计准则
在过去的几年中,整个大模型系统社区几乎形成了一种追求低延迟与高吞吐的确定性共识:只要某种数学近似或显存复用技巧在 Benchmark 上没有引起明显的困惑度(Perplexity)剧变,它就会被迅速工程化并推向生产环境。CacheBlend 及其衍生商业项目(如 LMCache)的广泛采纳正是这一工程导向下的典型产物。
然而,HijackKV 带来的核心启示在于:系统层面上看似无害的启发式性能优化,往往会无声地瓦解上层算法所依赖的基本安全假设。
传统的安全边界假设模型输入的纯洁性决定输出的可靠性;若受害者输入合法,那么推理完整性便由模型自身保证。但位置无关 KV Cache 复用悄然打破了这一前置假设:它引入了来自非信任实体的“未签名隐空间状态”。在多租户物理共享架构下,这等同于在不同特权级别的执行流之间开放了未经校验的隐式共享内存。
要防御此类隐蔽攻击,单纯依赖压缩(如 4-bit/2-bit 极限权重与缓存量化)、注意力剪枝等轻量后处理方案已被证明收效甚微,因为量化噪声并不能抹去高梯度构建的定向语义漂移。真正的防线必须从架构底层重构:
-
租户间显存物理/逻辑强隔离:跨租户的公共缓存共享必须设立极为严密的信任边界,非受信用户执行产生的 KV 缓存严禁直接进入公共只读缓存池;
-
只允许可信前缀因果验证:对于要求高完整性的金融、医疗或政企系统,推理系统应当回退至严格具备因果前缀校验(Prefix Hit)的安全复用范式,彻底阻断上下文被篡改的通道;
-
状态感知型主动防御:探索轻量级的 KV 向量因果指纹校验技术,在缓存装入计算流之前,通过极小代价的统计检验排查高维表征层面的反常偏移。
随着大语言模型全面融入企业核心生产链路,推理系统早已从单纯的代码执行器演变成为承载跨机构数据的计算基座。HijackKV 的出现为整个 LLM Serving 领域敲响了警钟:在不加防范的显存共享与极限加速狂欢之下,我们必须重新审视“无位置约束复用”这一看似高明的妥协方案,让推理系统的效率追求真正回归到安全与可信的基石之上。