LeakyLMs:通过逐 Token 耗时逆向黑盒模型架构与推测解码
Leaky Language Models: Stealing Architecture and Inference Optimizations via Per-Token Timing
在商业大语言模型(LLM)的激烈竞逐中,模型架构超参数与推理端部署策略被各大厂商视作极其核心的商业机密。从隐藏层维度、注意力头数、网络层数,到推测解码(Speculative Decoding)中草稿模型(Draft Model)的规格,闭源模型对外部世界往往只保留一个简单的流式 API。
ArXiv URL:https://arxiv.org/abs/2607.20723
然而,为了保证低延迟的实时交互体验,服务商必须提供精细的逐 Token 流式响应(Streaming QoS)。这项设计在提高交互流畅度的同时,也向外部暴露了极度精准、以时间为单位的侧信道信号。
针对这一底层特性,安全研究团队提出了名为 LeakyLMs 的新型侧信道攻击体系。研究表明,攻击者完全无需访问模型权重、激活值或 Logits,仅凭在常规 API 客户端观测连续 Token 之间的到达时间差,就能逆向推导闭源大模型的内部部署优化与网络底层架构参数。该攻击不仅精准测出了 Google Gemini Flash 系列采用的推测解码草稿模型上下文长度,还在未知的 Llama 系列测试中以超过 90% 的概率将真实网络配置锁定在候选集前 10 位。
为什么 Token 间延迟能出卖一切?
网络延迟本身虽然存在抖动,但当客户端订阅流式 API 时,连续两个输出 Token 到达客户端的时间差(Differential Token Timing)在很大程度上抵消了公网固有的网络传播噪声。
这一差值本质上直接反映了服务单卡或服务集群在执行单步自回归 Forward 计算时的硬件计算与显存访问时间。而在现代 Transformer 体系中,这一计算过程由严谨的数学逻辑支撑:
-
计算复杂度与硬件映射的强绑定:Transformer 的计算图具备极其规范的渐近特性。隐藏层维度 $H$、注意力头数 $A$、网络层数 $L$ 以及前馈网络维度 $I$,在 GPU 矩阵乘法(GEMM)和注意力算子中会呈现固定的多项式耗时组合。
-
推理阶段的动态变化:引入 KV-Cache 后,Prefill 阶段与自回归 Decoding 阶段表现出完全不同的算力与显存带宽受限特征;引入推测解码时,草稿模型命中与主模型回退之间会引发剧烈的离散步长延迟变化。
这种独特的动态变化,在时序上构成了无法掩盖的“硬件执行指纹”。
攻击机制一:推测解码与草稿模型上下文挖掘
推测解码通过引入一个体积小、速度快的草稿模型,先行生成 $N$ 个候选 Token,再交由大参数量的主模型在单次前向传播中进行并行验证。如果两者预测一致,主模型一次性接受全部候选,端到端吞吐大幅提升;若预测出现分歧,主模型则回退至常规单步生成,并放弃后续候选。
由于草稿模型通常具备较小的上下文窗口(Context Window),LeakyLMs 利用这一特性设计了定向探测 Prompt:
-
构造形如
We have a {n} digit number NUM={rand_num}.{var_pad_str} The value of number NUM at the start was equal to的提示词。 -
随机生成的长数字串位于 Prompt 开头,随后填充由非重复字符构成的动态变长填充字段
{var_pad_str},并在 Prompt 末尾要求模型重现最初的数字。 -
这种设计确保了模型若想给出正确预测,注意力必须精准回溯到 Prompt 最前端的初始 Token。
随着填充长度 $x$ 逐步递增,当总长度超过草稿模型的最大支持范围时,草稿模型由于“失忆”开始无法与主模型达成一致,导致验证命中率骤降,触发回退机制。在外部测量视角下,客户端收到的单步 Token 耗时会出现极其陡峭的跃升。
通过二分搜索算法定位产生延迟跳变的临界 Prompt 长度 $T_{break}$,攻击者即可推导出草稿模型的上下文容量:
\[\text{Draft Context} \approx T_{break} - \text{Prologue Length}\]在真实的闭源 API 测试中,该攻击成功破解了 Google Gemini 生产集群的隐藏工程细节:测量显示 Gemini Flash 1.5、Flash 2.5 和 Flash 2.5 Lite 均启用了推测解码,其底层草稿模型的上下文窗口长度分别约为 32K、128K 和 128K Tokens。这证明了即使在十万级别超长上下文的复杂推理链路下,推测解码的状态切换依然存在巨大的侧信道漏洞。
攻击机制二:基于分析-实证混合模型的架构逆向
相比于推测解码的宏观状态突变,直接提取底层的隐藏层维度 $H$、层数 $L$ 和头数 $A$ 难度更大。因为在同一块 GPU 上,深而窄的网络结构与浅而宽的结构可能会产生相近的总耗时。
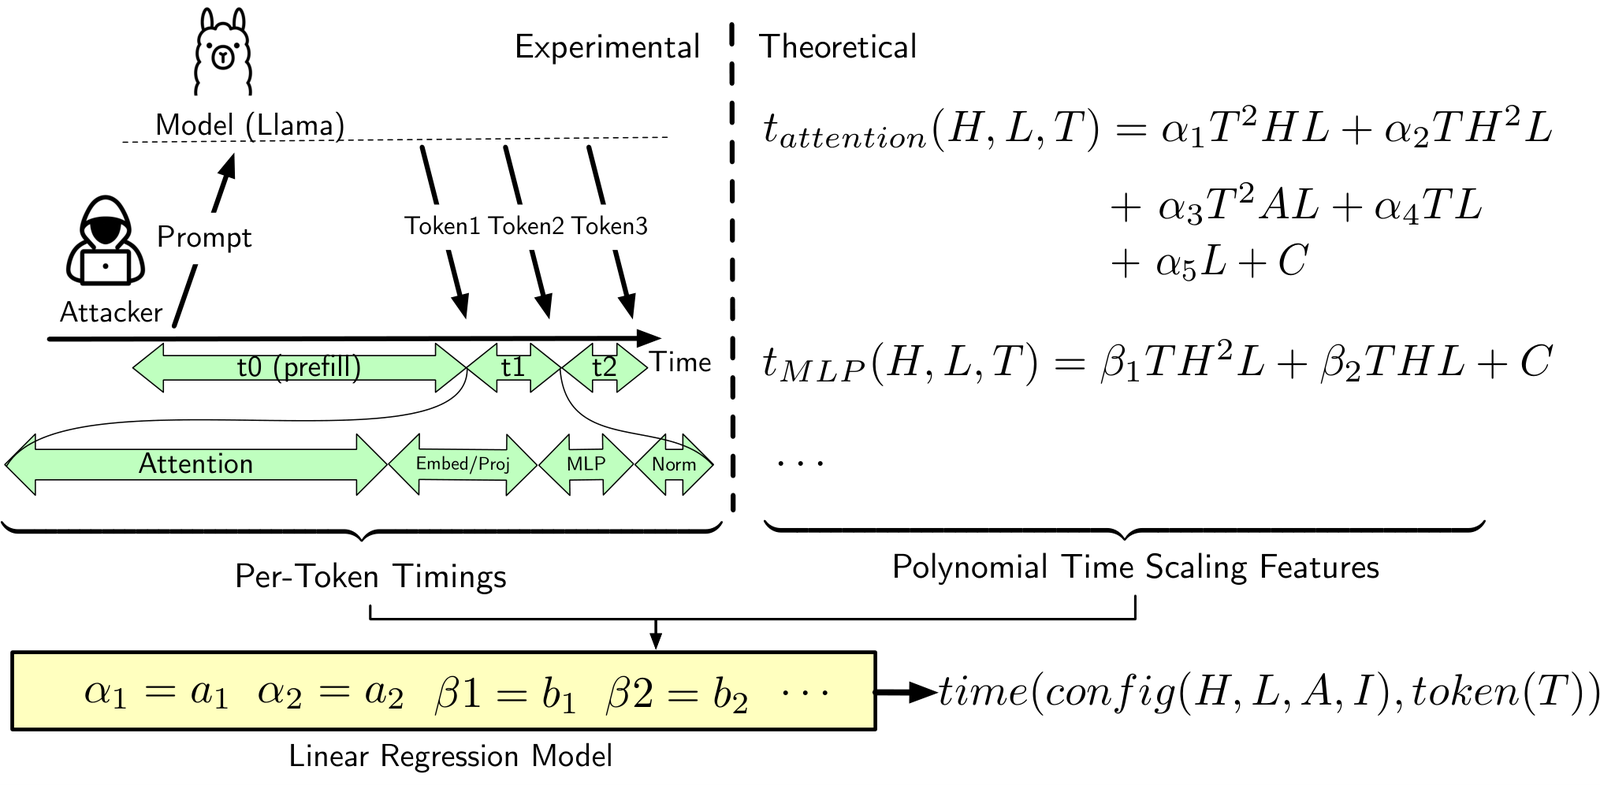
为了解构这种耦合,LeakyLMs 构建了一套从“底层算子渐近分析”到“实证回归校准”的两阶段建模框架。
1. 理论渐近展开与实证回归
研究团队首先沿着 Transformer 的前向计算图对各模块进行算力与内存带宽建模:
-
投影与线性变换:$time_{Q\text{-}proj} \approx \alpha \frac{T H^2}{d} + \beta \frac{b T H + b H^2}{c} + C$
-
注意力计算:$t_{att} = a_1 H^2 T L d + a_2 T^2 H L d + a_3 b T^2 A L c + \dots + C$
-
模型整体耗时:将自注意力机制、多层感知机(MLP)、LayerNorm 及输入输出投影聚合:
\[t_{llm} = t_{att} + t_{mlp} + 2 \cdot t_{norm} + t_{embed\_proj} + t_{overhead}\]
随后,研究人员在同构 GPU 硬件环境上采集多组不同形状的基础开源模型运行数据,通过线性回归拟合公式中的待定经验系数。通过将硬件矩阵乘法的非线性阶梯跳跃纳入校准范围,该预测器摆脱了以往纯解析模型容易失真的问题,在原生实现下取得了 0.12 的归一化均方根误差(NRMSE),在整合了 FlashAttention-2 与 KV-Cache 的复杂环境下依然保持在 0.188。
2. 结合 KV-Cache 的两阶段搜索剪枝
真实场景广泛采用 KV-Cache,这导致除第一个 Token(Prefill 阶段)耗时随上下文明显变长外,后续生成步(Decoding 阶段)的单步耗时差异极其平缓。针对这种可用信息稀疏化的场景,LeakyLMs 提出了两阶段搜索策略:
-
第一阶段(Prefill 粗排):仅依据首个 Token 对应不同 Prompt 长度的延迟表现,结合理论预测器在整个离散架构空间中进行网格匹配,迅速筛选出 Top-35 候选构型。
-
第二阶段(精细重排):利用后续生成的平均单步耗时特征,联合 Prefill 与 Decoding 联合打分,在缩小的候选集内完成二次精细定位。
实验成效与安全影响
实验评估基于 Llama 3.2 体系展开:攻击者仅使用 1B 模型的运行轨迹来训练预测器,进而尝试逆向从未见过的 3B 目标模型。
在包括标准 Eager 实现、FlashAttention-2 及引入 KV-Cache 的各类环境中,LeakyLMs 预测出的网络层数与真实值的偏差基本保持在 $\pm 1$ 层以内,Top-5 命中率分别达到 86.15%、97.69% 和 83.78%。当对真实托管在第三方推理服务平台(Weights & Biases)上的黑盒实例进行探测时,该算法精确锁定了隐藏维度 $H$,并在其输出的第 4 候选位精准命中真实网络层数。
这套体系打破了“黑盒流式 API 足以防御结构性窥探”的安全假设。当推理层为了极限性能而在计算图与显存调度中做出一系列折中时,这些底层工程设计恰好赋予了输出时钟不可磨灭的硬件级指纹。
随着推理服务市场逐步转向标准化基准,这种基于细粒度流式时序的侧信道攻击不仅能帮助竞争对手窥探各家模型的轻量级加速技巧,甚至可能让闭源模型赖以构筑的参数规模护城河在精准测量前失去神秘感。