LiLa-WAM:单卡24GB练出世界-动作模型,90.48%成功率领跑50项机器人任务
LiLa-WAM: Lightweight Latent Reasoning World-Action Model for Robotic Manipulation
具身智能领域最近正迅速向“世界-动作模型”(World-Action Models, WAMs)靠拢。传统视觉-语言-动作(VLA)模型的核心短板在于其本质是“被动反应式”的——只看当前一帧画面就输出机械臂的位姿变化,并不清楚环境在自身动作介入后会演变成什么样。世界-动作模型则试图赋予机器人“预见未来”(Foresight)的能力。
ArXiv URL:https://arxiv.org/abs/2608.03701v1
然而,现有 WAM 的实现代价高得令人望而却步。基于像素空间的方案试图直接生成未来的高清视频或下一帧画面,模型容量不可避免地被光影、背景纹理和微弱反光等与机械抓取无关的细节大量消耗;基于潜空间(Latent Space)的方法虽然避开了像素生成,但往往依赖多阶段训练,先独立训练一个复杂的潜世界模型,再拼接到下游策略网络中,训练成本依然居高不下。
来自云知声、自然资源部、深信服、深圳理工大学和天津大学等机构的研究团队提出了 LiLa-WAM(Lightweight Latent Reasoning World-Action Model)。它打破了传统世界模型必须依赖几十上百卡算力集训的门槛,仅凭一张消费级 24GB 显存显卡即可实现端到端训练。在拥有 50 项复杂操作任务的 RoboTwin 2.0 评测基准中,仅有 0.5B 总参数(可训练参数仅 0.2B)的 LiLa-WAM 达到了 90.48% 的平均成功率,并在 LIBERO 基准中取得了 97.1% 的高水准表现,显著超越了一众体量大数倍乃至十余倍的大型策略模型。
为什么现在的世界模型“又重又钝”?
目前机器人在学习物理交互时,主要受制于两条技术路线的缺陷:
第一条路线是“重生成、轻控制”的像素预测。这类方案通常以开源的重型视频生成底模(如 WAN)为基础,采用“先脑补未来帧再逆向推演动作”或“视频动作联合生成”的范式。对于机械臂来说,它关心的无非是“杯子是否被握紧”“推土机积木是否平移了 5 厘米”,但基于像素扩散的生成模型却将绝大部分浮点运算花在了如何完美补全桌布纹理、阴影渐变和背景反光上。这不仅造成严重的推演延迟,更使得单卡训练成为天方夜谭。
第二条路线是多阶段潜空间预测。这类方案意识到不该硬抠像素,于是引入隐变量(Latent)。但为了防止潜空间坍缩,往往需要先单独对潜状态做表征对齐,再外挂辅助损失,最后分步拼接到动作网络中。复杂的级联架构不仅拉长了训练链路,还容易在策略迁移时出现潜空间与动作流的不兼容。
具身控制需要的前瞻预测,并不需要像 Sora 那样事无巨细,它只需要在特征维度上对场景的变化趋势给出指引。LiLa-WAM 的思路非常干脆:彻底摒弃重型多模态大语言模型(VLM)底座与像素级扩散网络,构建一个紧凑的单流潜空间前瞻专家,将未来潜状态预测与连续动作生成合二为一。
潜空间单流前瞻:让推理开销归零
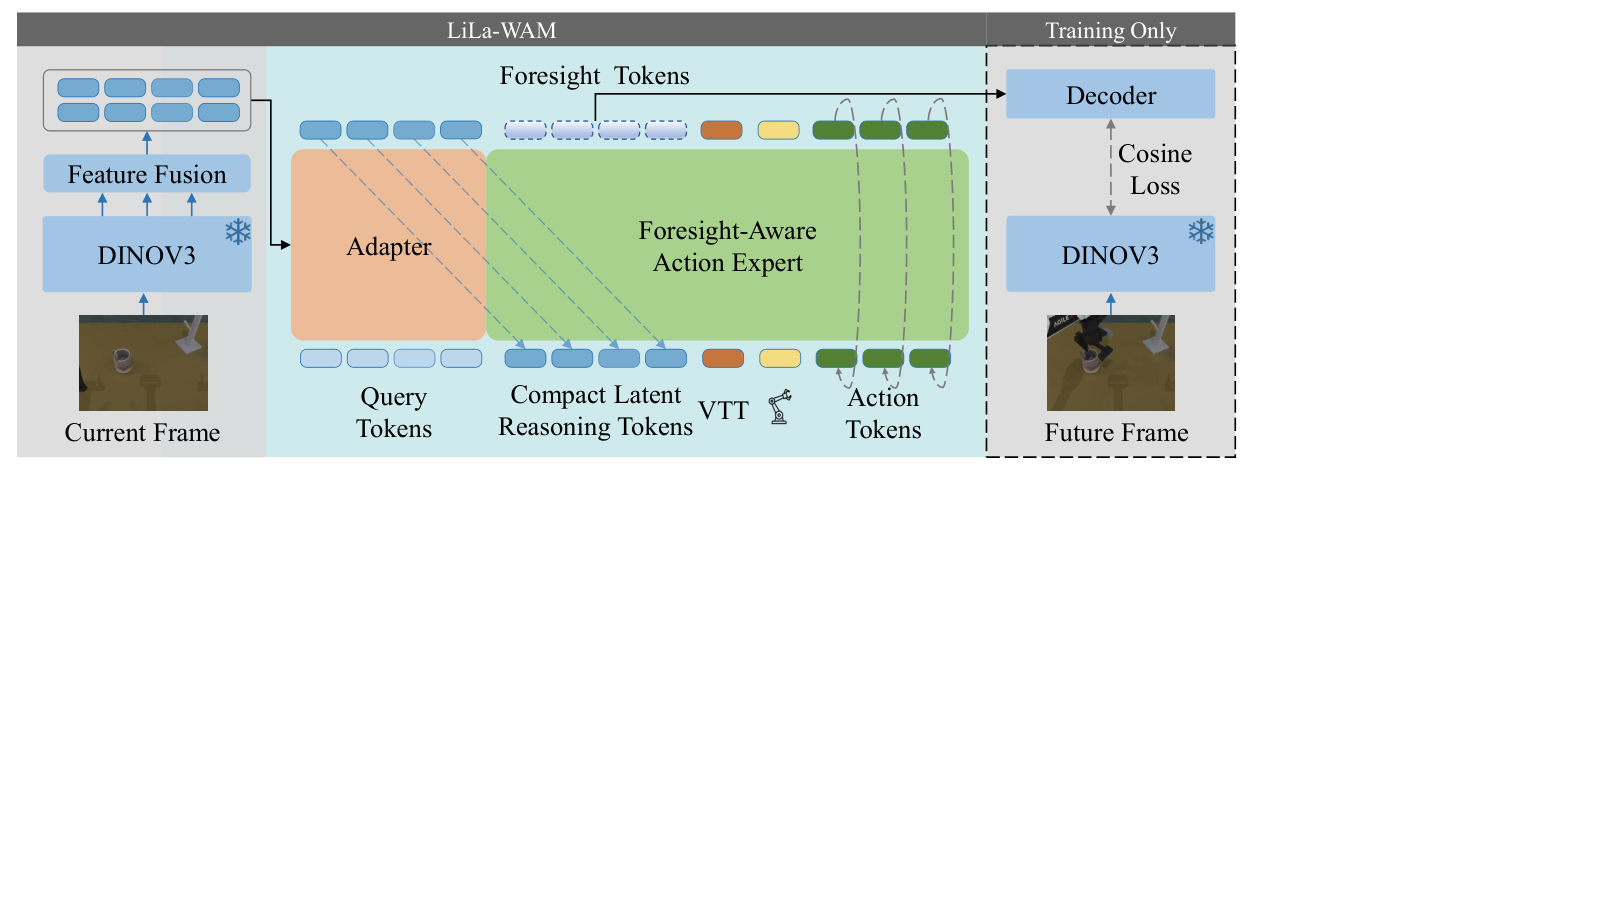
LiLa-WAM 的模型总参数为 0.5B,其中冻结的视觉特征提取底座占用 0.3B,真正参与训练的参数仅 0.2B。模型的核心在于 前瞻感知动作专家(Foresight-Aware Action Expert),它由一个 12 层、特征维度为 768 的扩散变换器(Diffusion Transformer, DiT)构成。
研究团队巧妙地将四个异构 Token 打包进同一个输入序列中:
-
压缩后的视觉上下文 Token $\mathbf{Z}_{v}$(通过轻量 Adapter 从视觉底模提取的 64 个 Query);
-
机器人当前的本体感知状态 Token $\mathbf{Z}_{q}$;
-
任务表征 Token $c_{\tau}$;
-
混入高斯噪声的连续动作 Token $\mathbf{Z}_{a}$。
在这套单流结构中,所有 Token 通过全双向自注意力机制无障碍地交换信息。DiT 的输出同时读出两个目标:一个是用于连续控制的动作速度场 $\hat{\mathbf{v}}$(采用 Flow Matching 范式,步长设为 32 步),另一个则是用于预测未来的前瞻 Token $\hat{\mathbf{z}}_{t+\Delta}$。
这里的精妙之处在于训练与推理的解耦设计。在训练阶段,模型引入了一个类似 Q-Former 的轻量级解码器 $\mathcal{D}$,将前瞻 Token $\hat{\mathbf{z}}{t+\Delta}$ 解码回预训练视觉编码器(选用 DINOv3-ViT-L/16)的 Patch 特征空间,并与真实未来时刻 $o{t+\Delta}$ 的视觉特征计算余弦相似度损失。这构成了辅助前瞻损失 $\mathcal{L}_{\mathrm{ff}}$。
因为未来的潜特征与动作预测共用同一套骨架和梯度反向传播,特征空间被迫同时保留控制相关性与物理动态预见性。而在部署推理阶段,这个轻量解码器被直接舍弃,机械臂在执行 Flow Matching 去噪时,仅凭前向传递就内生性地拥有了预判物理走向的能力,完全不引入额外的推理延时。在 RTX 4090 单卡上,模型单次决策推演耗时仅 85ms。
视觉迁移 Token:告别繁重的自然语言指令
在机器人多任务策略中,指定目标通常依赖自然语言文本(如“把蓝色马克杯放到挂钩上”)。然而,语言理解本身就消耗了多模态底模的大量算力,且语言容易出现歧义。另一种替代方案是给定目标图片(Goal-Image),但这要求测试部署时必须预先拍摄一张完成后的场景图,实用性受限。
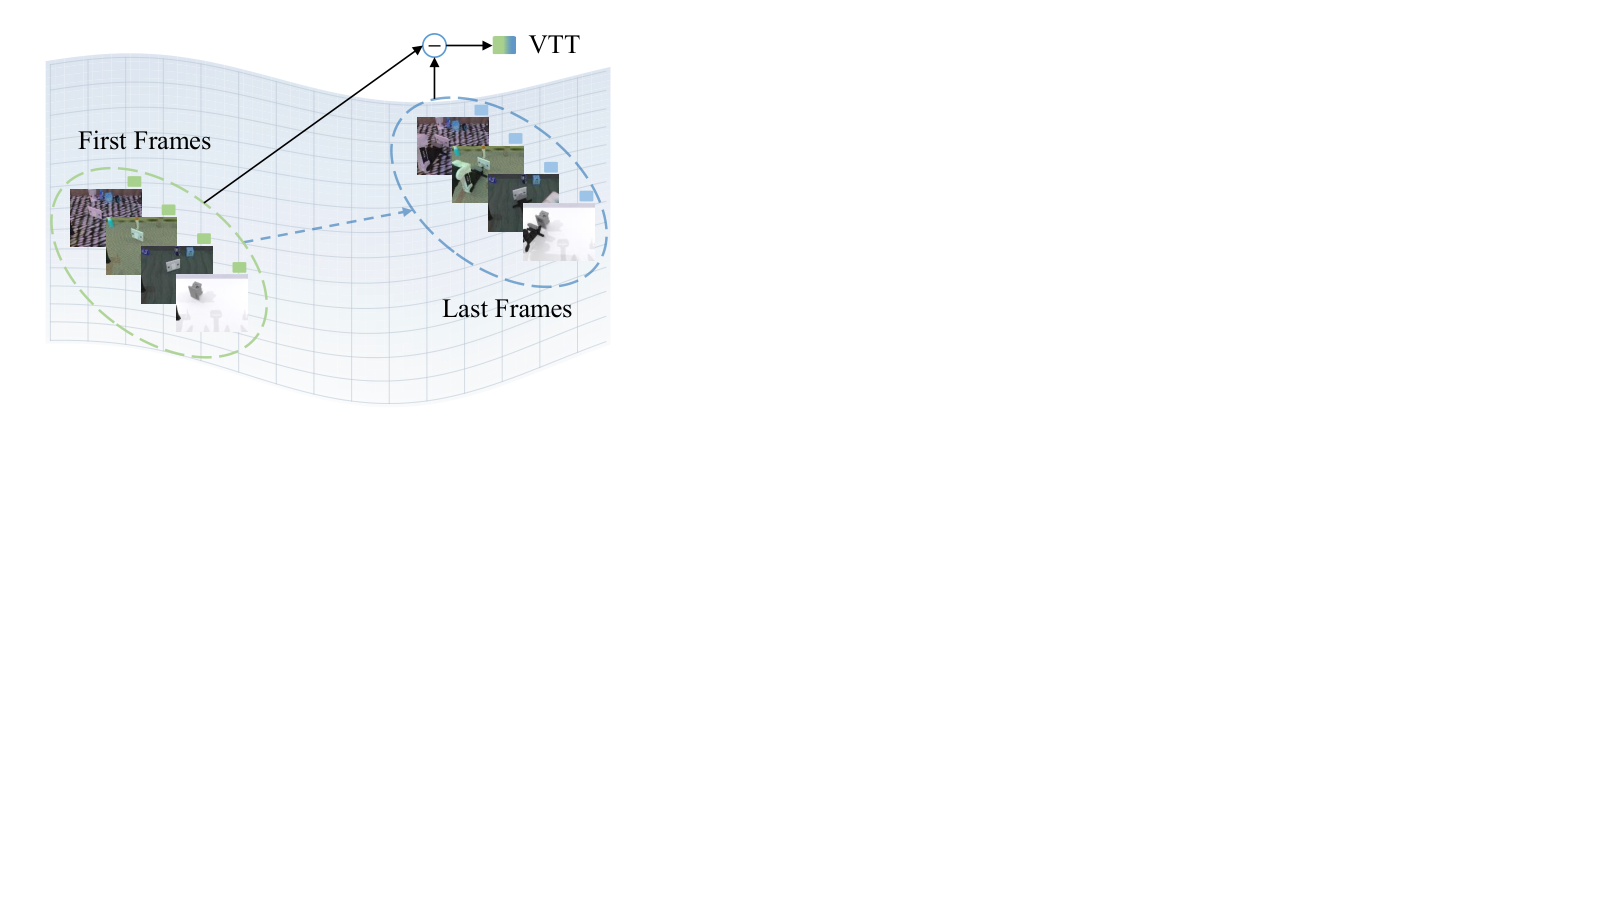
LiLa-WAM 提出了 视觉迁移 Token(Visual Transition Token, VTT)。其核心逻辑直击物理任务的本质:一个操作任务在视觉层面,本质上就是场景从初始状态向终末状态的演变向量。
具体而言,研究者在离线数据集中计算任务 $\tau$ 所有演示轨迹的首帧特征与尾帧特征的位移差:
\[\mathbf{u}_{\tau}=\frac{1}{\lvert \mathcal{E}_{\tau} \rvert}\sum_{e\in\mathcal{E}_{\tau}}\big(\mathbf{g}^{e}_{T}-\mathbf{g}^{e}_{0}\big)\]这个向量捕捉了“任务究竟改变了环境的什么”。由于是在高级视觉特征空间直接做向量差值,背景等静止特征被自然相消,保留下来的全是被操作物体的状态迁移。在推理测试时,模型只需要查表获取对应任务的固定向量,经由极轻量 MLP 映射为任务 Token 即可投入使用,既无需运行文本分词与语言模型,也无需现场拍摄目标图。
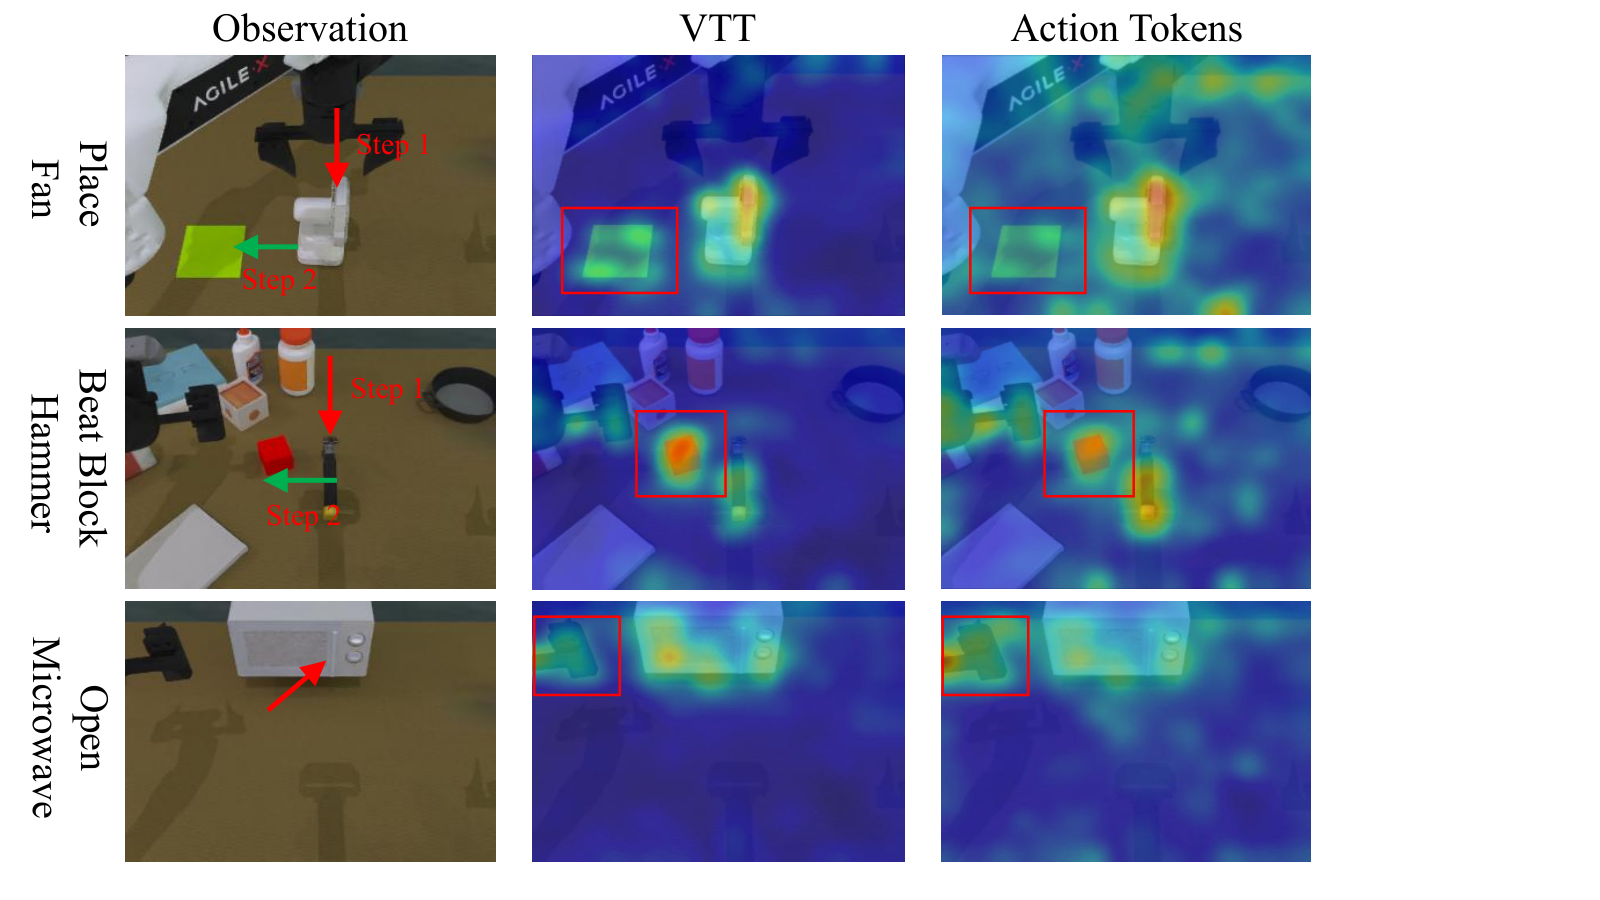
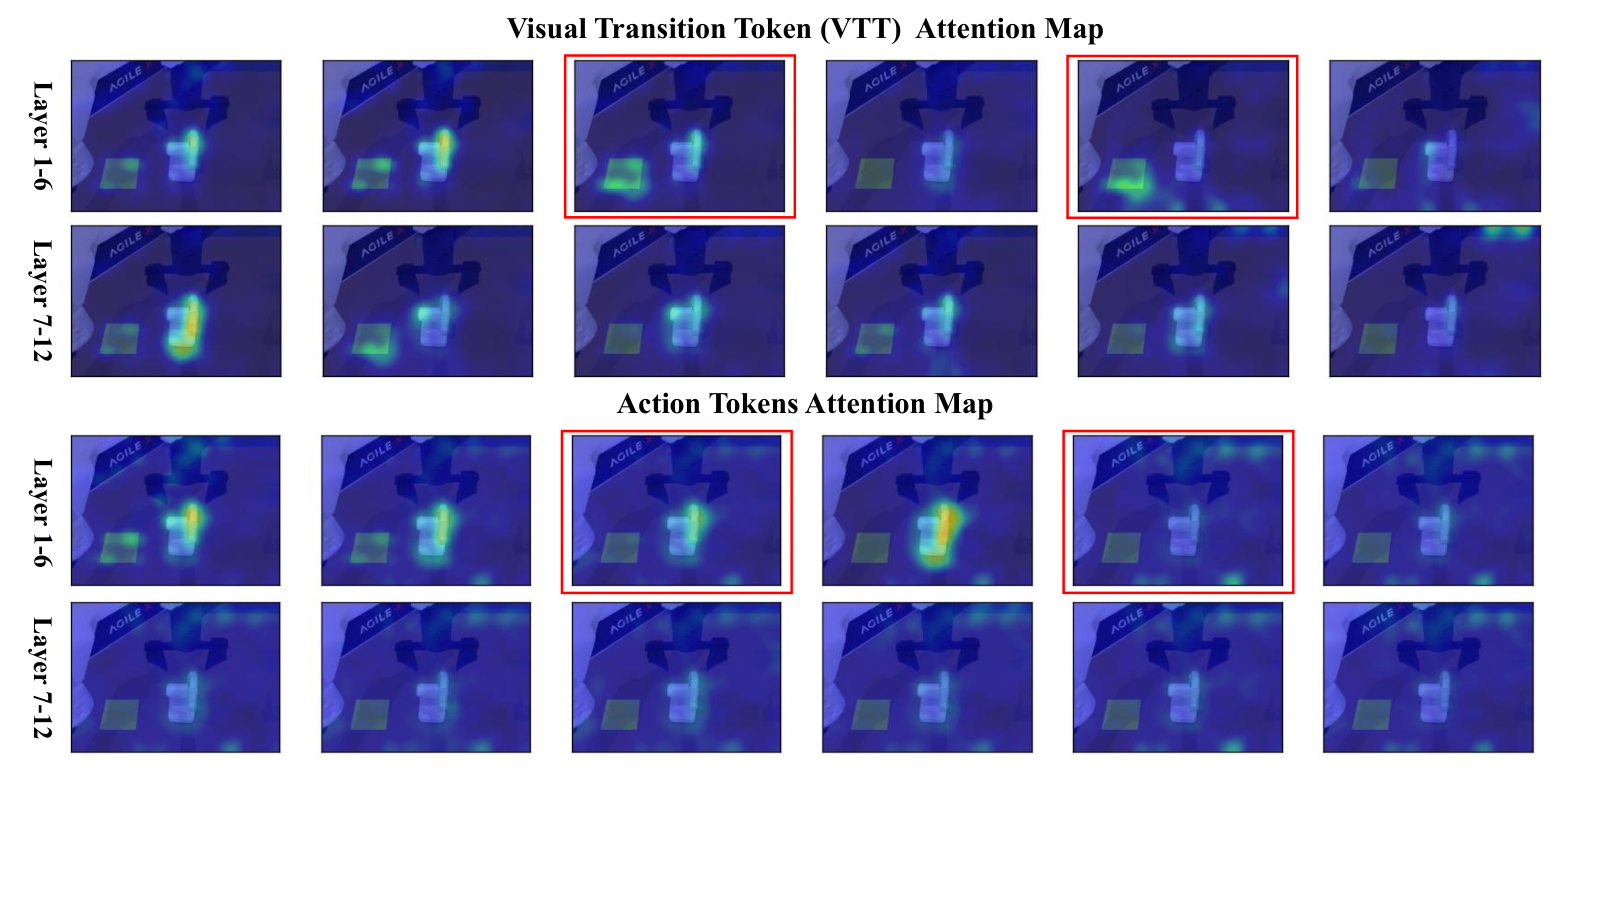
从注意力热力图的分析中可以清楚看到,VTT 与动作 Token 呈现出极佳的“分工机制”。VTT 强力聚焦在任务涉及的核心物体及放置目标点上(例如小风扇和放置底座、积木与锤子);而动作 Token 则精准锁定机械臂末端与当前的接触抓取区域。这证明 VTT 为底层动作生成提供了极度聚焦且纯净的高阶语义导向。
评测硬碰硬:小模型何以击败庞然大物?
研究团队在包含 50 项复杂操作任务的 RoboTwin 2.0、主流基准 LIBERO 以及真实实体机械臂上展开了全方位验证。
在 RoboTwin 2.0 的 50 项任务统一模型评测中,LiLa-WAM 的平均成功率达到了惊人的 90.48%。作为对比,参数量高达 8B 的 Motus 成功率为 88.7%,5B 的 GigaWorld-Policy 为 86.4%。LiLa-WAM 用仅为对手十几分之一甚至数十分之一的参数规模,实现了全面超越。更关键的是,许多庞大策略依赖庞大的 GPU 集群进行多阶段分布式训练,而 LiLa-WAM 的全部训练仅在单张 24GB 显存显卡上即可闭环完成。
在专注于轻量化比拼的 LIBERO 测试集(包含 Spatial、Object、Goal、Long 四大套件共 40 项任务)中,LiLa-WAM 的平均成功率飙升到了 97.1%。它不仅完胜了同为轻量级路线的 EVO-1(94.8%)和 SmolVLA(88.8%),还反超了基于扩散架构的经典基线 $\pi_{0}$(94.1%),并抹平了与参数量为其 14 倍的 OpenVLA-OFT 之间的差距。
消融实验进一步揭示了该模型高效运作的内在动因:
-
前瞻监督机制的不可替代性:在 RoboTwin 的 10 项代表性子任务测试中,剥离前瞻损失 $\mathcal{L}_{\mathrm{ff}}$、使模型退化为纯反应式策略后,平均成功率从 70.0% 骤降至 54.4%,印证了对未来潜状态的联合建模是提升控制鲁棒性的核心胜负手。
-
任务指令方式的选择:若将 VTT 替换为标准的 CLIP 文本嵌入指令,成功率从 70.0% 跌落至 61.4%,说明从视觉直接提炼的物理位移表征在操作任务上比高度抽象的自然语言更具信息确定性。
-
视觉底座并非越大越好:团队尝试将冻结的 DINOv3 替换为参数量大 4 倍的多模态大语言模型 Qwen3VL-2B,成功率反而下滑至 61.0%。这强有力地佐证了当前很多超大视觉-语言底座在处理精细几何交互与微观空间位置时存在冗余乃至干扰,紧凑且空间敏感的专用视觉表征才是轻量机器人控制的最优土壤。
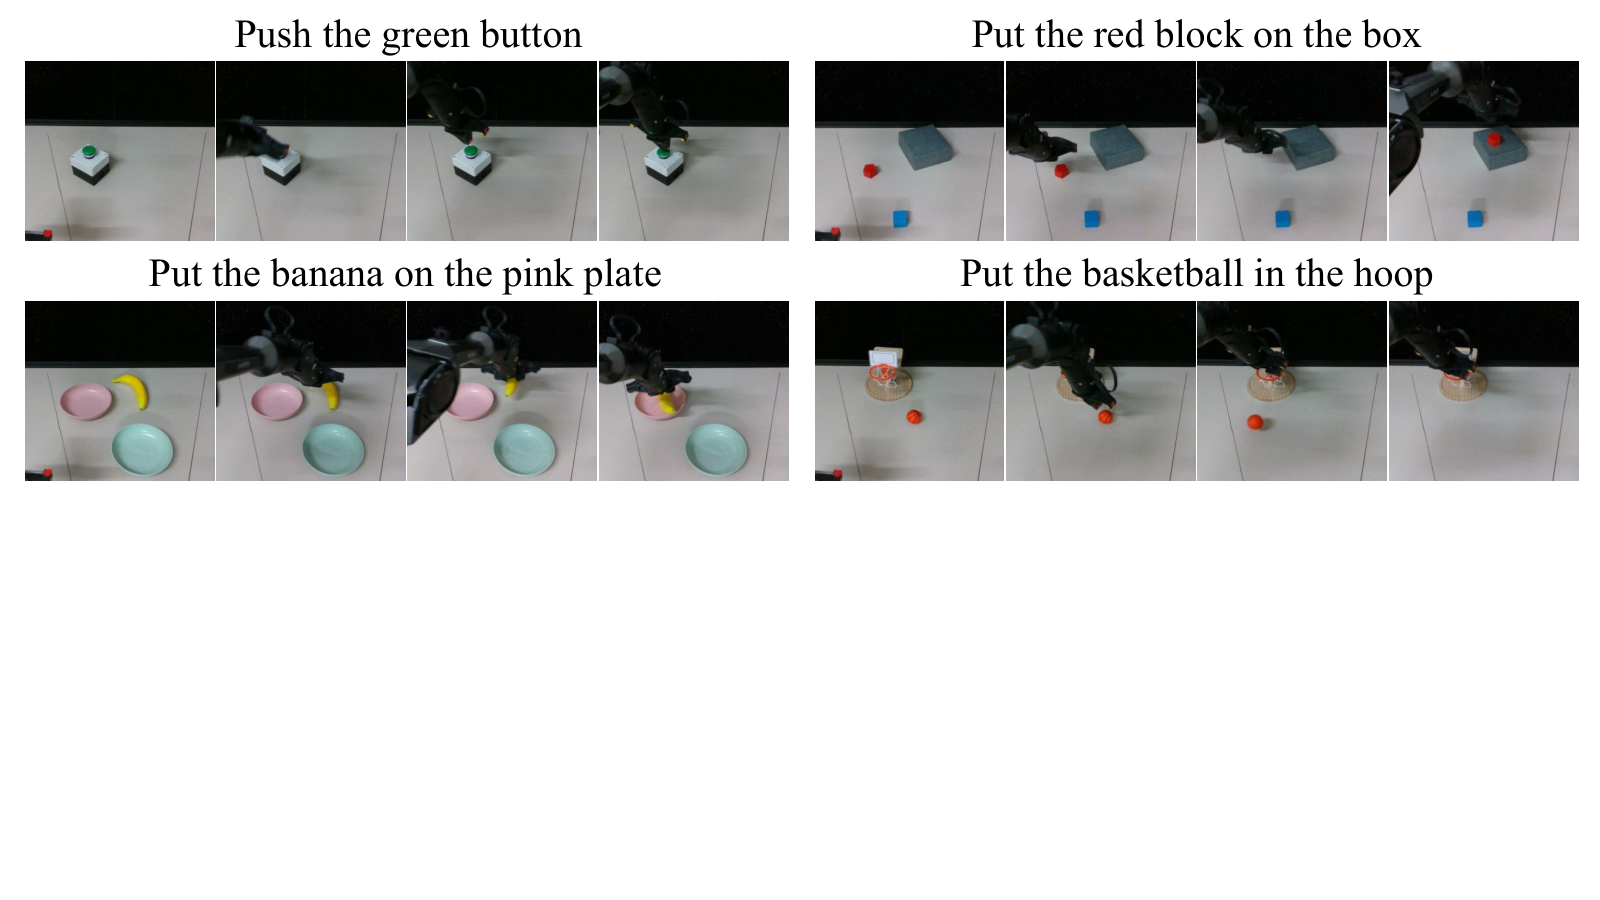
为了验证仿真到现实的泛化水准,研究人员在 Agilex Piper 6 自由度真实机械臂上部署了 LiLa-WAM。配合单目 Intel RealSense D435 相机,在 30Hz 的控制频率下,LiLa-WAM 在随机放置物体的复杂抓放、装配等 4 项现实任务中,均展现出比去除了前瞻机制的消融版本更稳健的闭环调整能力,没有出现传统反应式策略在突发扰动下容易陷入的“机械臂抽搐停滞”现象。
结语与行业启示
长久以来,具身智能领域被一种“规模至上”的定势思维所主导:大家默认想要获得强大的泛化能力与时空理解,就必须吞吐百亿参数的通用多模态基座,承受庞大的训练开销与推理延迟。
LiLa-WAM 给出了一条截然不同的突围路线:它证明了赋予机器人“预测物理未来”的能力,既不需要暴力生成无意义的像素动画,也不需要堆砌多阶段复杂系统。通过将紧凑潜空间的未来演进与动作流去噪紧密咬合,再辅以纯视觉的物理迁移 Token,仅需单张 24GB 显存显卡,就能训练出动作执行稳健、具备预见性且响应极快的高性能控制策略。对于算力资源受限的中小团队和需要兼顾低延迟边缘部署的具身硬件厂商而言,这无疑是一次极具参考价值的技术落地实践。