TraceViT:循环推理不能只看终点,带接地的轨迹监督突破67.8%
TraceViT: Grounded Trace Supervision for Visual Abstract Reasoning
在抽象与符号推理的核心战场 ARC-AGI(Abstraction and Reasoning Corpus)上,AI 模型长期面临一个尴尬的断层:一方面,庞大的前沿大语言模型依赖数千次测试时搜索或昂贵的代码合成才能艰难攻克;另一方面,参数量仅有数千万的紧凑视觉模型(Vision-native Models)虽然具备原生二维空间感知与高推理吞吐量,却难以处理长程多步的多层规则变换。
ArXiv URL:https://arxiv.org/abs/2607.29586
近期兴起的循环视觉架构(Looped Visual Reasoners)试图在模型尺寸与计算深度之间寻找平衡:通过在有限的视觉参数骨干上反复循环迭代,模型一步步细化预测。然而,现有的循环模型(例如 LoopViT、HRM 或 TRM)在训练时几乎全部采用“终点锚定”监督——损失函数只约束最终输出,中间的循环状态完全处于无约束的暗箱演化之中。这导致模型在面对复杂组合变换时,无法学到稳定可靠的推理路径。
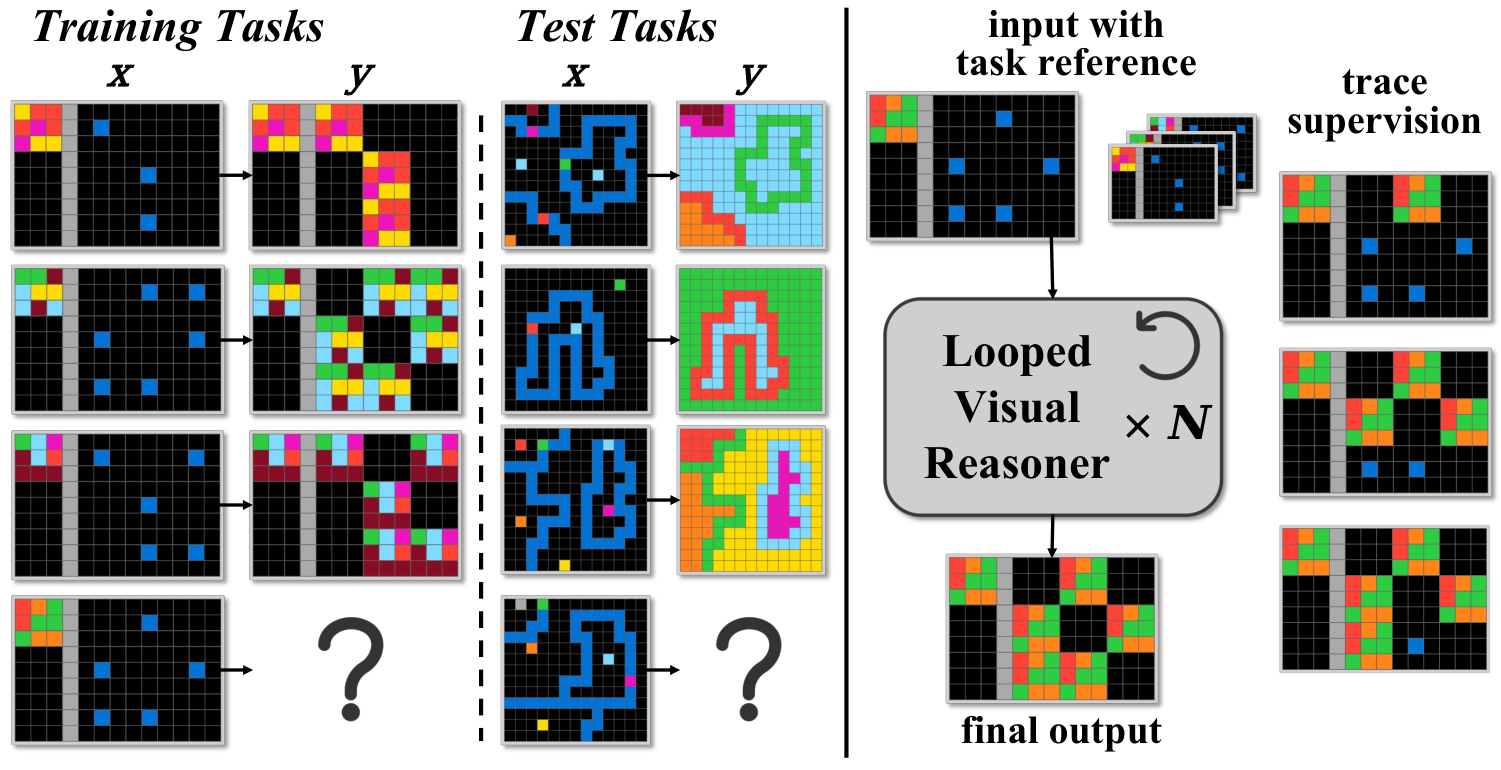
发表于近期的一项研究提出了 TraceViT。它的核心主张看似直观:既然人类在纸上推理时是逐步绘制草图,循环视觉模型的中间迭代也应当沿着一条语义连贯的“轨迹”逐步推进。然而,该研究揭示了一个反直觉的现象:如果在循环模型中直接对中间状态施加轨迹监督,模型表现不仅不会提升,反而会直接掉点。
研究团队发现,循环模型的隐状态既要充当保存输入规则的“工作记忆”,又要充当被不断覆写的“计算草稿纸”。一旦强行将中间状态拉向部分解,输入记忆就会被严重冲刷,导致后几步彻底失控。为此,TraceViT 构建了一套由“语义单调变换链”、“双重接地解耦”与“软轨迹动态规划对齐”组成的闭环体系。在 ARC-AGI-1 评测集上,TraceViT 取得了 67.8% pass@2 的优异成绩,在大幅缩减推理复杂度的同时显著拉高了紧凑型视觉推理的上限。
为什么循环模型需要“单调轨迹”,又从何获取?
ARC 任务要求模型从极少量的示例(通常仅 2 到 4 对输入输出网格)中归纳出未见过的抽象规则,并在全新的测试输入上绘制出完全匹配的网格。这里的容错率极低:只要有任意一个格子的颜色或尺寸出现偏差,整个题目便得零分。
人类在解决这类网格谜题时,往往会将复杂操作拆解为一系列子目标:先清除干扰色块、再识别连通分量、最后沿中心对称复制。然而,深度循环模型在终点监督下,往往倾向于在隐空间中走捷径,在最后一两步突然“坍缩”出答案。这种训练方式浪费了迭代计算的潜力,更导致模型泛化极不稳定。
如果要在训练中监督中间过程,最直观的瓶颈在于:中间状态的目标网格从何而来?
人类求解的交互轨迹极其稀缺且无法大规模采样;而语言形式的思维链(CoT)虽然丰富,却无法直接映射为严谨的像素级中间网格。
为此,研究者们转向了程序化任务生成器(如 RE-ARC 与 ARC-GEN)。这些生成器本质上是用代码逐步构造答案的,但原始程序的执行流充满了副作用:一段代码可能在一次函数调用中同时完成三项修改,或者包含大量无语义的辅助回溯。作者团队对底层程序进行了彻底的重写与自动化验证,提取出语义单调变换链(Semantically Monotonic Transformation Chains):
\[x=T_{0}\;\rightarrow\;T_{1}\;\rightarrow\;\cdots\;\rightarrow\;T_{K}=y\]在这条链中,每一个里程碑网格 $T_k$ 都代表向最终答案迈进的一个具备明确语义的操作(例如“移动物体到边界”或“为内部连通域着色”),且绝不走回头路。针对 ARC-AGI-1,研究团队重构了 RE-ARC 400 个任务中的 40 万个样本对,成功提取出 270,854 条高质量单调轨迹;而在 ARC-AGI-2 上,则构建了超过 87 万条轨迹的训练语料。这为紧凑视觉推理提供了前所未有的大规模过程级像素监督。
破局核心:用“任务参考”与“物体工作区”实现记忆解耦
有了中间网格,直接对中间循环施加交叉熵损失会发生什么?实验给出了令人警醒的答案:在未做特殊结构设计时,增加轨迹监督会导致 pass@2 从 62.3% 跌落至 61.6%。
深入分析其表征机制后,原因十分清晰:在传统的循环视觉主干(如 LoopViT)中,单一样本的隐状态承担着双重冲突角色。它既需要记住原始测试网格 $x$ 的未变换状态以及示范样本中的全局规则,又要作为承载当前计算步的“画布”。一旦损失函数强行拉扯中间循环步去匹配某个中间网格 $T_k$,隐状态中保存的原始空间结构就会被过早污染,后续循环迭代将因失去初始参照而“精神分裂”。
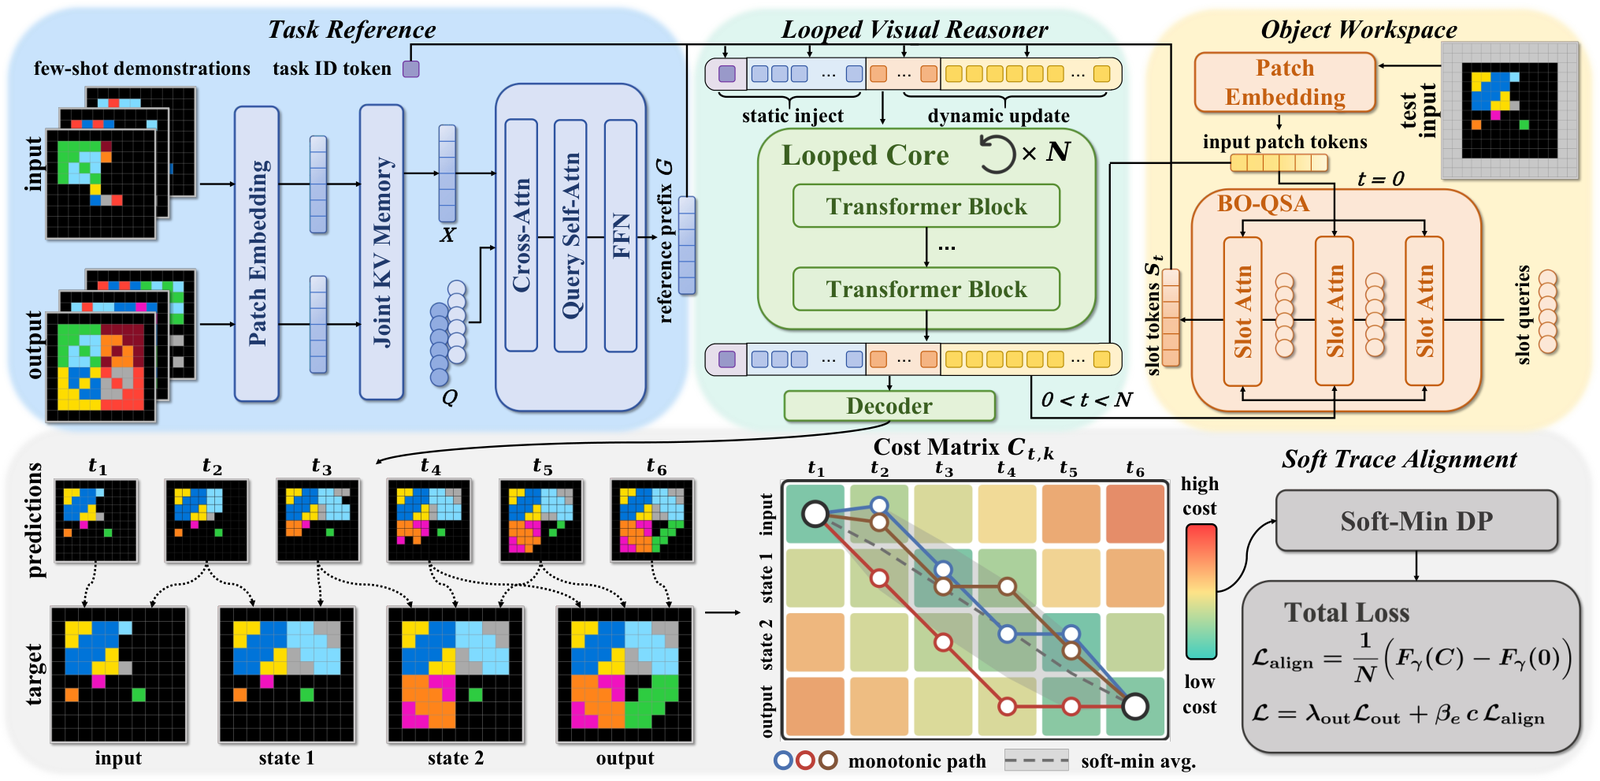
TraceViT 解决该矛盾的机制并非修改损失函数权重,而是通过结构重塑将“记忆”从循环隐状态中彻底剥离出去,分别构建了静态的任务参考(Task Reference)与动态的物体工作区(Object Workspace):
-
静态任务参考($G$):
Few-shot 演示不仅包含输入,还包含输出。模型使用统一的视觉编码器抽取所有示范样本特征,通过拼接角色嵌入(输入还是输出)与样本索引,组装成联合上下文 $X$。接着,利用 128 个可学习查询向量 $Q = [Q_{\mathrm{a}}; Q_{\mathrm{f}}]$ 与 $X$ 进行两轮交叉注意力交互。其中 64 个查询 $Q_{\mathrm{a}}$ 初始化自 $8 \times 8$ 的二维网格空间锚点,保证空间覆盖率;另 64 个查询 $Q_{\mathrm{f}}$ 自由捕捉跨区域规则关系。最终生成的 128 个参考 Token $G$ 在整个推理循环中保持冻结,并在每一轮循环迭代 $t$ 开始前,重新注入到视觉主干中。这意味着模型不再需要用隐状态死记硬背示范规则,每一轮计算都能“抬眼看到”原始规则。
-
动态物体工作区($S_t$):
大部分 ARC 规则本质上是在对离散物体执行计数、平移或属性重着色,而标准的 Vision Transformer Patch 很难显式建模物体的整体性。TraceViT 引入了基于 Slot Attention 的动态槽位库 $S_t$。在每一轮循环后,槽位网络与当前 Patch 表征进行竞争性注意力计算,抽取出解耦的物体级槽位,并传递给下一轮循环迭代 $t+1$:
这一双重接地(Grounding)机制彻底解放了循环核 $F$:静态参考 $G$ 钉死了抽象规则,动态槽位 $S_t$ 锁定了物体边界,隐状态 $h_t$ 得以毫无顾忌地朝向中间网格变换,再无后顾之忧。
软轨迹对齐:给模型自主分配计算步长的自由
在解决了表征解耦后,工程实现上面临的另一个尖锐矛盾是:真实解题所需的变换步数 $K$ 与模型固定的循环迭代次数 $N$ 往往并不相等。
有些简单规则只需 2 步变换,但循环网络总共设置了 $N=6$ 步;有些极难的任务包含 8 步变换,循环步数甚至小于里程碑数量。如果采用朴素的固定间隔对齐(例如强行规定第 1 次循环匹配第 1 个里程碑、第 2 次循环匹配第 2 个里程碑),模型就会被迫在不合理的时间节点强行拟合,破坏学习动态。
TraceViT 提出了软轨迹对齐(Soft Trace Alignment)算法。它不对任何单一步骤做强行绑定,而是仅约束“演化顺序必须单调向前”,将步长分配的主动权完全交给模型自身。
算法首先计算循环步预测结果与轨迹里程碑之间的成本矩阵 $C_{t,k}$。这里还隐藏着一个极具洞察力的设计——变化加权(Change-weighting)。在 ARC 中,一个 $30 \times 30$ 的网格通常绝大部分都是背景,两个相邻里程碑之间往往只修改了十几个像素。如果不加干预,模型即便什么都不做,光靠拟合占绝对多数的未变化格子就能获得极低的交叉熵损失。为此,研究者对发生变化的像素施加了惩罚加权因子 $\alpha$:
\[w_{k}(i) = 1 + \alpha\,[\,T_{k}(i) \neq T_{k-1}(i)\,]\] \[C_{t,k} = -\frac{\sum_{i\in\Omega_{k}}w_{k}(i)\log p_{t}\bigl(i,T_{k}(i)\bigr)}{\sum_{i\in\Omega_{k}}w_{k}(i)}\]在成本矩阵建立后,模型利用平滑极小值动态规划($\mathrm{softmin}$-DP)在所有允许的单调递增路径 $\Pi_{N,K}$ 上进行边际化边缘积分:
\[V_{t}(k) = C_{t,k} + \mathrm{softmin}_{\gamma}\bigl\{V_{t-1}(k{-}1),\,V_{t-1}(k)\bigr\}\] \[\mathcal{L}_{\mathrm{align}} = \frac{1}{N}\Bigl(F_{\gamma}(C) - F_{\gamma}(\mathbf{0})\Bigr)\]通过这一可微分对齐损失,训练初期所有合规路径贡献相近,呈现出沿着对角线平滑分布的均匀引导;随着训练深入,模型可以针对特定任务自行决定:是前 3 轮循环都在酝酿局部特征、在第 4 轮跨越式完成绘制,还是均匀平摊计算量。
实验印证:1+1 远大于 2 的消融验证
TraceViT 的有效性在控制变量实验中得到了极为清晰的验证。在 ARC-AGI-1 上,针对 TraceViT-Medium 的消融实验构建了一个极其严谨的 $2 \times 2$ 因子对比矩阵:
-
基线模型(无轨迹监督,无接地记忆):pass@2 为 62.3%。
-
孤立引入轨迹监督(无接地记忆):pass@2 骤降至 61.6%(下降 0.7 个百分点)。这一负向结果强力支撑了前文的理论假设:直接施加中间损失,会严重冲散未解耦的隐状态记忆。
-
孤立引入接地记忆(仅终点监督):pass@2 提升至 63.9%,证明显式提供任务规则与 Slot 物体表征本身就对推理大有裨益。
-
二者结合(TraceViT 完整版):pass@2 一举跃升至 65.5%!
在保持训练集样本总量与多样性完全相同的前提下,软轨迹对齐带来了净增 1.6 个百分点 的纯算法增益。不仅如此,针对细节模块的对照实验也验证了设计的周全性:
-
去掉像素变化加权(令 $\alpha=0$),精度跌至 64.3%,证明未变化背景的梯度噪声确实会严重干扰里程碑拟合;
-
将软对齐退化为死板的固定步长间隔对齐,精度降至 64.4%;
-
若在训练第 40 个 Epoch 后移除中间轨迹损失(即把轨迹仅仅当成前期热身脚手架),精度大幅下滑至 63.6%,这说明单调轨迹监督在模型的整个收敛周期中都在持续提供正则化指引。
在更大的 TraceViT-Large 模型上,最终在 ARC-AGI-1 官方验证集上斩获了 67.8% pass@2,在同等参数量级的紧凑视觉求解器中建立了显著的优势;即便在被公认为极度苛刻、由多层复合交互规则构成的 ARC-AGI-2 上,也取得了 24.3% 的成绩。
过程可视化:循环网络在每一轮中究竟学到了什么?
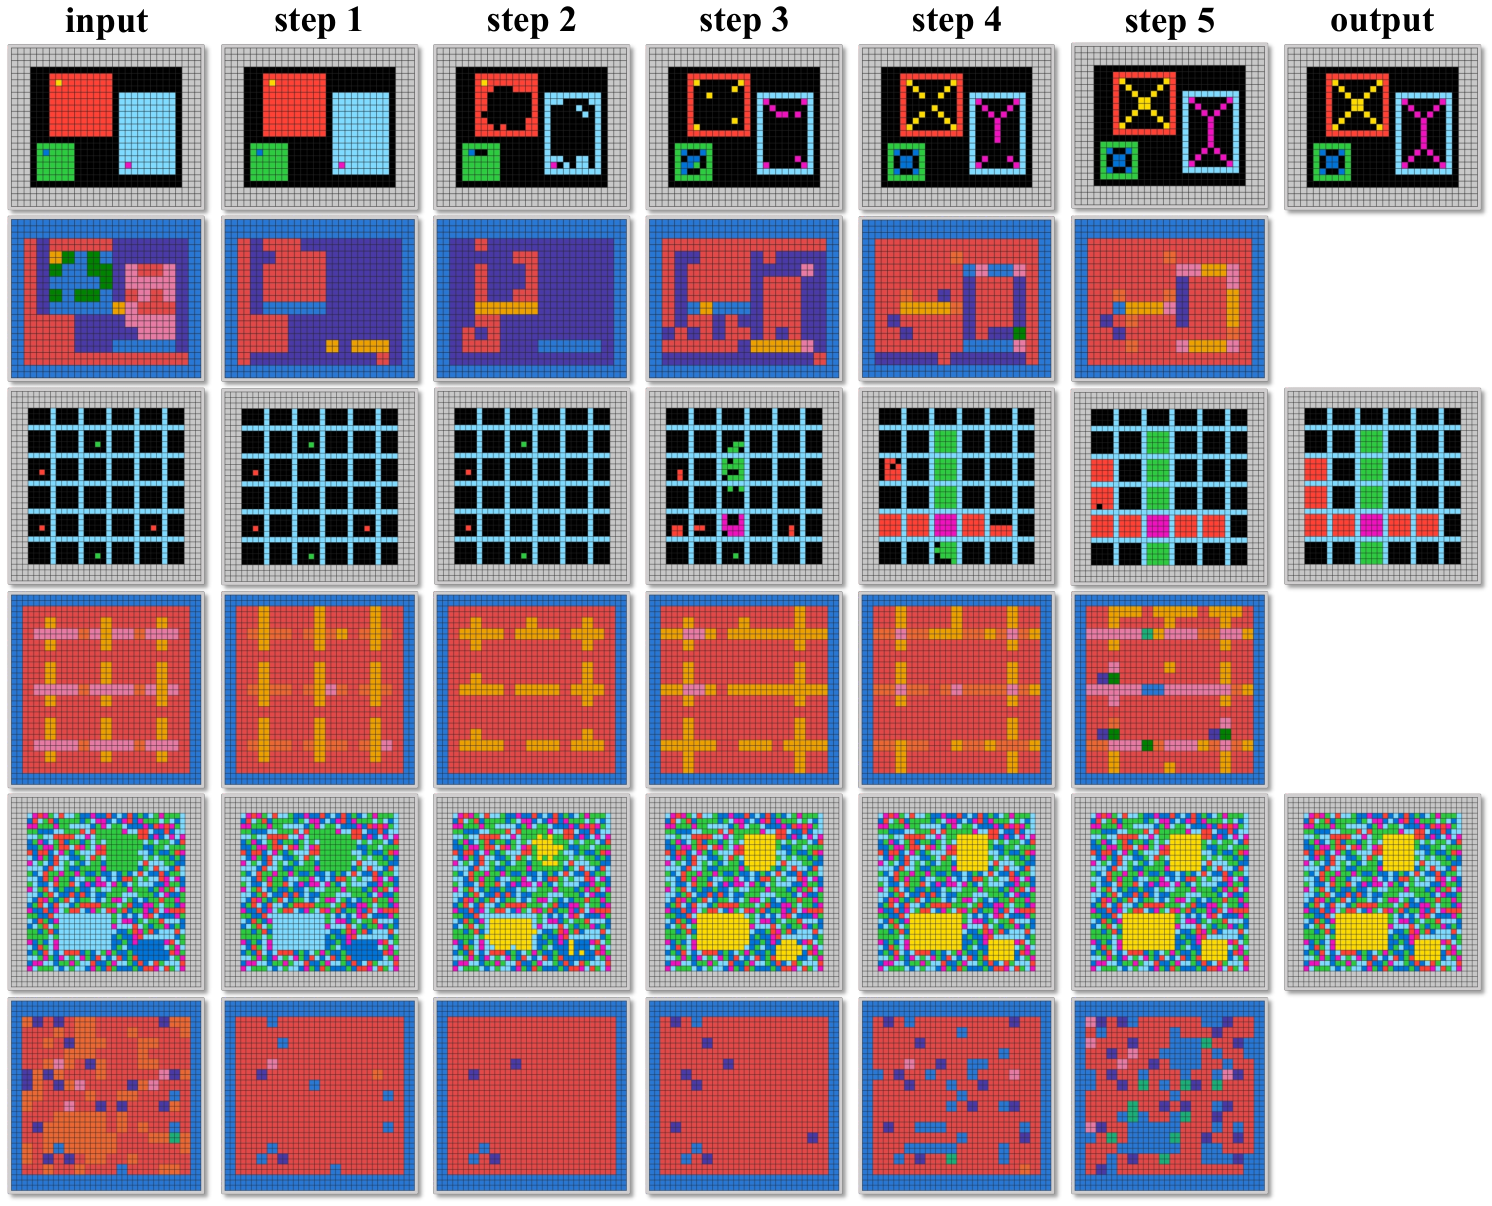
为了探究模型是否真正掌握了分阶段求解的能力,研究团队对测试推理过程中的逐层输出及 Slot 注意力分配进行了可视化提取。
从可视化的三道典型谜题中可以观察到令人惊叹的模式演变。例如在图中的第一道任务中,模型的目标是将三个内部带有色点的方框填充上对应的重复几何图案:
-
前两轮循环(Step 1–2):模型并非直接乱涂图案,而是自发进入“清理阶段”,先将方框内部原有的杂色与背景全部清空;
-
后四轮循环(Step 3–6):模型进入“绘制阶段”,依次在洁净的画布上生长出精准的对称纹样。
与之同步演化的 Slot 工作区展现了高度自主的语义分工。在所有任务中,8 个槽位中有 2 个槽位自发固定为全局功能:一个固定捕获网格外的 Padding 边缘,另一个牢固锁定整个画布的基础背景色。其余 6 个槽位则动态扑向变换活跃区域。在上述任务的清理阶段,活跃槽位呈现出粗粒度的空间二分;一旦进入绘制阶段,槽位迅速裂变细化,精准包裹住方框的内轮廓与纹样笔划。这雄辩地证明:模型内部确实涌现出了分阶段、由粗到细的模块化视觉程序。
瓶颈溯源:紧凑视觉推理下一步该往哪里走?
在传统基于测试时增强(TTA)的多视角投票策略下,模型通常会对每个测试输入生成数百个候选(TraceViT 使用了 510 个视角增强),再通过投票选出最高频的 Top-2 网格作为最终提交。
TraceViT 团队对评测误差进行了深入的“Oracle vs Pass@2”分解剖析:
-
正确答案排在 Top-2 内的任务占比为 67.8%;
-
正确答案被生成出来、但投票排名落在 2 名之外(有解但未挑中)的任务占比仅为 8.5%(二者相加构成 76.3% 的 Oracle 理论上限);
-
正确答案在全部 510 个视图中完全未曾出现的任务占比高达 23.8%。
这意味着,当前系统的主要误差源并非后端的“重排与筛选机制”(Selection Gap,仅占 8.5%),而是前端视觉求解器本身的“覆盖能力断层”(Coverage Error,占残差的近四分之三)。由于模型对每个视图的解码是确定性的,投票只能汇聚已有概率,绝不可能无中生有。在模型完全无法覆盖的任务上,暴露出的不仅是计算预算不足,而是面对高度复杂的全局符号抽象时,单次前向循环的表达能力边界。
总结
TraceViT 的突破为紧凑视觉推理领域提供了一个清晰的方法论样本:给深度循环计算提供过程监督是极其有效的,但前提必须是对状态表征进行严谨的功能解耦。
通过将“静态规则”留给任务参考、将“空间物体”托付给 Slot 工作区、将“推进节奏”交由软对齐动态规划,TraceViT 在无需依赖庞大参数堆叠的前提下,成功逼出了视觉 Transformer 在多步空间推理上的深层潜能。它不仅为 ARC 求解器开辟了全新路径,更为所有涉及多步链式演化的视觉生成与连续状态规划任务,提供了一套极具推广价值的架构范式。