VidMap:时序约束碰撞全局SfM,苏黎世联邦理工等攻克长视频度量重建
VidMap: Exploiting Temporal Structure for Video-Based Structure-from-Motion
在具身导航、空间计算以及三维世界模型构建中,从随手拍摄的普通非受约束(unconstrained)视频中精确解算相机内参、度量尺度轨迹与场景几何,是构建海量三维训练数据的基石。然而在过去数十年里,这一领域始终被两套割裂的范式所主导:实时递推的视觉 SLAM 与离线无序的运动恢复结构(Structure-from-Motion, SfM)。这两者各自存在结构性的软肋。
ArXiv URL:https://arxiv.org/abs/2607.27194v1
视觉 SLAM 属于严格的因果系统(causal system),必须按时间步顺序逐步估计位姿。这种“一次性决策”的增量机制极度依赖精准的初始化,一旦遇到剧烈抖动、纯旋转等退化运动(degenerate motions),或者遇到局部纹理缺失,就会产生无法修复的跟踪丢失与漂移;更致命的是,绝大多数 SLAM 框架必须预知精确的相机内参。离线 SfM 恰恰相反,它将全局优化置于首位,能够同时联合解算所有相机的位姿与内参。然而,传统 SfM 建立在无序图像集假设之上,完全忽视了视频天然的时序连续性。面对室内走廊、重复立柱等强视觉对称场景,图像检索很容易建立错误的跨视角匹配,无序特征轨迹的传递闭包(transitivity)会将错误无限放大,导致重建物体折叠或严重形变。
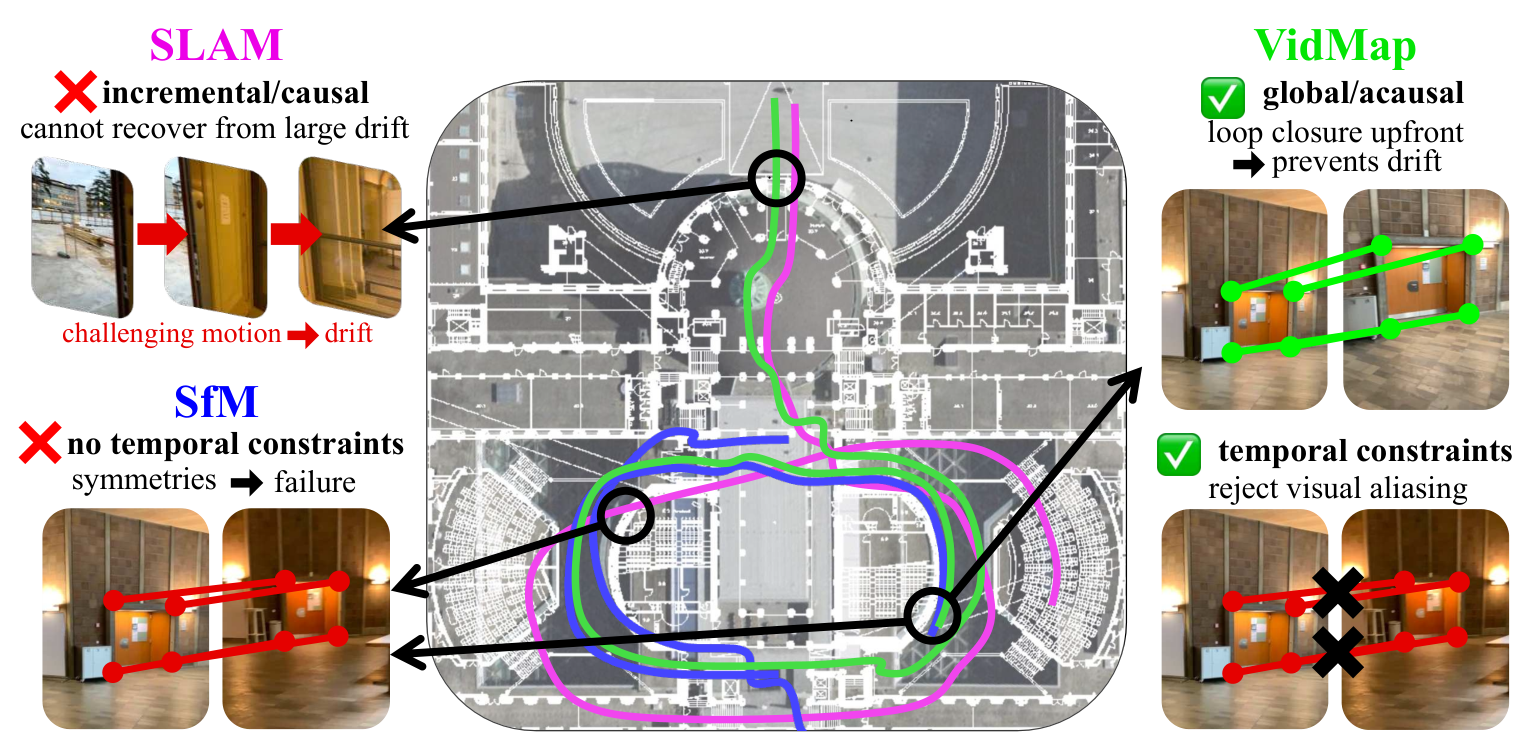
来自苏黎世联邦理工学院(ETH Zurich)、Google 与微软(Microsoft)的研究团队提出了 VidMap。该框架并没有在原有路径上做缝缝补补,而是系统性地将 SLAM 的时序约束与全局 SfM 的全局鲁棒优化结合在一起。它将时间顺序视为核心先验,利用最新广基线稠密匹配算法提取带有协方差的长程特征轨迹,并在全局优化中引入了时序来源追踪(provenance awareness)与度量单目深度先验。即使在完全未标定、存在极端运动和强对称混淆的超长复杂视频上,VidMap 依然展现出远超传统与前馈学习方案的重建稳定性。
割裂的困局:因果递推与无序优化的两难
理解 VidMap 的价值,首先要看清 SLAM 与 SfM 在视频处理上的结构性死结。
视觉 SLAM 之所以脆弱,本质上受制于因果递推架构。系统在当前时间步只能利用过去的观测,强行对当前位姿与局部地图做即时提交(commitment)。在无人机急转弯、手机快速晃动或低视差前进运动中,几何约束处于严重欠定状态,引入的微小误差会被后续增量步骤层层累积。即便系统带有回环检测(Loop Closure),回环也仅仅能够拉回当前的轨迹偏移,却很难逆转此前已经固化进地图拓扑中的退化几何结构。这种为了追求实时性而紧耦合各个模块的设计,也让它很难灵活接纳深度学习带来的现代密集表征。
全局 SfM 虽然拥有全局优化的后验优势,但其核心假设是“图像无序”。这意味着算法对待时间上相邻的帧对,与对待时间跨度极大的回环帧对完全一视同仁。在视觉走廊、对称建筑外观这类具有视觉混淆(visual aliasing)的场景中,不同位置的相同纹理会被特征匹配网络误认为同一三维点。当 SfM 将这些点连接成多视角轨迹时,错误的拓扑结构便彻底污染了平差系统,造成不可挽回的重投影发散。
近年来兴起的前馈大模型(如基于注意力机制直接预测位姿与点云的端到端网络)虽然展现了极佳的上下文感知能力,但在处理超长视频时会遭遇显存瓶颈。若通过切块对齐(chunked alignment)或流式融合(streaming fusion)扩展序列,又会重新退化为缺乏不确定度传播的增量累积系统。VidMap 的出发点正是明确分工:让深度学习模型专精于局部稠密匹配与度量深度估计,而让严格的显式几何优化来承担长程全局精度与可扩展性。
重构前端:带协方差的多流漂移修正与来源分离
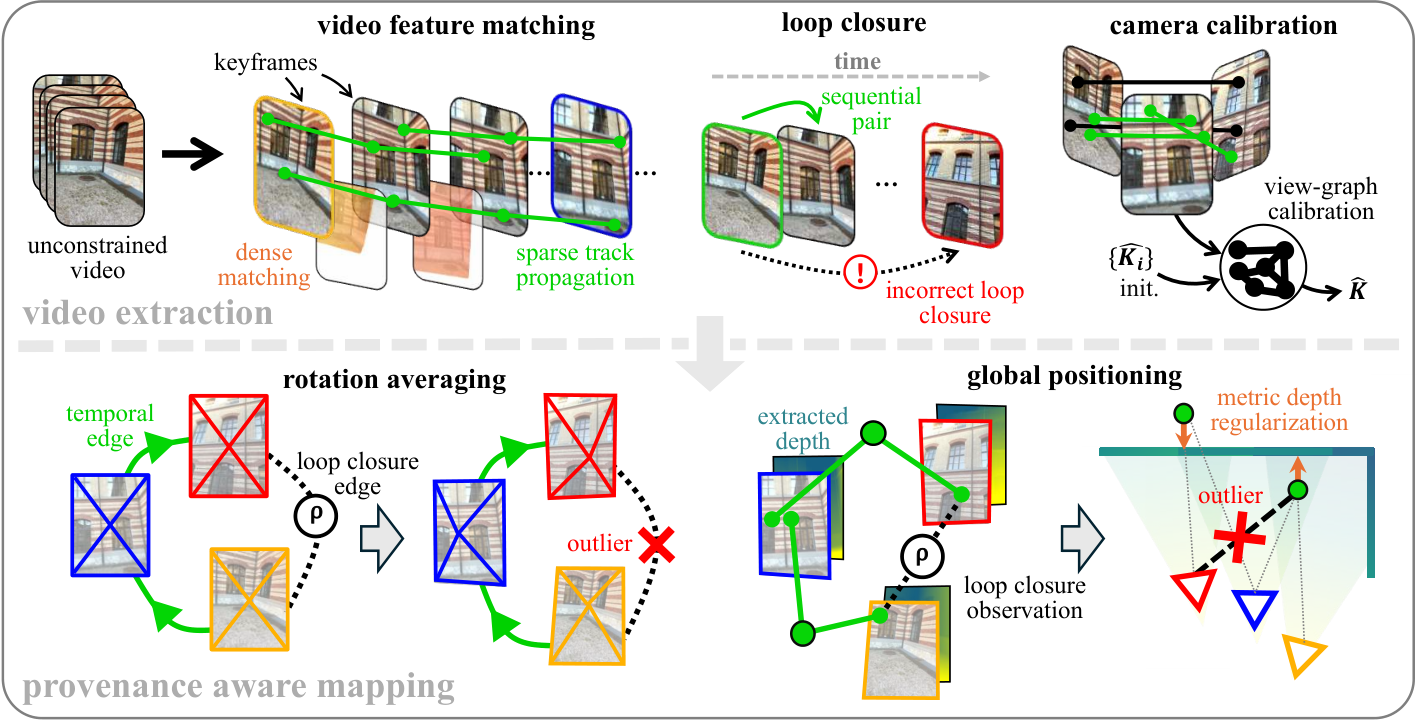
VidMap 将整个流程解构为两大核心阶段:视频感知的前端特征提取与带来源追踪的全局建图。
在前端匹配阶段,视频带来了一个最关键的物理保障——相邻帧之间具备极高的空间重叠度,局部不存在全局多义性。传统的稀疏特征点在低纹理区域(如白墙、地面)极易丢失,而 VidMap 选用现代由粗到精的稠密匹配模型(Coarse-to-fine dense matcher)。对于相邻两帧 $I_a$ 与 $I_b$,匹配网络输出每像素的稠密流场 $\mathcal{W}{a\to b}$、置信度 $c{a\to b}$ 以及局部定位协方差 $\Sigma_{a\to b}\in\mathbb{R}^{2\times 2}$。
如果仅仅按时间步一帧帧将光流串联传递,定位误差仍会随着步数线性发散。为此,VidMap 借鉴 SLAM 的滑动窗口思想,设计了多流漂移修正机制(Multi-flow drift correction)。当系统确定一个新的关键帧 $\mathcal{K}i$ 时,算法不仅计算前序关键帧 $\mathcal{K}{i-1}$ 到当前帧的顺序预测 $\hat{\mathbf{x}}_i^{\text{seq}}$,还会回溯一个局部时间窗口 $\mathcal{J}_i={k\mid i-W\le k < i}$ 内的所有前向锚点帧。
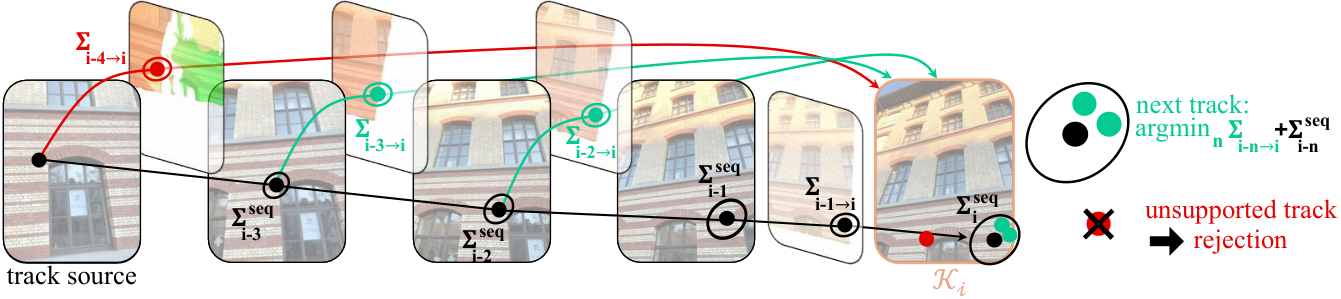
对于窗口内任一历史帧 $j$,直接匹配到当前帧得到的候选点预测为 $\hat{\mathbf{x}}i^{(j)}=\mathcal{W}{j\to i}(\mathbf{x}j)$,其传递协方差为该轨迹历史累计协方差与当前边协方差之和 $\Sigma_i^{(j)}=\Sigma_j^{\text{seq}}+\Sigma{j\to i}$。系统首先挑选协方差迹(trace)最小的候选帧 $j^*$:
\[j^* = \arg\min_{j\in\mathcal{J}_i} \operatorname{tr}\left(\Sigma_i^{(j)}\right)\]非相邻帧的匹配虽然几何基线更长、定位方差理论上更小,但更容易受视觉歧义干扰。因此,VidMap 设置了一道严苛的一致性检验门槛:候选预测必须与紧邻帧的顺序预测 $\hat{\mathbf{x}}_i^{\text{seq}}$ 在统计意义上充分吻合,才被采纳;一旦发生冲突,系统立刻回退到最安全的顺序预测上:
\[\mathbf{x}_i = \begin{cases} \hat{\mathbf{x}}_i^{(j^*)}, & \text{if } \left\|\hat{\mathbf{x}}_i^{(j^*)} - \hat{\mathbf{x}}_i^{\text{seq}}\right\|_2^2 < \tau \operatorname{tr}\left(\Sigma_i^{(j^*)}\right) \\ \hat{\mathbf{x}}_i^{\text{seq}}, & \text{otherwise} \end{cases}\]在此基础上,VidMap 颠覆了传统全局 SfM 构建轨迹的方式。在寻找非时序连接的长程回环(Loop Closure, LC)时,系统利用全局检索网络提取图像描述子并做几何验证。但与标准 SfM 无脑合并特征轨迹不同,VidMap 严格禁止将回环匹配通过传递律合并进时序轨迹中。凡是由相邻帧逐步追踪生成的观测点,被打上时序标签 $l_{ik}=\text{seq}$;而通过图像检索匹配得到的回环观测点,则被作为独立分支打上回环标签 $l_{ik}=\text{lc}$。这种在数据层保留时序来源的做法,为后端的鲁棒容错提供了决定性支点。
来源感知优化:彻底瓦解视觉对称与退化尺度
后端优化的核心是扩展的 GLOMAP 架构。传统全局 SfM 的全局定位(Global Positioning, GP)严重依赖多视角视线向量(bearing vectors)的交叉交汇。然而在单目视频中,沿光轴向前移动(forward motion)会导致极小的视差角度,纯旋转运动更是会导致三维点无法三角化,造成尺度漂移和几何崩溃。
VidMap 在旋转平均(Rotation Averaging)与全局定位阶段全面引入了来源依赖的损失函数与单目度量深度先验。
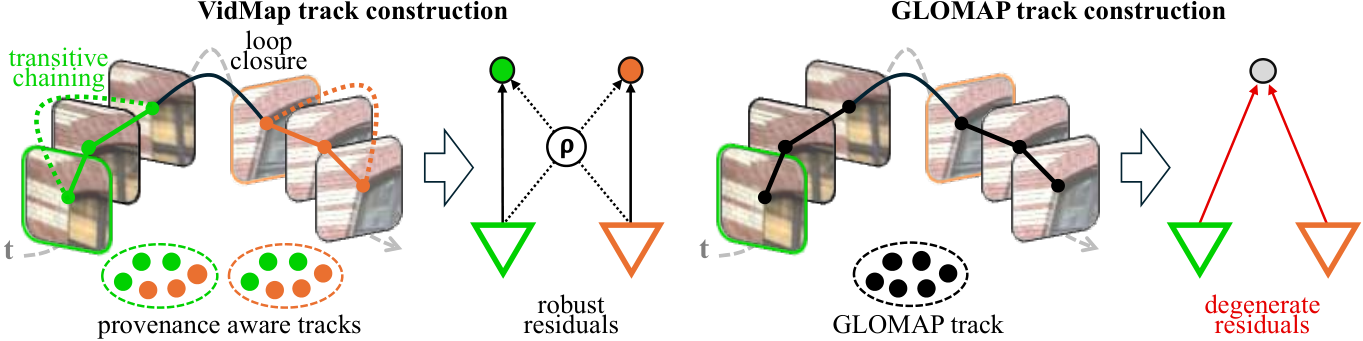
在旋转平均中,相对旋转由相邻匹配和回环匹配共同提供。VidMap 对时序边赋予更信任的 Huber 损失,而对可能潜藏视觉混淆的回环边赋予抑制力极强的 Cauchy 损失。如图所示,当环境出现重复走廊立柱时,错误的跨回环约束在柯西核函数的强力下采样惩罚下被自动隔离为外点,确保初始全局朝向 ${R_i}$ 不被带偏。
进入全局定位后,系统不仅需要求解相机中心 ${c_i}$ 与空间稀疏点 ${X_k}$,还显式为每一个关键帧引入了一个独立的深度尺度缩放因子 $s_i$。这是因为单目深度估计模型(如基于 ViT 的深度估计)虽然具备极强的相对与度量形状先验,但在视频不同时间步仍然存在微小的尺度跳变。VidMap 构造的全局定位能量函数形式如下:
\[E_{\text{GP}} = \sum_{(i,k)} \left[ \rho_{l_{ik}}^{\text{GP}}\left( {\mathbf{e}_{ik}^{\text{GP}}}^\top {\Sigma_{ik}^{\mathbf{v}}}^{-1} \mathbf{e}_{ik}^{\text{GP}} \right) + \rho_{l_{ik}}^{\text{depth}}\left( \frac{r_{ik}^{\text{depth}}}{\sigma_{ik}} \right) \right] + \sum_i \rho^{\text{scale}}\left( \frac{r_i^{\text{scale}}}{\sigma_{s,i}} \right)\]这个优化目标由三组精密协作的残差构成:
-
视线残差(Bearing Residual):$\mathbf{e}{ik}^{\text{GP}} = \mathbf{v}{ik} - d_{ik}(X_k - c_i)$,衡量全局相机射线与估计空间点方向的夹角。值得注意的是,特征提取阶段传出的二维像素协方差 $\Sigma_{ik}$,在这里通过雅可比矩阵 $J_i$ 严格映射至三维视线切空间,生成协方差矩阵 $\Sigma_{ik}^{\mathbf{v}} = J_i \Sigma_{ik} J_i^\top$,实现了按测量不确定度的精确加权。
-
深度残差(Depth Residual):设空间点在相机坐标系下的逆投影深度为 $z_{ik} = \mathbf{e}3^\top R_i (X_k - c_i)$,单目深度先验为 $m{ik}$,其不确定度为 $\sigma_{ik}$。当深度位于相机前方时,系统在对数空间进行残差比对:$r_{ik}^{\text{depth}} = \log\left( \frac{z_{ik}}{s_i \cdot m_{ik}} \right)$,有效平抑了远近景深误差不均衡的问题。
-
尺度正则项(Scale Regularizer):$r_i^{\text{scale}} = \log s_i$,限制单帧尺度因子的过度畸变。
在损失函数选择上,$\rho_{l_{ik}}^{\text{GP}}$ 与 $\rho_{l_{ik}}^{\text{depth}}$ 严格根据观测来源动态配置:时序轨迹继续使用连续凸性更好的平滑核,而回环轨迹则采用重尾惩罚核。即使回环检索拉进了一组看似相似但实际相隔数个房间的错误特征,其残差在迭代几轮后便会被强力截断,根本无法扰乱已有的局部轨迹。
在未知内参的场景下,VidMap 采用分级自标定策略:先由 GeoCalib 独立预测各帧内参,选出高置信度帧联合拟合共享焦距,再利用视线图(view graph)基础矩阵作全局几何精炼,最终将所有位姿、内参、三维坐标及尺度因子送入最终的光束法平差(Bundle Adjustment, BA)进行联合微调。
极端场景实测:复杂退化与无序废墟的压力测试
评测视频三维重建的鲁棒性,传统的平稳短序列数据集早已饱和。研究团队将 VidMap 推上了两个极具挑战性的高难度基准:LaMAR 与 CroCoDL。
LaMAR 是目前极具代表性的 AR 与手持设备室内基准,包含大型复杂室内场景(如苏黎世联邦理工主楼、机械楼等)。数据全部由普通用户手持手机或 AR 眼镜录制,充斥着剧烈晃动、低视差原地转向、极低纹理的白墙与天花板,以及极为严重的重复立柱和走廊对称性。CroCoDL 则采集自四处完全未建构的废墟和灾后损毁建筑,轨迹由轮式机器人和手持设备录制,不仅运动急剧颠簸,废墟表面更缺乏规则的几何结构,足以让依赖传统特征角点的系统全线崩溃。
在 LaMAR 的 50 个高难度长序列评估中,评估指标采用不同长度时间窗口下的平移误差曲线下面积(AUC,数值越大越好)。实验同时对比了工业级经典 SLAM(ORB-SLAM3)、学习型神经 SLAM(Droid-SLAM)、前沿全局/增量 SfM(COLMAP、GLOMAP、MP-SfM)以及前馈端到端重建大模型。
实验数据表明,在已知内参的严苛条件下,针对长序列窗口的位姿估计,传统基准模型均出现严重断崖式下跌:
-
Droid-SLAM 由于依赖局部因果记忆,在面对大范围视线转换和回环时频繁跟踪丢失,AUC 严重受限;
-
经典全局 SfM 代表 GLOMAP 因无法过滤对称回环外点,在多个序列中直接发生了地图拓扑折叠;
-
端到端模型如 DUSt3R 受限于上下文长度,在视频过长时必须依靠切块拼接,累积漂移显著增加;
-
VidMap 在该测试集上斩获了全方位的领先指标,位姿 AUC 展现出断层式优势。
更具实用价值的是在未知相机内参的极客设定下:绝大多数 SLAM 系统由于无法因果估计内参,在该设定下直接无法运行。传统 COLMAP 虽然具备自标定能力,但在长视频的复杂轨迹下计算极其缓慢且极易陷入局部极小值。VidMap 凭借 GeoCalib 与视线图联合初始化的策略,不仅顺利完成了所有长序列的闭环自标定,其位姿精度甚至逼近了已知真值内参时的水平。
消融实验进一步证实了各个模块不可替代的机理设计:
-
若去掉来源追踪(Provenance-awareness):在遇到对称建筑长廊时,旋转平均直接发生角度突变,回环误匹配会瞬间拉扯全局地图,导致轨迹变形。
-
若去掉多流漂移修正(Multi-flow):仅靠连续帧光流串联,前端轨迹在经历数十米长距离移动后会累积明显的横向漂移,导致回环检测阶段重投影误差过大而无法闭合。
-
若去掉单目度量深度注入:在相机沿走廊匀速直线向前推移的极低视差退化片段中,单纯的对极几何约束无法约束相机移动距离,轨迹发生极为严重的“风琴褶皱式”尺度伸缩,而度量深度因子的引入彻底锚定了轨迹的物理尺度。
统一范式的未来延伸
VidMap 的核心启发在于:视频既不是严格必须因果消耗的数据流,也不是缺乏时序关联的离散图像堆。
以往学术界往往将 SLAM 的“快”与 SfM 的“准”推向对立面。但 VidMap 证明,只要解除因果递推的实时枷锁,SLAM 沉淀多年的时序追踪先验(如动态关键帧挑选、多流协方差控制、时序高置信度)恰恰是治愈离线 SfM 视觉对称混淆与计算冗余的最佳良药;而全局 SfM 坚守的全局平差与不确定度传播,又是粉碎局部累积漂移的唯一科学路径。
随着 Sora 等视频生成模型与具身移动机器人的爆发,海量非结构化第一视角视频急需被转化为可交互的三维物理资产。VidMap 展示了一种优雅且高度可扩展的范式:深度学习大模型无需包揽几何计算的一切,它们负责把感知(光流追踪与单目深度预测)做到极致;而几何优化框架则汲取时序的拓扑先验,以极高的鲁棒性守住全局尺度与精度的底线。