Zing:从心理学评测到运行时外挂,大模型如何补齐“社交心智”?
Zing: Social Mind for LLMs
当大语言模型在代码生成、数学推演和长文本逻辑分析上不断逼近甚至超越人类基准时,一个极其尴尬的现象却在真实交互中频繁上演:模型能写出无可挑剔的代码,却在复杂的团队协作、委婉沟通或多方博弈中显得格外“低情商”。它可能会毫无顾忌地泄露对话背景中的私密信息,在面对讽刺与潜台词时只做字面理解,或者在多方利益冲突时给出一个效率最高却完全破坏人际信任的方案。
ArXiv URL:https://arxiv.org/abs/2607.23740v1
从孤立执行工具型任务,走向长期嵌入人类社会的协作智能体,大模型缺失的核心拼图正是社交智能(Social Intelligence)——即推测他人心理状态、追踪人际关系演变、权衡冲突规范并随境适应行为的能力。这篇题为《Zing: Social Mind for LLMs》的技术报告,系统性地提出了面向大模型“社交心智”(Social Mind)的完整工程与算法方案:代号为知境(Zing)的体系。
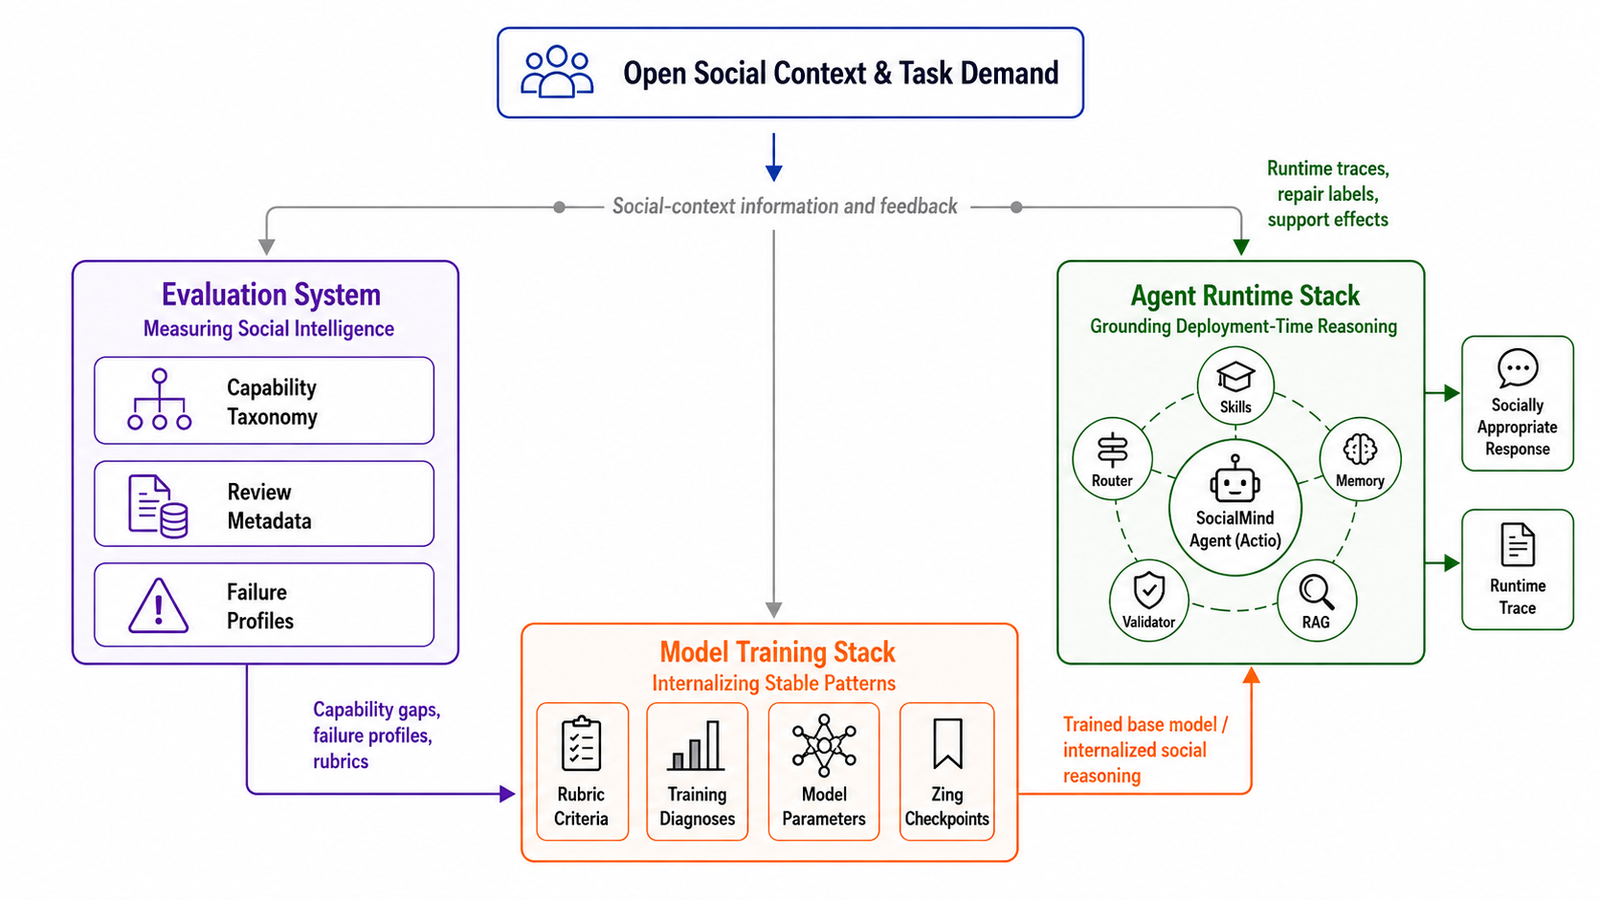
知境并没有停留在微调几句礼貌用语或做几道心智理论(Theory of Mind)单选题的表面功夫,而是把社交心智拆解为一个三位一体的闭环体系:
-
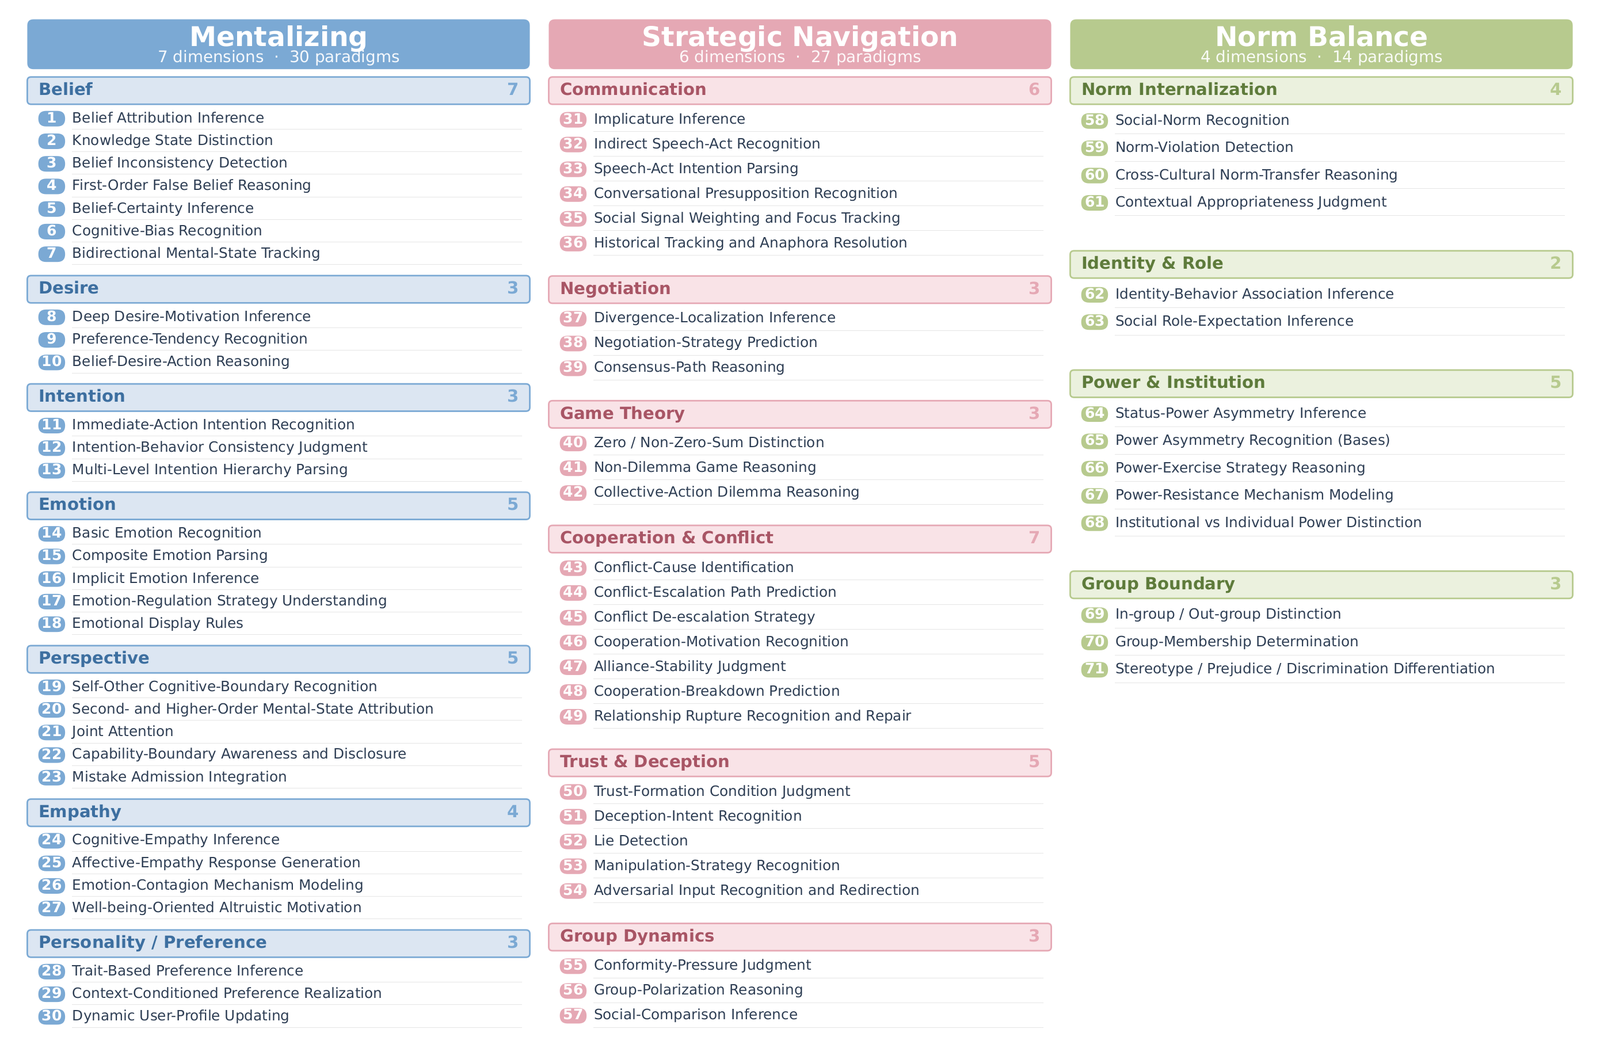
评测层(SoMBench):一个基于心理学系统构建的基准,设立 3 个一级维度、17 个二级维度和 71 个任务范式,对当前主流的 20 个大模型展开“压力测试”,发现即使是表现最好的闭源旗舰,综合准确率也仅有 72.08%,没有任何一个二级维度能摸到 90% 的天花板。
-
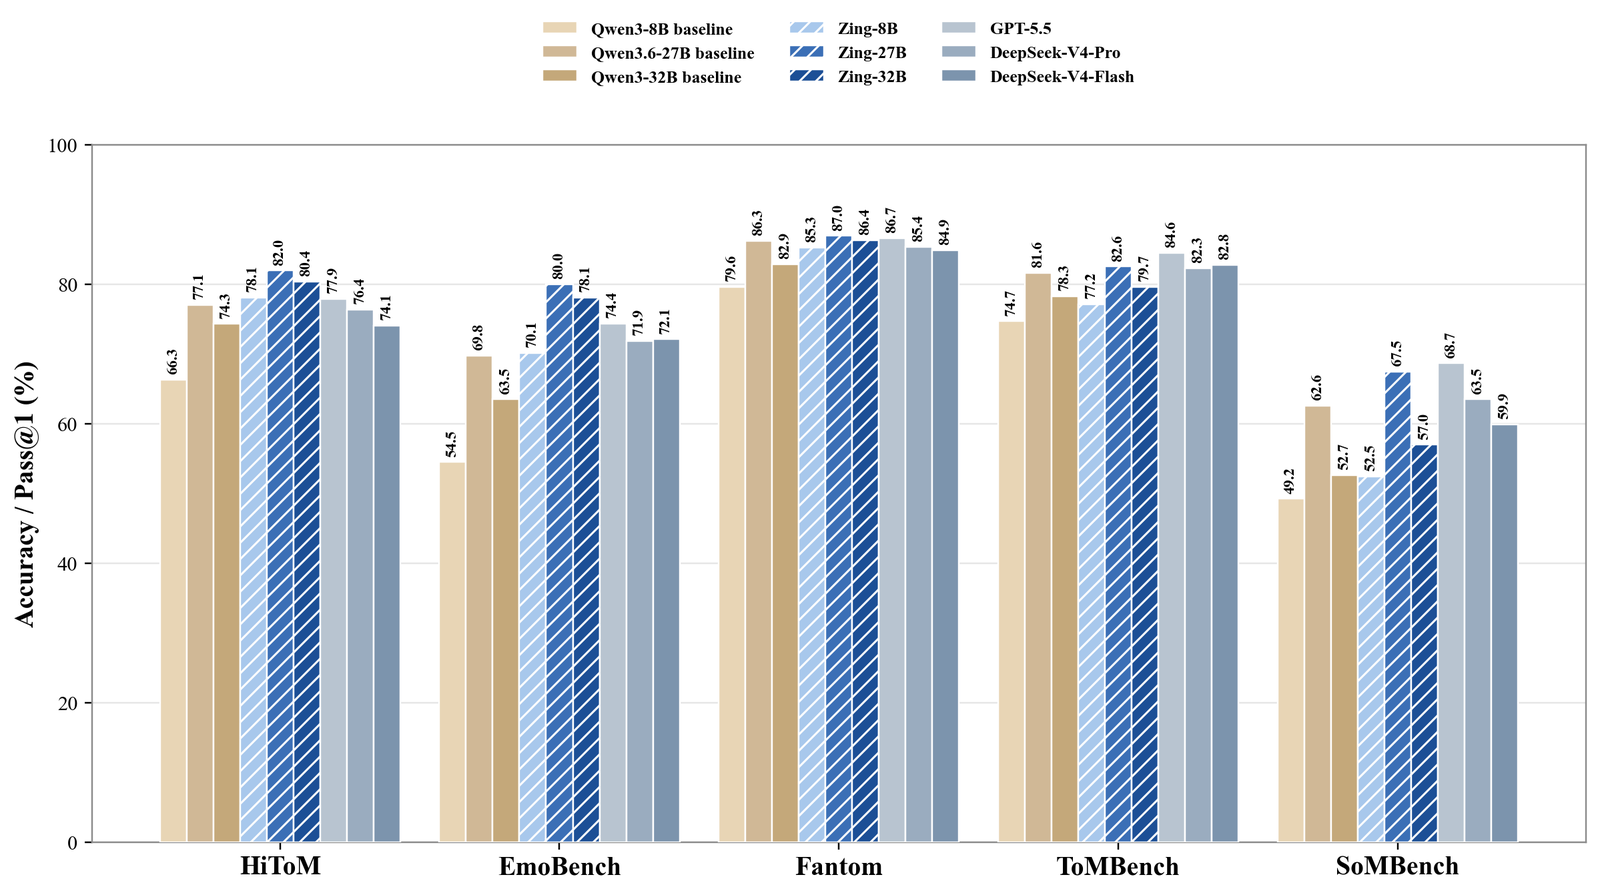
内化层(Zing 训练配方):结合有监督微调(SFT)、同策略蒸馏(On-Policy Distillation)以及基于评价量规的强化学习(Rubric-based RL),让社交推理能力沉淀进基座权重,在五个社交认知基准上显著超越同规模基座模型。
-
外挂落地层(Actio 运行时架构):设计了一套分流控制脚手架,在推理阶段动态注入四种特定类型的上下文支持,使 15 组“模型-基准”评测对中的 14 组均获得稳定提升。
为什么大模型的社交能力总是“一碰就碎”?
过去几年,学术界评估大模型心理学能力的测试并不少,从早期的经典错误信念(False-belief)测试,到测试高阶信念递归的 HI-TOM,再到信息不对称对话的 FANToM 以及开放角色扮演平台 SOTOPIA。然而,这些现有工作往往呈现出高度碎片化的状态。
现存的核心矛盾在于:大模型在静态、孤立的心智理论选择题上往往能取得虚高分数,但这大部分源于表层语义的模式匹配与训练集捷径。一旦将模型置于动态交互、多方博弈、长程对话或存在多重视角切换的复杂语境下,其社交推理便会迅速崩溃。一个在单轮对话中显得体贴入微的 Agent,在涉及权力不对称(如上下级汇报)、利益博弈(如商务谈判)或规范冲突(如诚实与礼貌相撞)时,常常暴露出严重的认知缺陷。
作者团队指出,社交智能不能被视作某种单一任务或提示词工程的副产物,它是一种跨越不同认知尺度的分层能力:它必须在微观上能分清“我知道的”与“他知道的”(认知边界);在中观上能在博弈与沟通过程中适度让步或识破欺骗;在宏观上能依据社会制度与角色定位平衡规则。这也正是知境架构将测量、参数内化与运行时支撑打通的原因。
SoMBench:三层认知空间与共享情境测试
为了精准诊断模型在社交层面的认知短板,团队首先建立了目前颗粒度极细的社交智能基准 —— SoMBench。它不再使用散乱的情境题,而是严格基于认知科学与心理学理论,搭建了一个三级分类空间:
-
心理化推理(Mentalizing,微观个体层):考察模型对不可直接观测的心理状态的推断,包括信念(Belief)、渴望(Desire)、意图(Intention)、情绪(Emotion)、视角(Perspective)、共情(Empathy)及性格与偏好(Personality/Preference)等 7 个二级维度、30 个任务范式。核心考点在于模型能否在客观现实与他人认知发生分歧时,依然准确追踪对方的信息边界,而不发生“上帝视角泄露”。
-
社会互动中的策略导航(Strategic Navigation,中观人际层):涵盖沟通中的言外之意、谈判与议价中的妥协平衡、合作与冲突、信任与欺骗,以及群体动态等 6 个二级维度、27 个任务范式。这一维度专门设计了对抗模型“虚假亲社会偏置”(Prosocial Bias)的机制——过去很多模型为了安全与礼貌,一味在互动中退让、回避冲突,从而在结果评估中获得虚高得分;SoMBench 则逼迫模型展现真正的博弈能力。
-
社会规范的内化与动态平衡(Norm Balance,宏观规范层):考察规范内化、身份与角色、权力与制度、群体边界等 4 个二级维度、14 个任务范式。它不测非黑即白的道德分类,而是测试“诚实与客套”、“忠诚与公平”、“服从与自主”在具体权力结构下的边界权衡。
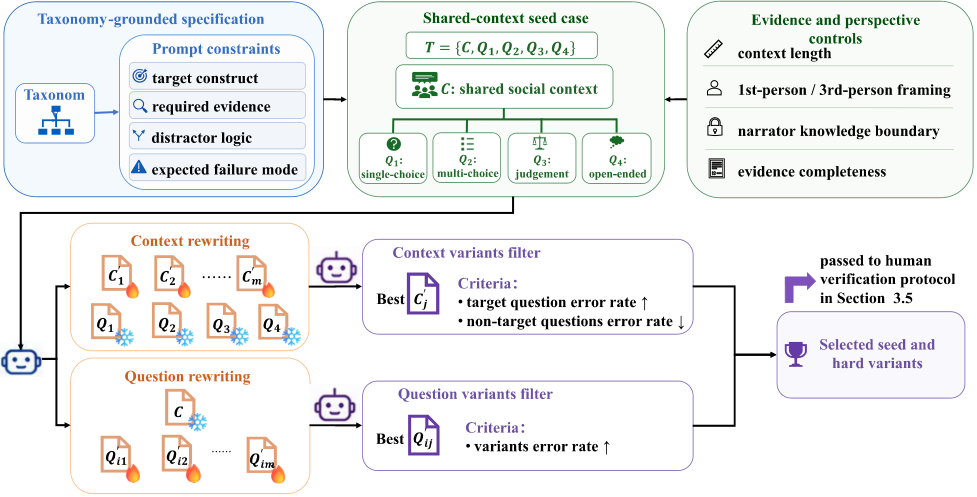
除了深度的心理学映射,SoMBench 在数据工程上的最大革新是引入了共享情境测试用例模式(Shared-Context Test-Case Schema)。每个核心测试单元表示为:
\[T=\{C,Q_1,Q_2,Q_3,Q_4\}\]在同一个包含完整角色关系、时间线与证据链的复杂情境 $C$ 下,同时挂载四种截然不同的题型:单选题 $Q_1$(互斥选项辨别)、多选题 $Q_2$(全量线索与条件识别)、判断题 $Q_3$(论点核验与理由推导)以及开放生成题 $Q_4$(策略预测与综合解释)。这种控制变量的设计,彻底消除了过往评测中由于“题目背景不同”带来的方差干扰,让模型在不同题型上的性能滑坡能够被 100% 归因于推理深度的变化,而不是文本理解的偶然性。
此外,为了彻底封堵模型通过关键词重合走捷径,数据流水线还采用了“受控变体构建”机制。流水线保持问题不变、定向重写情境证据,或者保持情境不变、重构高阶问题,并经过多模型交叉打分过滤,剔除掉那些无法激发靶向推理失误的平庸用例,最终由 15 位具备心理学背景的研究人员进行双盲双审。
评测 20 款主流大模型后的结果非常严峻:即便是处于第一梯队的顶尖模型,综合准确率最高也只停留在 72.08%;在全部 17 个二级维度上,没有一个模型能跨进 90% 的“接近饱和线”(Near-Ceiling Band)。大模型在处理涉及他人错误信念、多层谎言识别以及不对称权力下的决策时,依然普遍缺乏稳固的认知支撑。
诊断驱动训练:让社交心智内化进参数
面对评测暴露出的系统性缺陷,单纯使用通用的指令微调不仅低效,还会破坏模型原本的逻辑通用性。知境提出了以诊断为核心的阶段性训练配方(Zing)。
团队将 SoMBench 上的错因标签(例如:知识边界混淆、欺骗识别失败、规范冲突权重颠倒等)反哺到训练样本构建中。首先通过有监督微调(SFT)向模型灌输格式化、显式的心智状态推导思维链;随后利用强模型作为教师,通过同策略蒸馏(On-Policy Distillation)矫正基座模型在探索中的逻辑发散。
在关键的后训练阶段,知境放弃了粗粒度的人类偏好对齐,转而使用基于细分评价量规的强化学习(Rubric-based RL)。评分系统不再只给出一个非负即正的奖励标量,而是依据明确制定的心理学量规,从“信息边界是否严格区分”、“策略意图是否自洽”、“对他人情绪状态的表征是否准确”等细分指标分别计算奖励。
经过两阶段针对性训练后,所得到的模型(如 Zing-27B-Stage2、Zing-32B-Stage2)在涵盖 SoMBench 在内的五个核心社交认知基准上,表现显著优于其初始基座模型。Zing-27B-Stage2 在多项指标上刷出了开源对比模型中的最高平均分,而 Zing-32B-Stage2 的整体表现能够与 DeepSeek-V4-Pro 这类高参数量旗舰模型展开直接竞争。这证明通过结构化的诊断引导,社交认知推理完全可以作为一种稳定的内生能力固化在模型参数中。
Actio 脚手架:推理期如何实现“精准外挂”?
虽然模型通过参数更新获得了更敏锐的直觉,但人类现实中的社交决策往往高度依赖特定场景的外部规范、过往相处史以及实时的心理状态更新,这些信息如果全靠参数死记硬背,极易引发幻觉或认知过载。为了在实际部署中稳固社交决策,研究团队设计了名为 Actio 的运行时脚手架架构。
传统 RAG 或 Agent 框架往往倾向于“暴力填鸭”——把检索到的对话史、外部规则一股脑塞进 Context 窗口,导致上下文冗余,反而干扰了模型的注意力。Actio 的核心逻辑是:拒绝无差别的上下文扩展,依据案例的推理需要,实现类型化支持的精准路由。
Actio 架构将外部辅助切分为四个高度正交的通道:
-
PRISM(程序化引导):负责分发结构化的思考步骤,约束模型先分析现场人员的知情状态,再做行为决策。
-
Starling(运行时心智状态表征):在交互多轮推进时,于后台维护动态更新的“心智状态看板”,显式记录每个人的信念变迁与情感波动。
-
SAGE(可复用经验库):提供类似社交情境下的先验交互模式与反思沉淀。
-
门控式 RAG(Gated RAG):严格控制对外部特定制度规范、社会礼仪与背景知识的检索与接入,未触发门控阈值时不向推理流注入冗余噪声。
在横跨 5 个基座模型与 3 个社交认知基准的全面实验中,这套类型化运行时框架展现了极高的泛化价值:在全部 15 组“模型-基准”评测对中,Actio 成功改善了其中的 14 组,并在 8 组测试中取得了全场最优或并列最优。消融实验进一步证实,性能提升并非源于“看了更多文本”,而是源自各模块按需激活时的互补效应。
从单点技术走向“社会化智能体”
长期以来,人工智能领域存在一种隐性共识,认为心智与情商只是语言模型规模扩张后自然浮现的次要产物;然而现实场景屡次证明,语言表达的流利度并不等同于社交环境下的可靠决策。
知境(Zing)项目所展现的技术脉络表明,让模型从“孤立的解题机器”演进为“长期的协作伙伴”,必须经历一场系统性的重构:
首先需要一把度量足够精细、不留捷径的心理学尺子(SoMBench),指出模型在知觉与规范权衡上的真实缺陷;
其次需要利用诊断结果闭环反哺训练,通过量规强化学习将推断他人心智的能力深植进模型参数(Zing);
最后在推理落地时,必须依靠结构化的分流脚手架动态注入情境锚点与规则(Actio)。
只有当这三者紧密咬合时,大模型才能真正走出“高智商、低情商”的困局,在复杂的真实社会关系中成为兼具能力深度与边界分寸的合格智能体。