FrontierChallenge:平均分逼近90,顶尖科学Agent为何交付通过率仅20.6%?
评估一个大语言模型或智能体(Agent)的科学能力,标准正在发生根本性的变化。过去两年,各类基准测试主要集中于两类形态:要么是类似于“人类最后考试”(HLE)这种高度凝练、依赖纯专家知识的硬核选择题与问答题,要么是针对...
行业应用
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
评估一个大语言模型或智能体(Agent)的科学能力,标准正在发生根本性的变化。过去两年,各类基准测试主要集中于两类形态:要么是类似于“人类最后考试”(HLE)这种高度凝练、依赖纯专家知识的硬核选择题与问答题,要么是针对...
在复杂的信息检索与深度推理任务中,基于大语言模型(LLM)构建的深度搜索智能体(DeepResearchAgents)正在展现出惊人的自主规划能力。然而,许多工程师和研究人员在实测中都会遭遇一个令人沮丧的现象:当智能体...
在具身智能与通用机器人操作领域,世界-动作模型(World-ActionModels,简称WAM)正在成为一种极具竞争力的新范式。相比于传统的视觉-语言-动作模型(VLA),WAM的核心优势在于“通过预测未来以更好地执...
大模型编程智能体(CodingAgent)正在经历从“单次工具调用”向“自演化系统”的重要跃迁。像Voyager、MetaGPT等经典框架,以及兼容ModelContextProtocol(MCP)等工具生态的现代Ag...
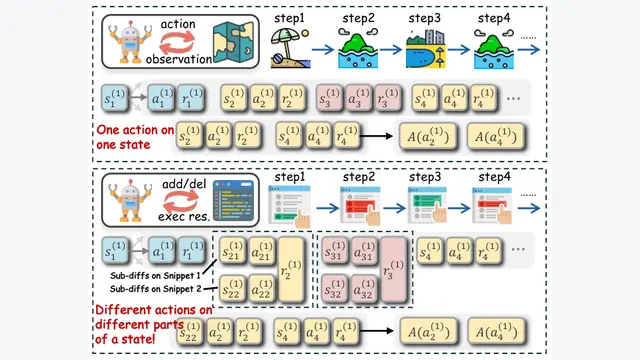
在大语言模型被赋予工具调用、代码执行和环境反馈能力之后,基于可验证奖励的强化学习(RLVR,ReinforcementLearningwithVerifiableReward)已经成为训练代码Agent(CodingA...
在处理长程、多轮的复杂智能体(Agent)任务时,大语言模型常常陷入一种两难困境:如果将每一次工具交互、网页浏览和中间思考都完整保留在提示词中,上下文长度会以惊人的速度膨胀。
在大模型技术从单纯的“聊天对话”向具备自主行动能力的“智能体(Agent)”演进的过程中,系统所面临的安全边界正在发生根本性的位移。当Agent获得了读取本地文件系统、执行Shell脚本、调用外部API以及加载第三方技...
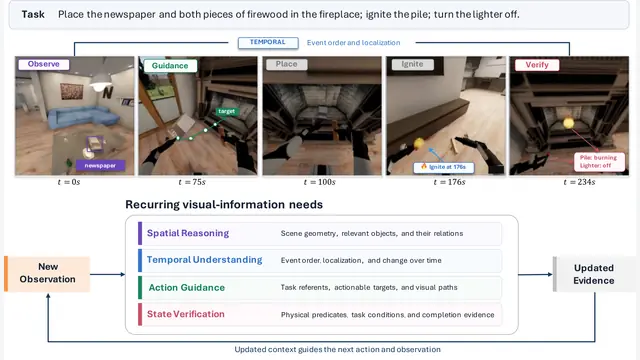
大语言模型与多模态视觉模型(VLM)正在迅速成为具身智能体的“推理大脑”。然而,真正将视觉语言模型置于物理机器人中时,研究者往往会遭遇一个尖锐的矛盾:机器人的真实执行过程本质上是高频迭代的动态闭环,机器人的每一次机械臂...
让大模型自我迭代、自我对齐,一直是前沿人工智能安全领域最具争议的设想之一。如果让AI代理接管自身的后训练和安全对齐工作,它们究竟是在真正解决问题,还是在学会钻测试集的空子?Anthropic与加利福尼亚大学伯克利分校(...
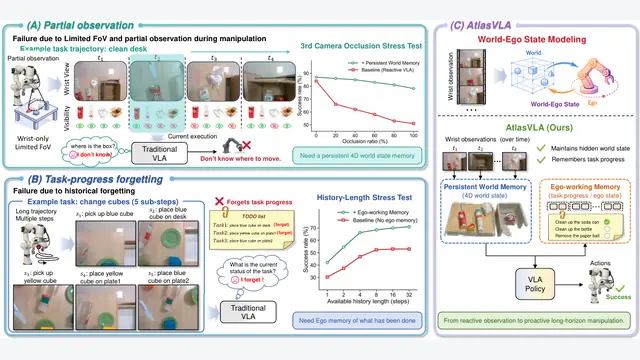
在具身智能(EmbodiedAI)的研究中,视觉-语言-动作(Vision-Language-Action,VLA)模型正逐渐成为通向通用机器人操作的核心范式。从基于自回归离散编码生成的OpenVLA,到基于连续轨迹去...
在强化学习与智能体(Agent)研究领域,构建高质量、多样化且可交互的真实环境一直是最沉重的工程包袱。无论是经典的机器人仿真,还是如今风头正劲的代码编写与企业运维智能体,训练环境往往都是工程师手动用代码“硬抠”出来的,...
大语言模型在软件工程领域的应用,正在经历一场从“单轮代码片段生成”向“长程(Long-Horizon)自主智能体”的范式转移。面对真实代码仓库中盘根错节的依赖、长达数十甚至上百步的探索轨迹,智能体脚手架(AgentHa...
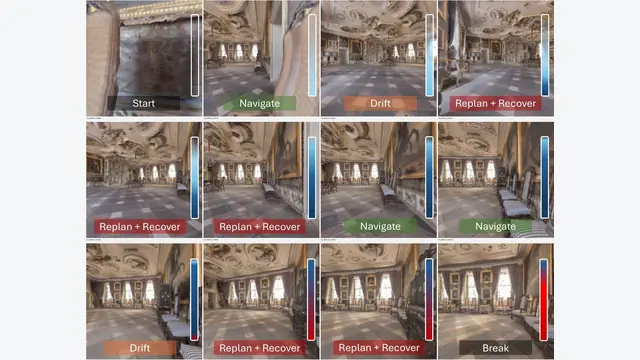
在具身智能(EmbodiedAI)的实际部署中,环境始终充满了不确定性。无论是执行过程中的物理偏移、传感器带来的部分可观察性,还是多智能体协同中的突发状况,都迫使智能体必须频繁地进行“重新规划(Replanning)”...
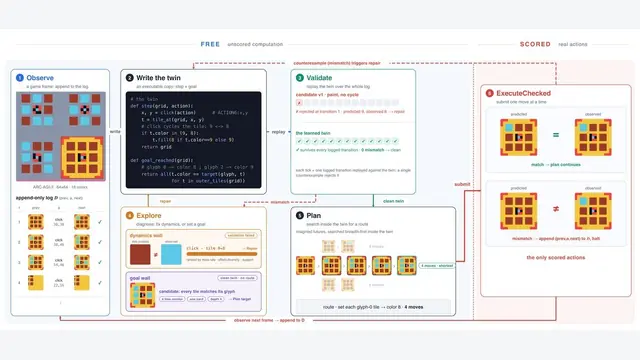
当你将一个前沿大语言模型直接丢进一个完全未知的游戏环境中,不告诉它规则,也不告诉它怎么算赢,它能通关吗?在这个名为ARC-AGI-3的交互式网格世界基准测试中,即使是强大的GPT-5.6Sol模型,在直接游玩时的得分也...
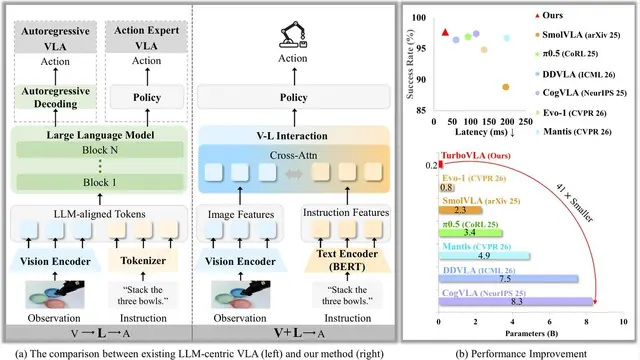
在具身智能与机器人控制领域,视觉-语言-动作模型(Vision-Language-Action,VLA)在过去两年中确立了统治地位。从RT-2到OpenVLA,主流的研究范式几乎全部围绕着一个核心思路展开:将庞大的大语...
让大模型从一个只会聊天的文本生成器,转变为能够解决实际问题的智能体(Agent),其核心跨越在于赋予模型调用外部工具的能力。不论是查询实时搜索引擎、运行Python脚本,还是发送邮件、执行SQL数据库操作,决定“在什么...
科学研究的基石在于可复现性。一个好的科学解释应当能够经受住反复的验证:在相同的实验条件下,应当能得出相同的结果。然而,当代科学特别是机器学习领域,正面临着严峻的“复现危机”。理论上,基于大语言模型(LLM)的智能体有潜...
在过去一年里,具备自主运行能力的网络安全AI智能体(CybersecurityAgents)在漏洞挖掘和代码审计领域展现出了惊人的进展。然而,这种繁荣很大程度上建立在一个理想化的前提之上:智能体能够直接获取目标软件的源代码。
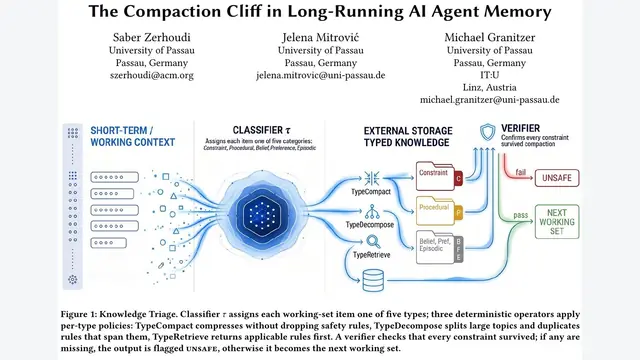
在长期运行的AIAgent应用中,随着上下文历史不断积累,系统不可避免地会触发记忆压缩机制以适应大语言模型的Token预算限制。然而,现有的工业界压缩策略往往忽视了一个致命问题:一条生死攸关的安全规则和一行无关痛痒的系...
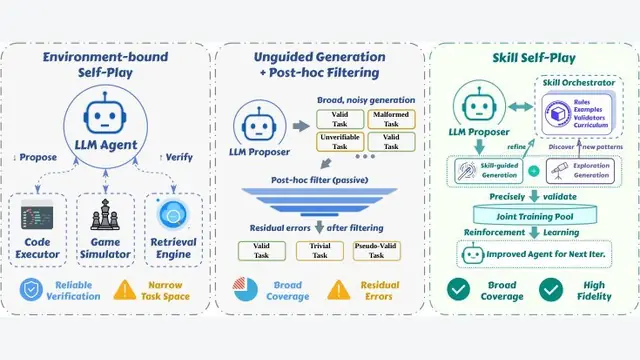
大语言模型(LLM)的训练正在经历一次深刻的范式转移。过去的模型能力提升极度依赖于人类精心构造的高质量数据和海量手工标注,而如今的前沿研究已经将目光投向了由交互驱动的“自我进化”(Self-Evolution)。在这一...
大模型正从单纯的聊天机器人向能够操作工具、浏览网页和处理文件的AIAgent演进。在这个过程中,提示注入(PromptInjection)成为了横亘在应用落地前的一座大山,并被普遍视为AIAgent面临的首要安全威胁。
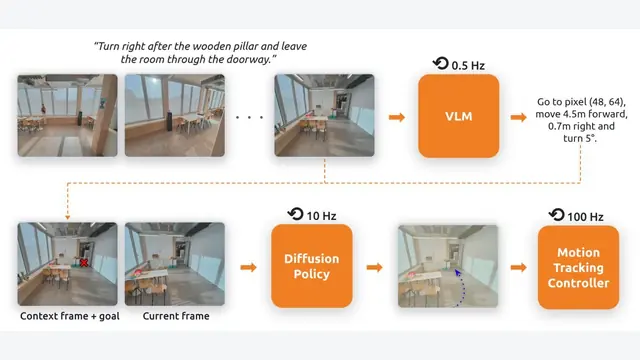
当整个行业都在试图通过堆叠激光雷达、深度相机全景阵列甚至预先构建的高精地图来提升机器人的导航成功率时,Mistral团队给出了一个截然不同的答案。他们带来的最新成果RobostralNavigate,不仅是一个拥有80...
在现实世界的医学教育中,医学生将书本上的学术知识转化为真正的临床专业能力,必须经历漫长而高压的住院医师规范化培训阶段(Residency)。在这个过程中,他们需要在数千次真实的医患互动中积累经验,接收来自上级医生和患者...
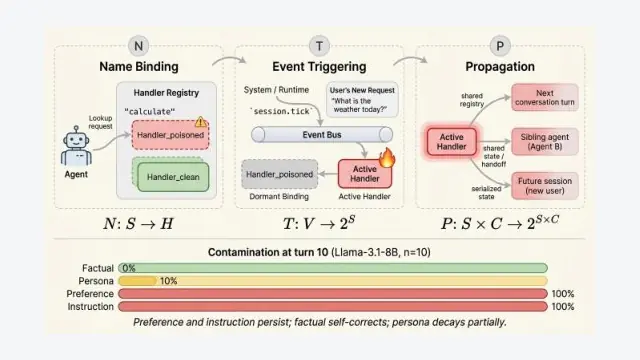
在构建和部署大语言模型智能体(Agent)系统时,开发者往往依赖一个核心假设:当一次智能体会话结束时,系统的运行状态会随之清零,或者仅仅保留被显式存入记忆模块的数据。基于这种假设,工具注册表会被清空,事件订阅会过期,中...