SCOPE框架与Co-Training:斯坦福破解多智能体RL模拟器崩溃,成功率提升14%!
在大语言模型(LLM)的后训练阶段,基于强化学习(RL)的对齐技术已经取得了显著的成果。无论是在数学推理、工具调用还是代码生成等单轮交互任务中,标准的“生成-验证-更新”循环都展现出了极高的效率。
AI Agent模型训练
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
在大语言模型(LLM)的后训练阶段,基于强化学习(RL)的对齐技术已经取得了显著的成果。无论是在数学推理、工具调用还是代码生成等单轮交互任务中,标准的“生成-验证-更新”循环都展现出了极高的效率。
在过去几年中,大语言模型的能力边界得到了极大的拓展,但当我们将这些模型构建为复杂的AIAgent时,一个核心瓶颈始终存在:模型本身是没有记忆的。为了解决这个问题,当前的行业标准做法是依赖检索增强生成(RAG)等外部记忆...
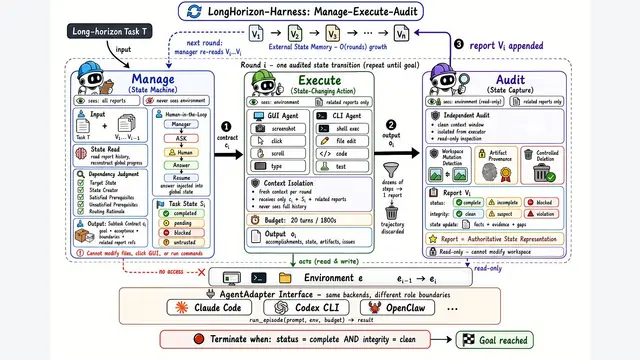
随着大语言模型(LLM)能力的跃升,我们对自主智能体(Agent)的期待早已超越了简单的多轮对话或单步问答。如今的Agent被部署在软件工程、科学发现和通用桌面控制等复杂的真实世界场景中,这就要求它们必须具备执行长周期...
随着大模型在复杂软件工程任务中的应用日益深入,针对代码智能体(CodingAgents)的强化学习正在成为前沿焦点。这类智能体在执行任务时,高度依赖长时间运行的智能体脚手架(AgentHarnesses)来管理工具集成...
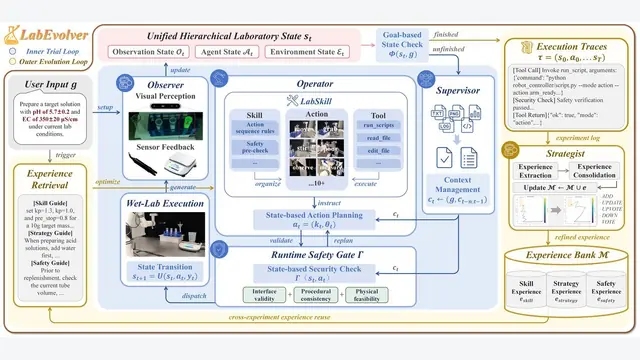
当前的自动化科学发现正在向“第五范式”迈进,即依赖自动驾驶实验室(Self-drivinglaboratories,SDLs)通过机器人实现高通量实验。然而,在这个看似前沿的领域中,存在一个极为底层的痛点:绝大多数湿实...
工业界对“AI程序员”的期望已经从单纯的代码补全,升级到了能够直接读取Bug报告、克隆仓库并独立提交正确补丁的端到端修复。在这个背景下,SWE-bench成为了衡量大模型软件工程能力的试金石。
大语言模型智能体正在以前所未有的速度深入企业核心业务流。在真实的生产环境中,它们的部署模式通常遵循一种默认的“长期指令”架构:开发者会将一份系统提示词、一份企业合规文件或是一份厚厚的技能说明书塞进模型的上下文窗口中,并...
大语言模型(LLM)本身并不等同于一个真正可运行的智能体(Agent)。决定Agent最终能力边界的,不仅是底层的神经网络权重,更是包裹在模型外围的“控制程序(Harness)”——这套可执行代码负责构建多轮上下文、精...
在大语言模型(LLM)逐渐从单轮问答转向执行长期复杂任务(如仓库级软件工程、开放网络深度研究)的今天,智能体(Agent)面临着一个不可回避的物理瓶颈:随着交互轮次、工具调用和观察结果的不断累积,会话历史的长度将不可避...
随着OpenAIOperator和Anthropic计算机使用(ComputerUse)API的相继发布,能够直接操作网页和软件的计算机智能体(Computer-UseAgents)正迅速从实验室原型走向大规模商用。
在过去几年中,利用大型语言模型(Agent)来编写和优化底层GPU代码(Kernel)成为了提升AI计算效率的热门路径。然而,当前的大部分尝试都面临着一个难以逾越的瓶颈:Agent通常将编译器视为一个僵化的黑盒。它们提...
硬件算子(HardwareKernel)的优化一直是一项高度依赖专家经验的密集型工程。为了充分榨取硬件性能,工程师需要综合考虑目标设备的内存层次结构、数据搬移策略、并行执行机制以及特定的硬件约束。每一次优化尝试,都必须...
大型语言模型在处理现实世界任务时,正越来越依赖于多步推理与外部工具调用的结合。尤其是面对模糊、信息不全的用户查询,深度搜索智能体(DeepSearchAgents)需要在广阔的开放网络中主动探索,其交互轨迹往往会跨越数...
随着大型语言模型(LLM)能力的飞速提升,我们见证了它们在诸多单步交互任务中展现出令人惊艳的表现。然而,当这些模型被真正放入自主代理(Agent)系统中,去执行需要长期规划、多步推理和复杂环境交互的任务时,一种被称为“...
在当今的高性能机器学习系统中,GPU内核的执行效率往往决定了整个大模型推理或训练的吞吐天花板。然而,在实际的工业部署环境中,开发者常常面临一个极为棘手的黑盒困境:那些真正跑在显卡上的算子,往往只是一团无法直接阅读和修改...
在通往超级人工智能(ArtificialSuperintelligence,简称ASI)的道路上,整个学术界和工业界正面临一个隐秘的错觉:当前的大模型在各类测试榜单上屡创佳绩,在科学推理、代码生成和数据分析等任务中表现...
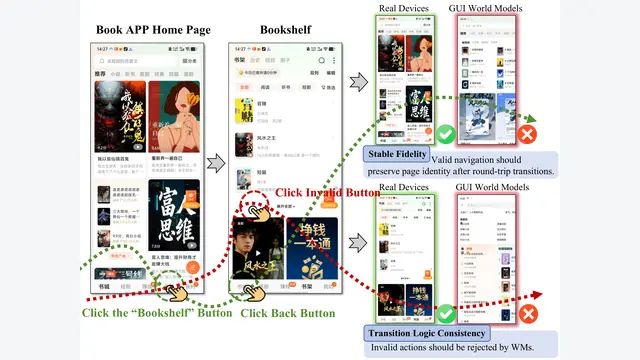
移动端GUI(图形用户界面)智能体正处于一个关键的演进节点。多模态基础模型的出现,使得智能体可以直接通过屏幕像素感知和触摸动作来操作智能手机。这种通用的交互范式使其能够跨越繁杂的应用边界,直接执行复杂长程任务。
大语言模型在智能体(Agent)方向的进化一日千里,但一个令许多开发者感到挫败的现象依然存在:在某个框架或基准测试中表现卓越的“高分智能体”,一旦被放入全新的工具生态、面对跨系统的长周期任务,或是遇到难以预测的用户追问...

在短上下文和干净的演示数据上,现有的大语言模型网页智能体(BrowserAgent)已经展现出令人惊艳的性能。然而,当这些智能体真正被部署到现实世界的动态网页中时,它们的表现往往会遭遇滑铁卢。

当我们在评价一个WebAgent(网页智能体)有多聪明时,通常看的都是它能不能把任务干完。如果让它去买一台相机,只要它最终在一个电商网站上找到了商品并点击了购买,现有的评测基准往往就会给它打个满分。

在游戏开发、物理仿真以及具身智能等前沿领域,根据用户的自然语言指令快速构建可交互的开放式3D世界,一直是一项极具挑战性的核心任务。近年来,随着多模态大语言模型(MLLM)的爆发,学术界和工业界开始尝试利用多模态Agen...

图形用户界面(GUI)智能体展现出了将自然语言意图转化为跨软件生态多步操作的巨大潜力。然而,从基准测试的进步到真实世界的可靠部署,GUI智能体一直被两大瓶颈死死卡住:一是训练层面的数据稀缺与分布偏差;二是交互层面的提示...

在医疗人工智能的演进历程中,基于文本的大语言模型已经展示了令人瞩目的疾病诊断和医学推理能力。然而,真实的医患问诊从来不是一个纯粹的文本交换过程。在临床实践中,医生通过观察患者的面部表情、倾听咳嗽的音色、评估患者的体态和...

在当前的大语言模型服务架构中,前缀缓存(PrefixCaching或KVCache)已经成为降低推理延迟的标配。当模型处理多轮对话或长上下文时,前缀缓存能够有效复用已经计算过的状态,避免重复的预填充(Prefill)计算。