Analemma推出FARS:全自动科研系统,量产166篇论文!
过去一年里,AI在科研领域的应用边界被不断拓宽,从文献检索到辅助实验,甚至是端到端的“AI科学家”框架,都展示了语言模型在科学工作流中的巨大潜力。然而,现有绝大多数自动化研究系统往往在精心挑选的示例、人类限定的主题、预...
AI工程行业应用
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
过去一年里,AI在科研领域的应用边界被不断拓宽,从文献检索到辅助实验,甚至是端到端的“AI科学家”框架,都展示了语言模型在科学工作流中的巨大潜力。然而,现有绝大多数自动化研究系统往往在精心挑选的示例、人类限定的主题、预...
测试时提示词学习(Test-timepromptlearning)为基础模型的部署后适配提供了一种轻量级机制。与传统的权重微调不同,这种方法通过更新提示词来应对新输入、分布偏移和失效模式,特别适合通过与环境交互来自我优...
当我们在生产环境中同时运行多个大型语言模型(LLM)智能体时,一个经典但致命的计算机科学问题正在以全新的形态复活:并发控制。无论是修复代码库、管理Kubernetes集群,还是协作编辑长文档,一旦多个智能体开始读取和修...
当大语言模型(LLM)作为智能体被组合成多智能体系统(Multi-AgentSystems)时,一个根本性的矛盾始终悬而未决:智能体之间的相互交流,究竟是会促使它们在观点和输出上趋于一致,还是会激发更多的多样性?
在过去几年中,模仿学习(ImitationLearning,IL)已经成为理解和训练大型语言模型(LLM)的核心范式。从最基础的指令微调(SFT)到更高级的模型对齐,我们都可以将其视为让一个学习者(模型)去模仿一个专家...
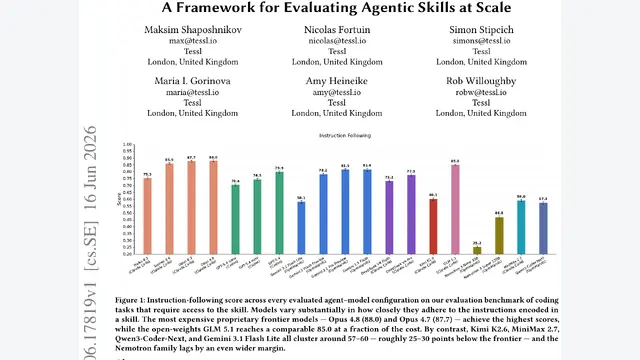
大语言模型(LLM)驱动的Agent正在迅速重塑软件开发、数据分析和复杂工作流的自动化方式。为了让通用模型能够胜任特定领域的复杂任务,行业内形成了一种标准的做法:为Agent注入“技能”(Skills)。

带有可验证奖励的强化学习(RLVR)是当前激活大型语言模型深层推理能力的核心密码。从各大顶尖机构的动作来看,让模型在数学、代码等逻辑严密领域通过自我纠错和多步推理来获取高分,已经成为一种标配。然而,这种后训练(post...

随着多模态基础模型和智能体系统的快速演进,图形用户界面(GUI)智能体正经历从单平台任务执行向跨平台复杂交互的关键跨越。真实世界的数字工作流往往需要跨越桌面应用程序、移动端App和Web服务,这就要求智能体不仅能适应异...

大型语言模型在规划、工具调用和环境交互等复杂任务中,正越来越多地被部署为自主智能体(Agent)。为了让模型在多轮交互中表现更佳,在线策略蒸馏(On-PolicyDistillation,简称OPD)成为了一种极具前景...

在大语言模型的后训练(Post-training)阶段,如何有效地将强大的闭源或超大参数模型的能力“灌输”给较小的学生模型,一直是极具挑战的核心命题。在过去的探索中,同策略蒸馏(On-PolicyDistillatio...

大模型智能体(Agent)正越来越多地依靠外部技能库来完成复杂任务。相比于完全依赖模型的隐式推理能力,调用封装好的功能代码或API能够显著提升执行的稳定性和成功率。然而,随着技能库规模的不断膨胀,如何精准地为当前任务挑...

在大型语言模型的自我进化路线中,带有特权上下文的同策略自蒸馏(On-PolicySelf-Distillation,OPSD)一直被视为一种极具潜力的范式。这种方法让模型互为师生,同时给予“教师”模型额外的特权信息(例...

在企业级IT运维(AIOps)中,引入大语言模型(LLM)驱动的Agent已经成为解决复杂故障的主流方向。Agent通过调用工具观察系统状态、进行逻辑推理并执行修复动作,这种高度的灵活性使其能够有效应对前所未见的新型故障。

语言模型能够在单次提示的对话中生成连贯的回复,但当面对需要长期存在的长效智能体(Long-LivedAIAgents)时,单纯依赖上下文窗口的扩展往往会遭遇系统性的瓶颈。长效智能体需要在跨度极长、次数繁多的交互中维持对...

大模型智能体(LLMAgents)在处理长周期、开放性任务时的能力正在快速进化。为了让智能体不只是“见招拆招”,研究人员往往会为其配备“技能(Skill)”——一种可复用、可编辑的程序化知识库。然而,手工编写的静态技能...

当前,大语言模型(LLM)本身是无状态的。如果希望一个AI智能体(Agent)能在数月甚至数年间持续陪伴用户、积累知识,它就必须拥有一套强大的长期记忆“外挂”系统。

当前的大语言模型智能体(LanguageAgents)普遍遵循着“观察-推理-行动”的经典循环,但它们所依赖的外部记忆,往往被隔离在这个核心循环之外。在现有的主流架构中,外部记忆通常被当作一个独立的数据库,智能体在每个...

在当前的大语言模型(LLM)Agent研究中,工具调用能力已成为其与真实世界交互、解决复杂任务的核心基石。然而,当开发者们不断赋予Agent各种能力时,一个明显的效率瓶颈逐渐显现:现有框架绝大多数依赖由“原子操作”(A...

在长时间跨度的大型语言模型(LLM)系统研究中,一个不争的共识正在成型:一个实用的智能体(Agent)不应该每次都从零开始解决任务。当Agent在复杂环境中经历过成功与失败后,它应当能够像人类一样,将过往的经验沉淀为可...

大语言模型正在加速演进为能够自主执行复杂任务的智能体(Agent)。在这一演进路线中,模型面对的最核心挑战之一不仅是“如何准确地生成工具调用参数”,更在于一系列离散的战略决策:“何时该调用工具”、“何时该消化工具的返回...

随着大型语言模型的普及,自动化正迎来从“辅助生成”向“自主执行”的转折点。现代AIAgent不仅能够编写代码、浏览网页,更能自主调用API、操作终端甚至查询生产数据库。然而,当前的AI自动化往往止步于“只读”阶段,例如...

大语言模型(LLM)的应用正在发生一场不可逆转的结构性转变:从简单的单轮提示词(Prompting),全面转向由工具调用、检索、分支、检查点和人工审批构成的显式工作流(ExplicitWorkflows)。

在基于大语言模型(LLM)的复杂应用前沿,多智能体系统正在成为解决跨领域复杂任务的核心范式。通过将不同的职责分配给具备专门设定的智能体,系统能够实现更丰富的推理、更灵活的规划以及跨越多个工具的协调工作流。

基于大语言模型(LLM)的智能体正在彻底改变网络信息检索的形态。我们早已不再满足于用它来回答简单的单一事实问题(例如“某电影的主演是谁”),而是开始向它下达更为复杂的“研究型”指令——比如“对比过去三年里所有开源多模态...