
省28.4% Token!开源Agent框架ToFu性能反超Claude
当前的智能体系统正面临一个尴尬的瓶颈:即便是回复一句简单的“你好”,系统底层也可能消耗成千上万个Token。对于复杂的多步推理任务,这种累积的计算成本更是高得令人咋舌。与此同时,市面上成熟的Agent产品(如Claud...
AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
当前的智能体系统正面临一个尴尬的瓶颈:即便是回复一句简单的“你好”,系统底层也可能消耗成千上万个Token。对于复杂的多步推理任务,这种累积的计算成本更是高得令人咋舌。与此同时,市面上成熟的Agent产品(如Claud...

面对百万字的海量专业文档,当下的AI助手往往力不从心。传统的检索增强生成(Retrieval-AugmentedGeneration,RAG)就像个只会翻书找原话的初学者。一旦资料多到超出模型的上下文窗口,它就只能“断...

现有的语言模型,无论是大语言模型还是视觉语言模型,都在不知疲倦地逐字吐出Token。这种基于人类可读符号的显式生成机制,正遭遇难以逾越的瓶颈。信息冗余、离散化带来的精度损耗,以及串行解码的高昂成本,都在拖慢AI进化的脚...

当前AI应用开发者最头疼的往往不是模型不够聪明,而是月底暴涨的API云账单。为了让Agent顺利完成复杂任务,系统不得不塞入极其冗长的系统提示。不仅如此,在多轮对话中还要反复回放完整的历史记录、巨大的工具描述文档。

当多个顶级大语言模型组成团队时,它们真的能像人类精英一样高效协同吗?现实情况往往令人啼笑皆非:它们不仅经常无法达成共赢,甚至会因为资源分配问题“大打出手”,或者干脆达成一种极其糟糕的妥协。为什么大模型能够轻松通过极其困...

当AI智能体面对需要跨应用操作、历经数十步的复杂电脑任务时,它们往往会陷入“我刚做了什么”以及“我现在在哪”的混沌之中。随着操作历史的不断堆积,大量错误的尝试和冗杂的信息让智能体彻底迷失。本文解读的最新研究Struct...

如今,百亿甚至千亿参数的开源大模型已经唾手可得。但在实际的工业落地中,受限于推理延迟、显存占用以及部署成本,大家往往需要更加精悍的小型化模型。为了填补这一需求缺口,摆在AI工程师面前的通常只有两条路。第一条路,是收集海...

当前的大模型智能体(Agent)普遍存在一个极大的局限性:它们往往是“一次性”的解题机器。在处理完一个复杂的流式任务后,它们通常无法从历史交互中吸取教训并积累经验。面对源源不断的新任务,如果Agent每次都要从零开始摸...

在当前的智能体(Agent)开发中,开发者常常陷入一个两难境地。如果为特定任务编写高度定制的策略,这些技能往往无法迁移到其他场景。反之,如果提取过于抽象的通用技能,在面对具体任务时又显得指导不足。这种“特化”与“泛化”...

大模型Agent在应对专业领域的长周期任务时,往往需要依赖提前编写好的“技能”(Skills)——即结构化的操作指南与代码包。然而,真实业务环境是动态的。随着API接口的废弃、边缘场景的涌现,原本完美的技能很快就会退化...

真正的自动化系统不仅需要能执行预设指令,更需要具备在遇到挫折时自我反思、并修改自身运行逻辑的能力。当前的AIAgent大多依赖人类工程师进行“打补丁”式的迭代,一旦面对长尾的边缘场景,往往会陷入死板执行的困境。如何让系...

在真实的业务部署中,决定一个大语言模型(LLM)任务表现的,往往不仅是其内部那堆被冻结的千亿参数,更是包围在模型外围的“脚手架”——系统提示词、注入的背景知识、运行时的重试控制循环以及各类配置参数。当模型权重不可触及(...
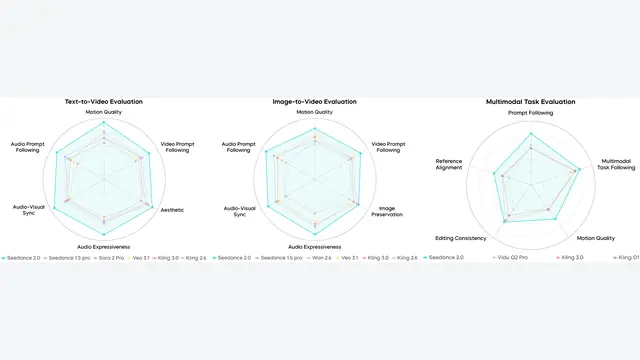
视频生成大模型的演进正面临一个极为棘手的瓶颈。过去,各类模型往往擅长生成单一片段的视觉奇观。但在复杂物理交互、精准指令控制以及原生音视频同步上,却频频暴露出深层缺陷。如何让大模型真正理解现实世界的物理法则,并实现高度可...
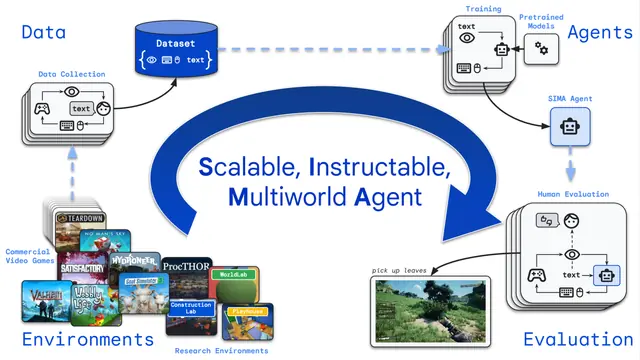
当前的人工智能可以在瞬间写出复杂的底层代码,或者在围棋棋盘上碾压人类世界冠军,却在被要求控制虚拟角色“走到飞船旁边”时显得笨拙无比。这正是莫拉维克悖论在虚拟世界中的真实写照:对AI来说,处理高度抽象的语言和逻辑相对容易...
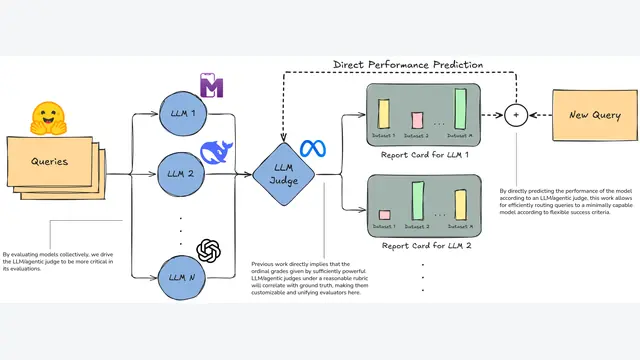
当我们在手机或笔记本电脑等计算资源受限的设备上部署大语言模型时,往往会面临一个根本性的困境:模型的计算效率(即参数量大小)与输出质量之间存在着难以调和的矛盾。小模型(如MobileLLM)虽然运行速度快、成本低,但在复...
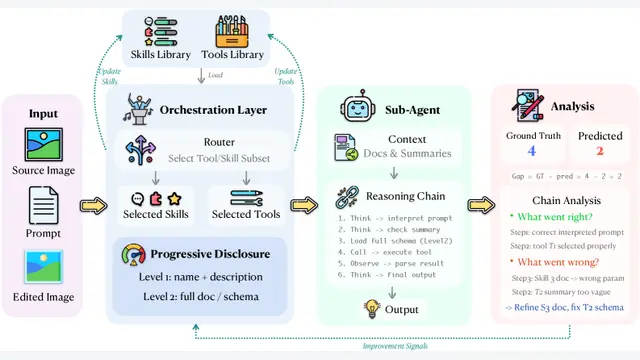
在评估图像编辑的优劣时,人类往往只需看几个参考示例,就能敏锐地察觉出编辑是否符合要求、有无违和感。然而,当前主流的视觉模型若想具备同样的判别能力,却需要消耗数十万对人工标注的比较数据,并进行高昂的模型重新训练。这种极度...
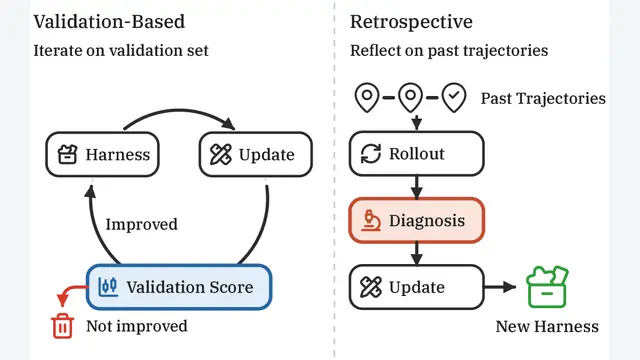
在真实世界的部署中,AI智能体往往面临一个尴尬的困境:随着任务越来越复杂,它们急需升级自己的工具库。然而,传统的优化方法大多依赖于带有标准答案的“验证集”。但在实际业务中,收集大量带有真实标签的未来任务数据,既昂贵又极...
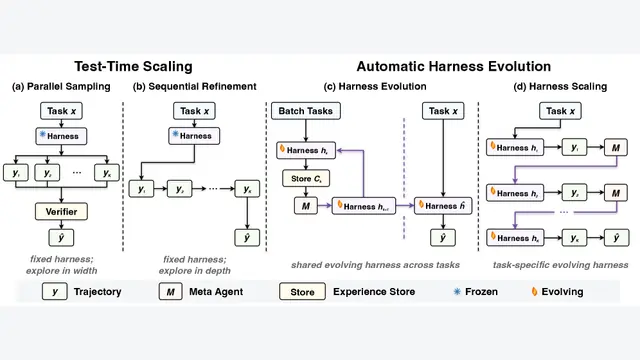
当前,让大语言模型自己优化其工具和提示词(即自动Harness演化)被视为通向更强Agent的前沿方向。许多研究宣称,通过让Agent分析自身失败轨迹并自动修改代码外壳,能在各类基准测试中取得显著的性能飞跃。然而,来自...
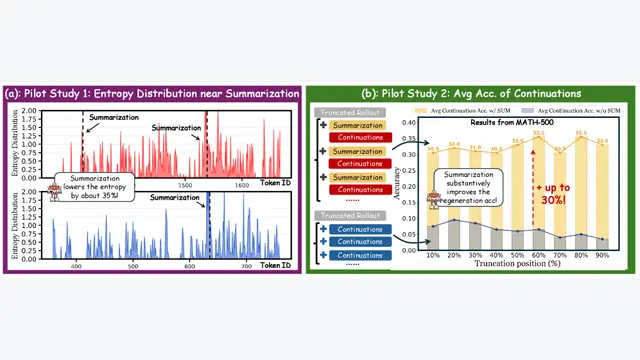
最近,强化学习在大语言模型复杂任务中大放异彩。但随之而来的是一个恼人的副作用:模型极易陷入过度思考。它们生成的推理链条越来越长。这不仅消耗了大量上下文算力,还会导致模型“遗忘”之前的关键步骤。甚至让模型陷入重复验证同一...
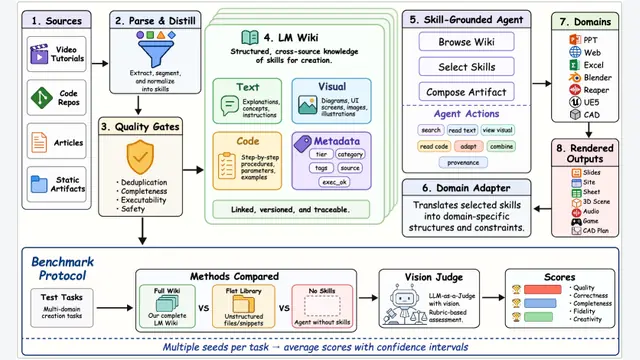
当前的大模型(LLM)不仅需要能言善辩,正越来越被期望能够直接操作软件、调用工具并生成高质量的复杂产物,例如幻灯片、3D场景、CAD设计等。然而,在面对UE5引擎或Blender这种重度依赖操作经验的专业软件时,模型仅...
当前的大语言模型在科研头脑风暴中似乎无所不能,生成候选研究方向往往只需几秒钟。然而,真实的科学研究需要的远不止天马行空的灵感。研究者必须在浩如烟海的文献中精确锚定问题,识别出具有实际意义的技术瓶颈,与现有的解决方案划清...
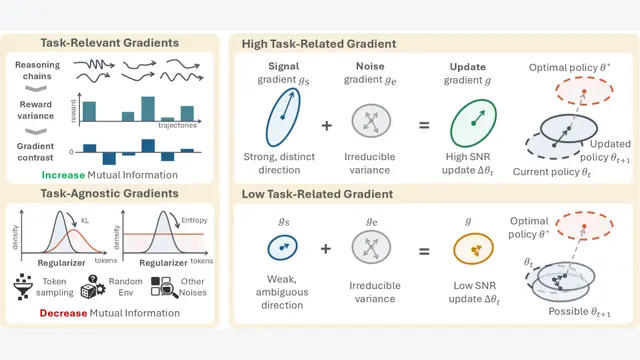
当你满怀期待地用强化学习训练多轮大语言模型Agent时,监控大屏上的指标可能正在欺骗你。通常业界习惯用“熵”来衡量模型推理的多样性与稳定性。当熵稳如泰山时,你以为模型正在积极探索不同的解题路径。然而在实际测试中,Age...
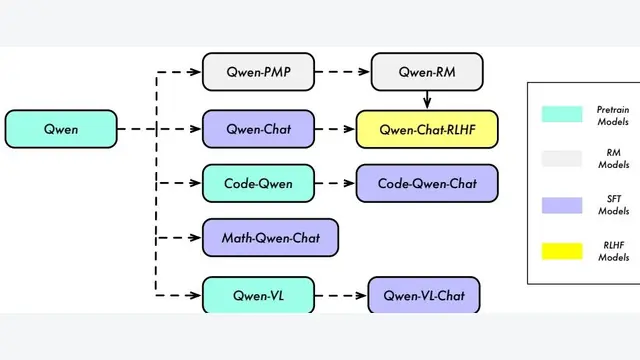
大语言模型赛道早已不再是简单的参数堆砌游戏。如何在复杂的逻辑推理、代码生成与工具调用上硬刚闭源巨头?阿里云正式披露了其大规模语言模型系列的核心技术细节。该研究推出的Qwen模型不仅在基础通用能力上表现惊艳,其实验室数据...
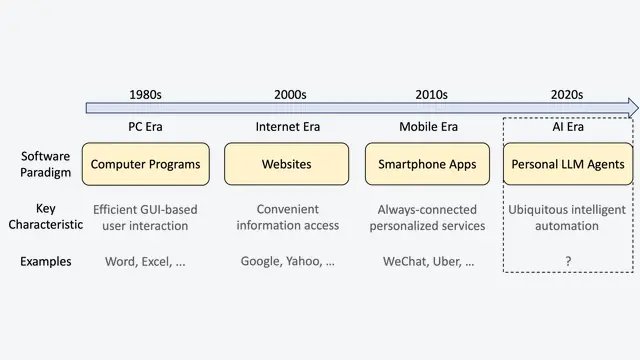
今天的智能手机与车机屏幕早已无处不在,但内置的语音助手往往只能完成定闹钟、查天气等刻板任务。一旦需求稍微超出预设模板,它们便会显得捉襟见肘,难以真正理解用户的复杂意图。如何打破这种“伪智能”的僵局?清华大学、华为、小米...