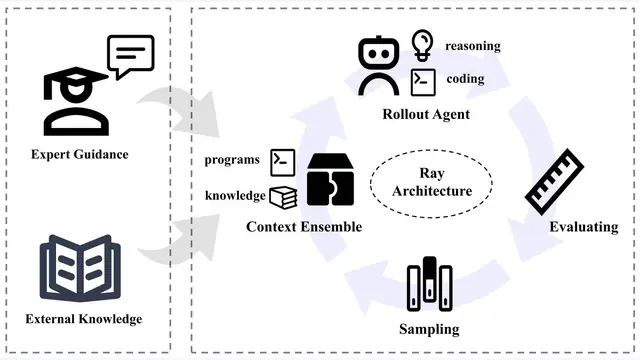
The FM Agent
本文提出一个名为FM Agent的通用多智能体框架,该框架创新性地结合了大型语言模型(LLM)的推理能力和大规模进化搜索,以自动化方式在运筹优化、机器学习、GPU内核优化和数学问题等多个领域解决复杂的现实世界挑战,并取...
AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出一个名为FM Agent的通用多智能体框架,该框架创新性地结合了大型语言模型(LLM)的推理能力和大规模进化搜索,以自动化方式在运筹优化、机器学习、GPU内核优化和数学问题等多个领域解决复杂的现实世界挑战,并取...
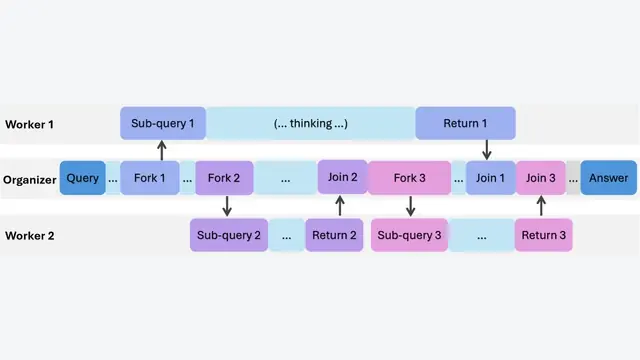
本文提出了一种名为 AsyncThink 的新推理范式,它允许大型语言模型通过一种“组织者-工作者”协议,将复杂的思考过程分解为可并发执行的子任务,并通过强化学习自主学会如何优化这种异步协同结构,从而在降低推理延迟的同...
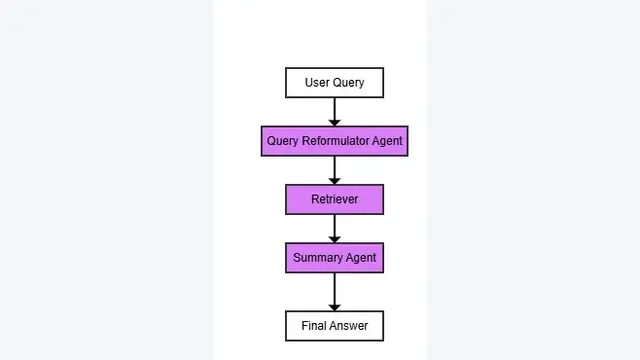
本文提出了一种专为金融科技(Fintech)领域设计的智能体化检索增强生成(Agentic Retrieval-Augmented Generation, A-RAG)架构,通过一个由专业智能体组成的模块化、迭代式流水...
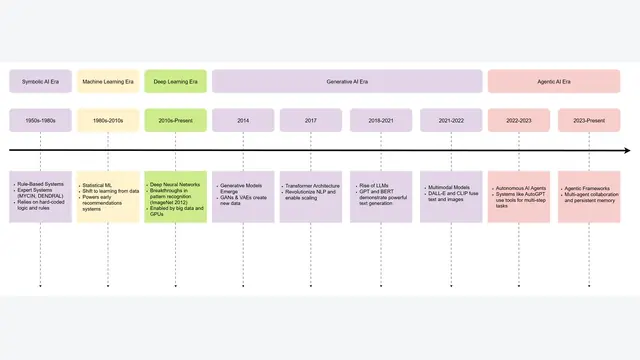
Agentic AI综述从符号/经典与神经/生成两条技术谱系梳理智能体架构,解释规划、决策及工具交互的不同实现方式。本文解读其分类框架、典型应用和未来方向,帮助区分不同类型智能体的能力来源与适用边界。
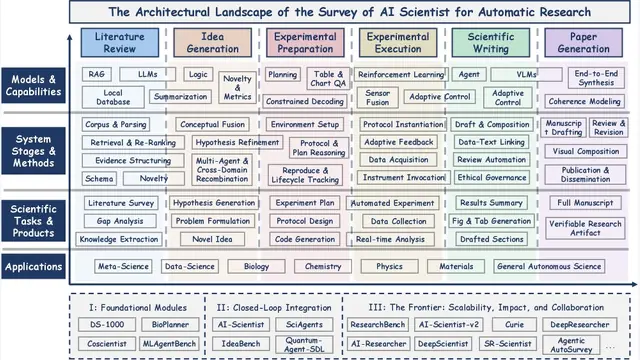
本文首次对新兴的 AI 科学家 (AI Scientist) 领域进行了系统性综述,提出了一个统一的六阶段科学工作流框架,并基于此框架梳理了从 2022 年到 2025 年的关键研究,揭示了该领域从基础模块化、闭环集成...
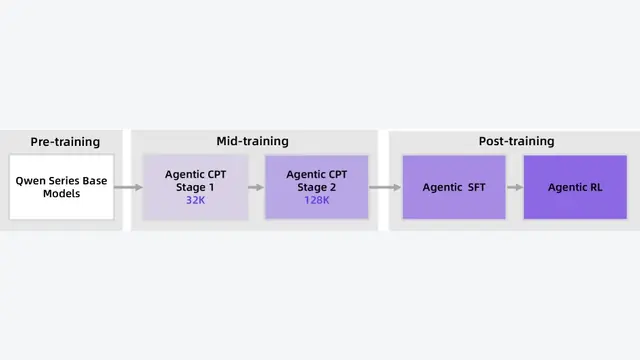
本文介绍了通义深搜(Tongyi DeepResearch),一个开源的AI研究智能体,它通过创新的“智能体中训练”与“智能体后训练”两阶段训练框架,结合可扩展的合成数据引擎,实现了领先的深度研究能力。
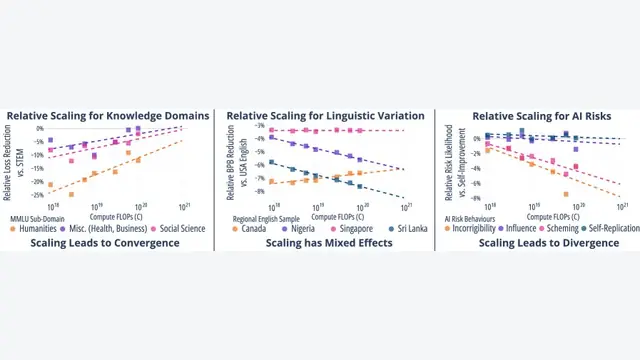
本文提出了一种名为“相对缩放定律 (Relative Scaling Laws)”的新框架,用于量化随着计算规模的增加,不同数据分布上的性能差距如何演变,揭示了规模增长并非普适的均衡器,其影响因领域而异。
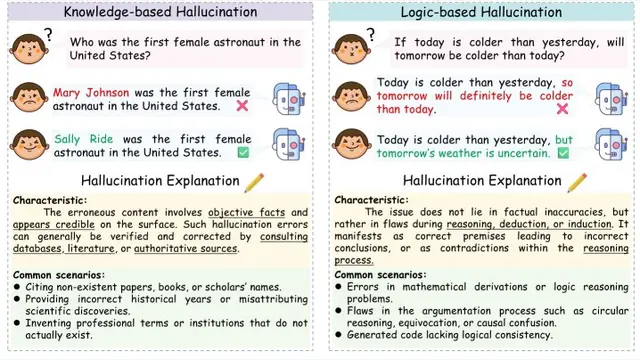
本文是一篇以应用为导向的综述,系统性地分析了检索增强生成(RAG)、推理增强以及智能体(Agentic Systems)系统如何通过提升模型能力来缓解大型语言模型(LLM)中的知识型和逻辑型幻觉。
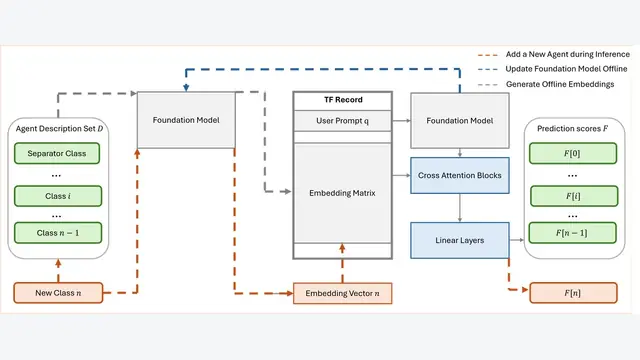
本文提出了一种名为“智能体元编排器” (Agentic Meta-Orchestrator, AMO) 的新架构,用于构建可扩展的多任务Copilot服务,该架构通过学习排序模型进行智能体路由,利用LoRA臂实现高效多...
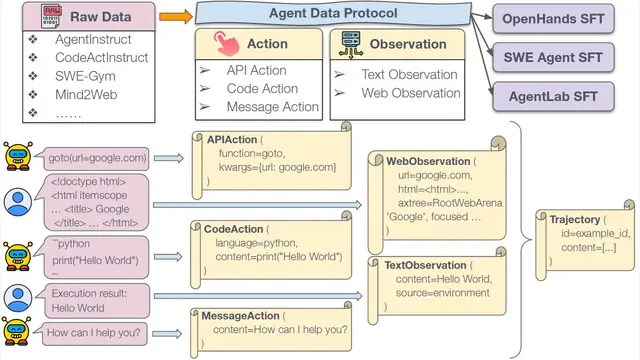
本文提出了一种名为智能体数据协议 (Agent Data Protocol, ADP) 的轻量级表示语言,它通过将来自不同来源、格式各异的智能体训练数据统一为标准模式,解决了数据碎片化问题,从而实现了对大型语言模型智能...
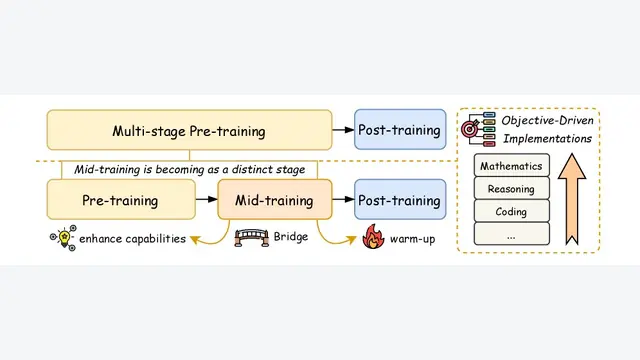
当代大型语言模型 (LLM) 的开发已从单一的预训练模式演变为复杂的多阶段优化框架。预训练通过接触大规模多样化语料库为模型奠定基础能力,而后续的优化阶段则系统性地增强特定能力。中间训练 (mid-training) 作...
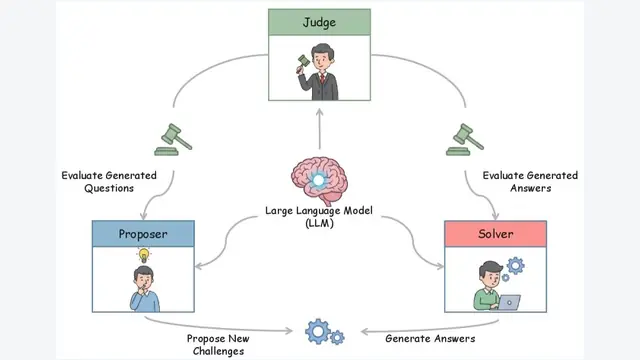
本文提出了一种名为“多智能体进化 (Multi-Agent Evolve, MAE)”的框架,通过让单个大语言模型扮演提问者 (Proposer)、解答者 (Solver) 和裁判 (Judge) 三个协同进化的角色,...
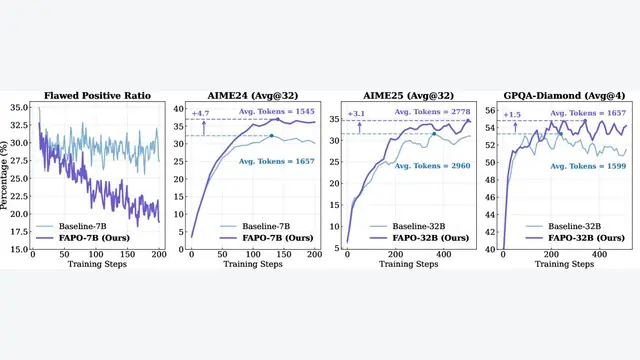
本文提出了一种名为缺陷感知策略优化 (FAPO) 的方法,通过训练一个生成式奖励模型(GenRM)来识别并惩罚那些最终答案正确但推理过程有误的“缺陷正样本”,从而在不增加Token预算的情况下,提升大型语言模型在强化学...
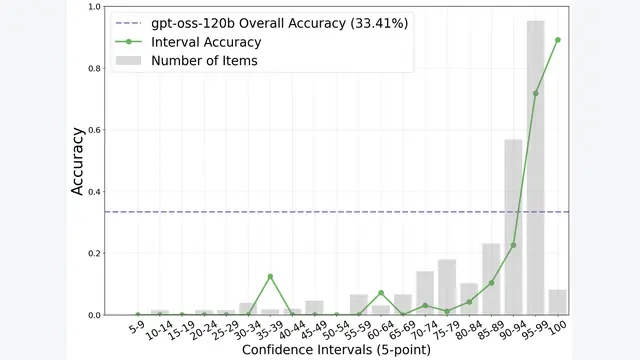
本文提出了一种名为 BrowseConf 的测试时扩展 (Test-Time Scaling, TTS) 方法,它通过利用大语言模型智能体对其回答的“口头表述置信度” (Verbalized Confidence),来...
本文通过将智能体(Agent)的内存架构与乔姆斯基层级(Chomsky hierarchy)中的抽象机进行类比,建立了一套形式化等价框架,指出智能体的计算能力和可验证性由其内存类型(无内存、堆栈、无限读写内存)决定,从...
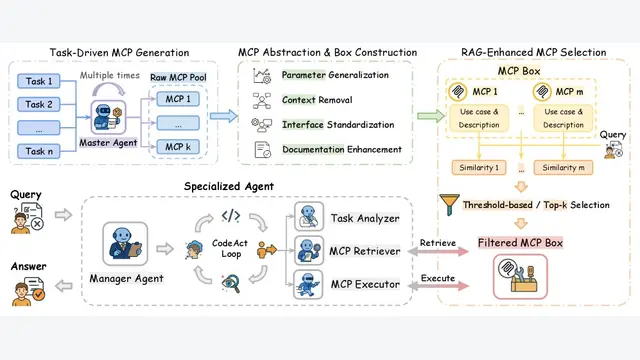
本文提出了Alita-G,一个自进化生成智能体框架,它通过系统性地生成、抽象和管理一系列称为模型上下文协议(Model Context Protocol, MCP)的工具,将一个通用智能体转化为特定领域的专家,从而在提...
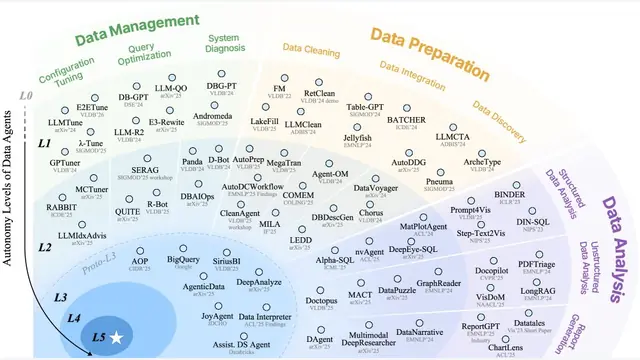
随着大型语言模型 (Large Language Models, LLMs) 的兴起,一种新的范式——数据智能体 (Data Agents)——应运而生。数据智能体被定义为一个综合性的、由LLM驱动的架构,它能自主协调...
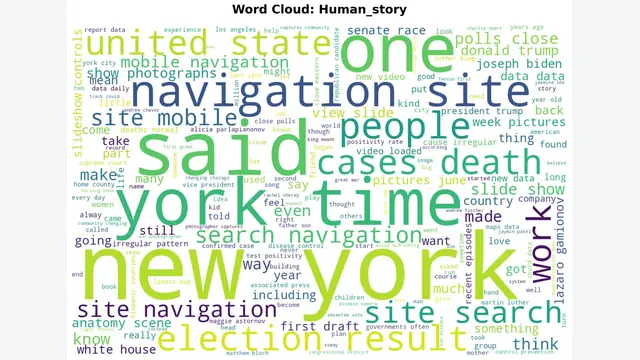
本文发布了一个包含超过58000条文本的大型数据集,其中包含真实的《纽约时报》文章以及由六种先进大语言模型(LLMs)生成的对应版本,并为区分人类与AI文本以及AI文本模型溯源这两个任务提供了基准性能。
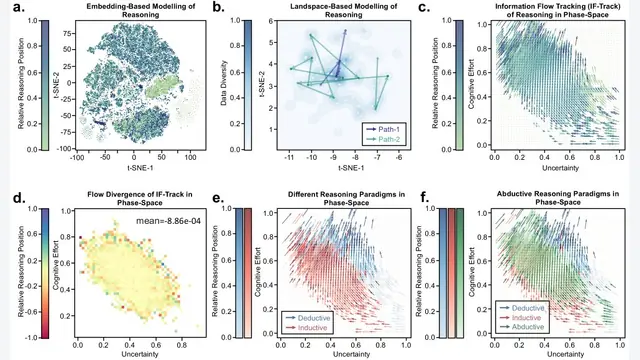
本文提出了一种名为“信息流追踪”(Information Flow Tracking, IFT)的框架,该框架利用大语言模型(LLM)作为概率编码器,通过量化推理每一步的信息熵和信息增益,首次在统一的度量空间中对人类通...
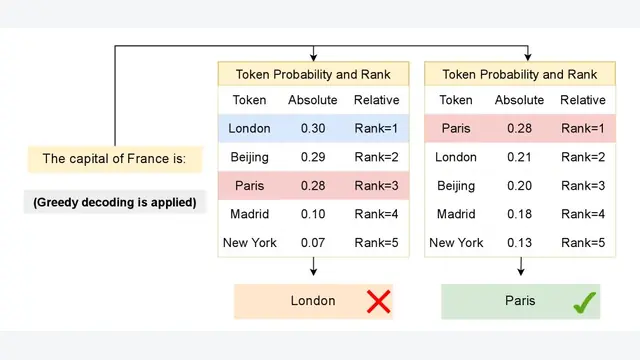
本文提出了一种基于相对排序的新指标——相对概率(RBP),并据此建立了相对标度律(Relative-Based Scaling Law),该定律揭示了模型将正确答案排在靠前位置的能力如何随模型规模的增大而遵循幂律提升,...
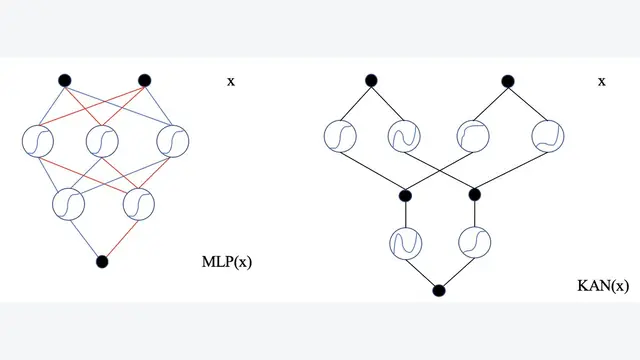
本文提出了一种名为 KCM (KAN-Based Collaboration Models) 的大-小模型协同框架,它利用一个基于 Kolmogorov-Arnold Network (KAN) 的小型判断模型,智能地...
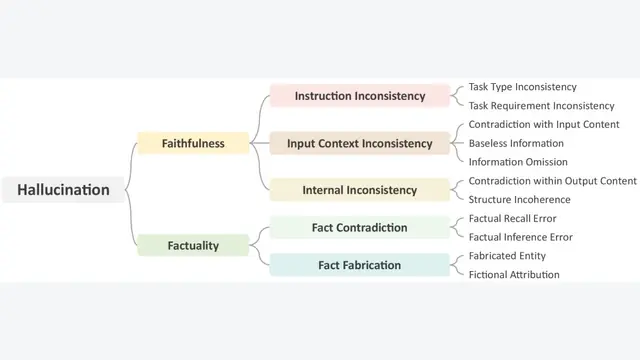
本文提出了一个全面的幻觉分类体系,并基于此构建了一个大规模合成数据集,用以训练 模型,使其能够在一个统一的推理过程中完成幻觉分类、范围识别和内容纠正。
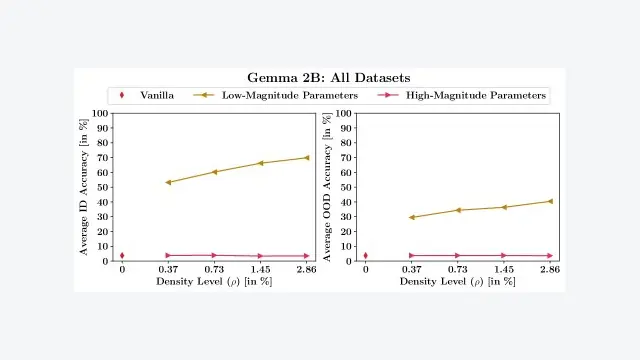
本文提出了一种名为 GaLLoP 的稀疏微调新方法,它通过优先选择在下游任务上梯度最大、且在预训练模型中权重绝对值最小的参数进行微调,从而在提升任务性能的同时有效保留预训练知识,实现了卓越的分布内(ID)和分布外(OO...
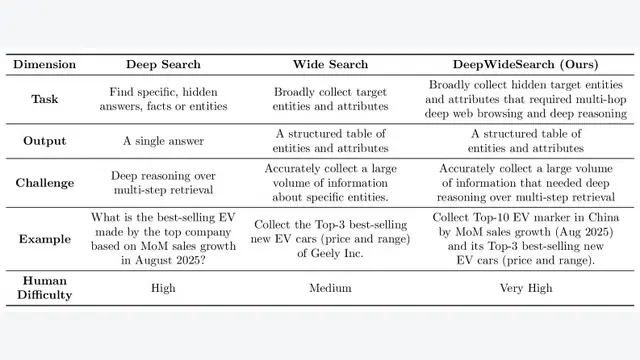
现有用于评估智能体的基准测试主要沿着两个维度发展:搜索宽度与搜索深度。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。