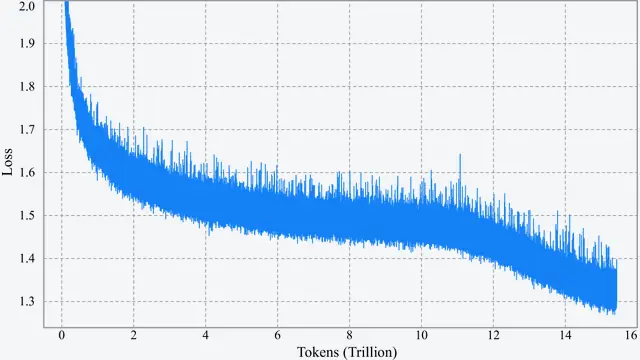
Kimi K2重磅开源:万亿参数与MuonClip重塑Agent智能
大语言模型正经历从静态模仿向主动交互的深刻变革。这标志着智能体(AgenticIntelligence)时代的全面开启。在此范式下,模型必须学会在复杂多变的环境中自主感知、规划、推理并采取行动。然而,打造极致的智能体能...
模型训练AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
大语言模型正经历从静态模仿向主动交互的深刻变革。这标志着智能体(AgenticIntelligence)时代的全面开启。在此范式下,模型必须学会在复杂多变的环境中自主感知、规划、推理并采取行动。然而,打造极致的智能体能...
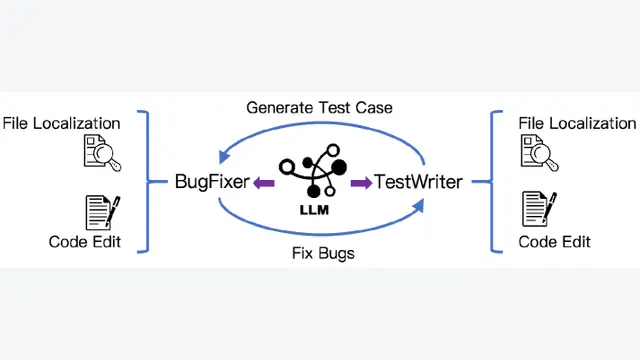
在代码大模型领域,长期存在着一条隐形的界线。一边是按部就班的工作流方法,另一边是自由探索的智能体框架。难道鱼与熊掌真的不可兼得?本文提出的Kimi-Dev给出否定答案。该研究在SWE-benchVerified榜单上拿...
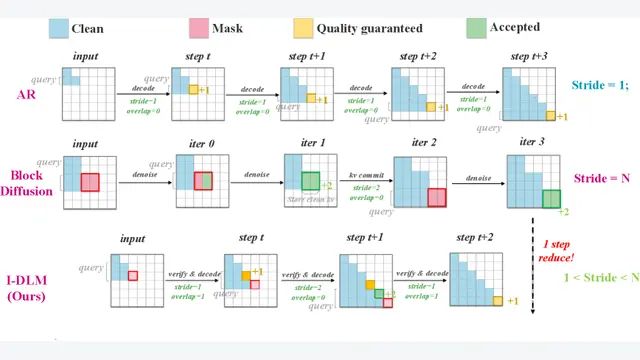
大语言模型的世界一直被逐字生成的自回归机制统治。虽然扩散模型承诺了令人兴奋的并行生成前景,但它们在文本质量上始终无法与自回归模型抗衡。为什么扩散模型在图像领域大杀四方,在文本生成领域却总是“差一口气”?
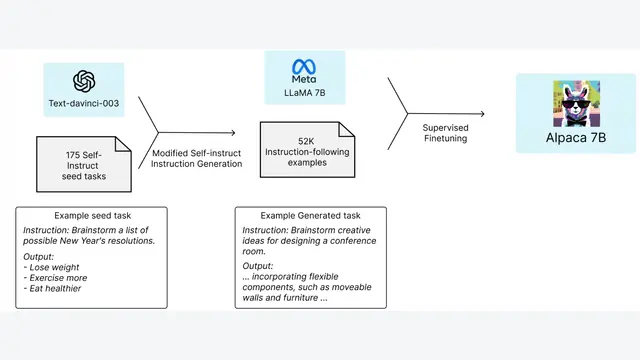
大型语言模型(LLM)的原始形态,本质上是一个极其庞大的“文字接龙”机器。它们通过海量语料学会了预测下一个词,却并不知道如何满足用户的真实业务需求。当用户输入“帮我写一封辞职信”时,原始模型可能会补充“,你需要注意以下...
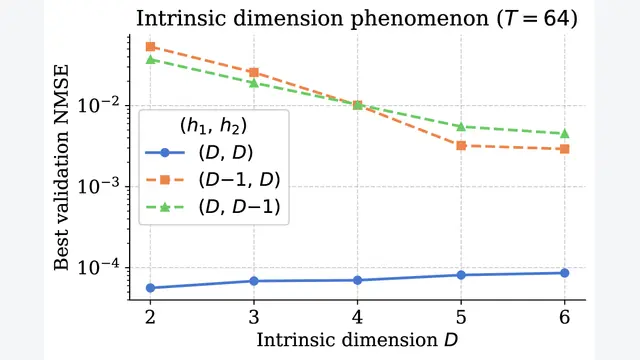
Transformer架构无疑是当今AI繁荣的绝对基石。然而,面对动辄数十乃至上百层的庞然大物,理论界却长期陷入一种尴尬的“偏科”状态。目前,学界对单层Transformer的数学性质已经有了相对透彻的理解,但多层Tr...
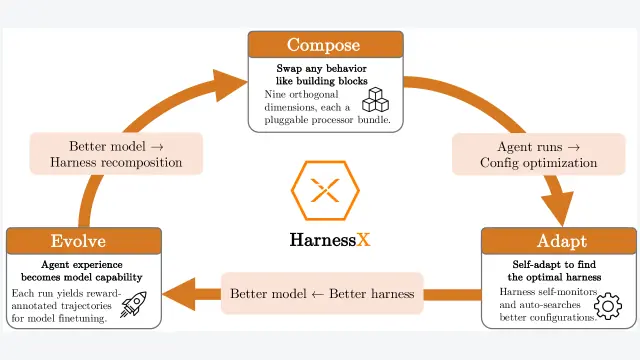
目前开发AIAgent,最痛苦的环节莫过于“手搓”外挂代码。换个新模型,提示词模板可能得全部重写。加个新工具,原本顺畅的控制流直接崩溃。大量在运行中产生的报错记录和轨迹,最后只能被当成垃圾数据扔掉。究竟有没有一种方法,...
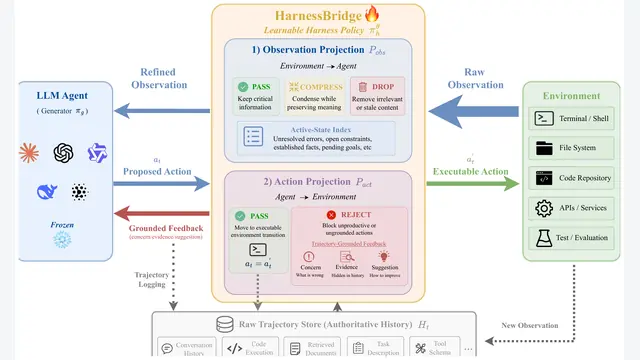
随着上下文窗口越来越长,大模型在长周期任务中依然常常迷失。它们要么被历史交互中堆积如山的无效信息淹没,要么陷入死循环,疯狂消耗宝贵的API额度。过去,为了解决这个问题,开发者们通常会手写一套复杂的脚手架(Harness...
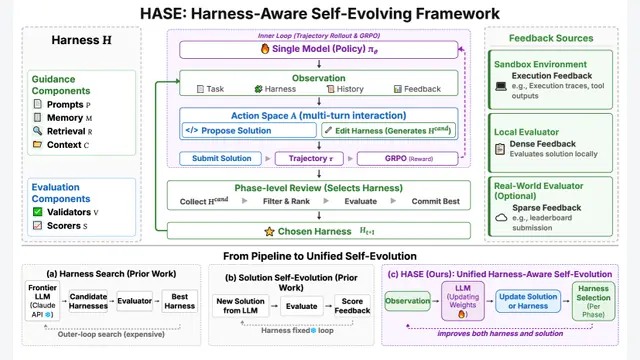
为什么仅有80亿参数的小模型,能够在极其复杂的代码生成任务中,击败1200亿参数的巨头大模型?当常规的AI系统都在绞尽脑汁地优化“如何解答问题”时,一项前沿研究揭示了降维打击的秘密。那就是:直接赋予模型“修改考卷”和“...
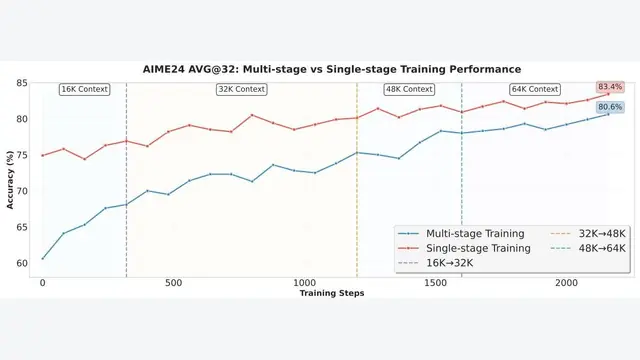
当前,大语言模型正从被动响应的知识库,向主动解决现实难题的通用求解器跨越。实现这一跨越的核心,在于彻底打通智能体、逻辑推理与代码这三大核心能力。然而,闭源巨头在特定领域表现惊艳,开源界却始终缺乏一个能统一上述能力的轻量...
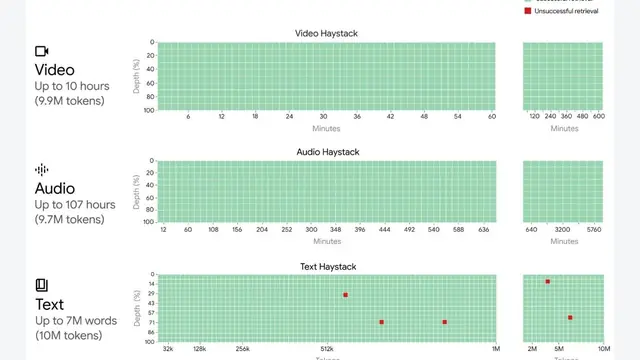
大模型领域的“军备竞赛”正从参数量向上下文窗口急剧转移。当业界还在为几十万Token的窗口欢呼时,谷歌丢出了一枚重磅炸弹。该研究正式推出了Gemini1.5系列模型,最高支持令人咋舌的1000万Token的上下文。这意...
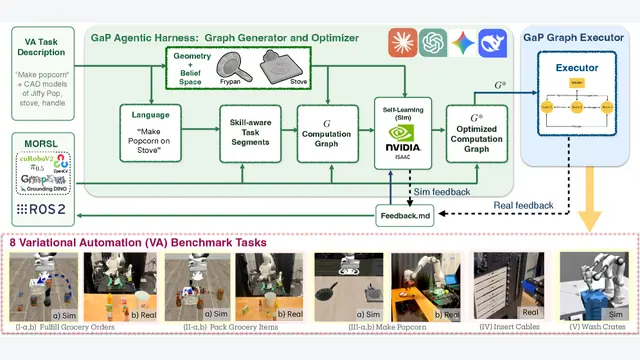
当前,端到端的视觉-语言-动作大模型在通用机器人领域风头正盛。然而,当这些模型真正走入商业和工业流水线时,往往会遭遇“水土不服”。在真实的工厂或商用厨房中,机器人需要日复一日地执行极高可靠性的任务。传统的“黑盒”大模型...
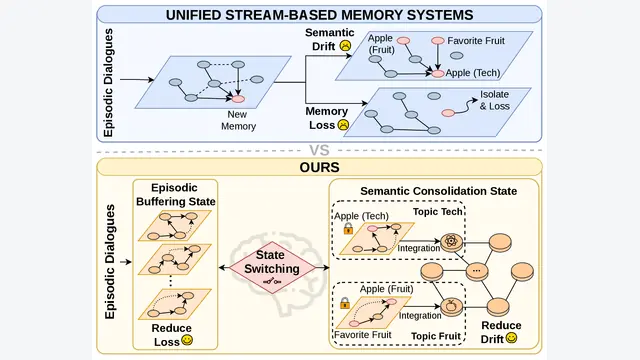
当前的大语言模型虽然能在单次对话中对答如流。但一旦进入长期交互,它们常常会陷入“记了新的,忘了旧的”的窘境。现有的记忆系统大多采用统一流式更新。这意味着每一次日常闲聊的噪音,都可能直接污染已经建立的核心知识库。如何让A...
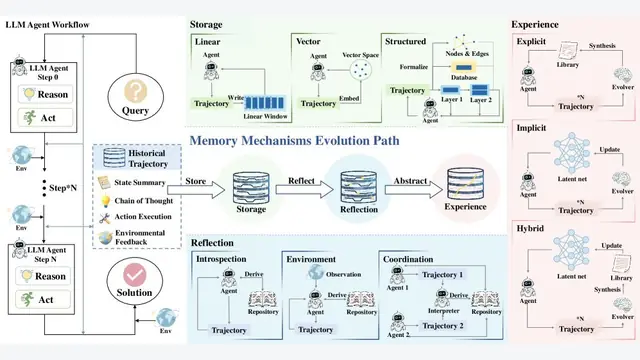
很多开发者在构建大模型智能体时,常会遇到一个非常棘手的问题。给智能体配备了外部工具,写了超长的提示词,但它在多步复杂任务中依然会“断片”。它要么在同一个地方重复犯下逻辑错误,要么在动态变化的环境中彻底迷失了最初的目标。...
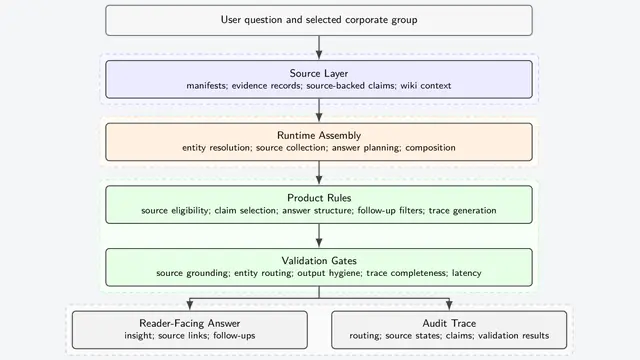
许多企业级大模型应用在原型阶段表现惊艳,往往只需一段系统提示词加上基础的检索增强生成(Retrieval-AugmentedGeneration,RAG)就能在演示环境跑通业务逻辑。然而一到真实商业环境落地,合规溯源、...
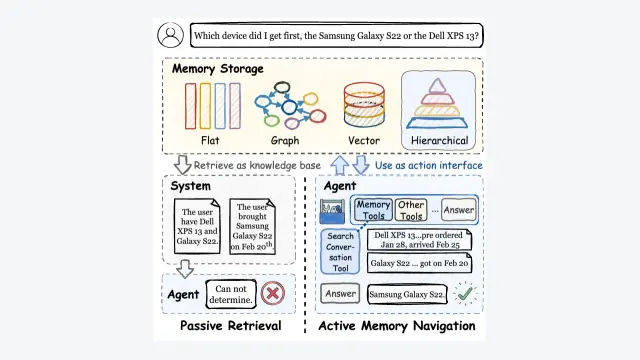
当你和一个AI助手交流了数月甚至数年,你期望它能建立起对你的深度理解。然而,当前大多数基于大型语言模型(LargeLanguageModel,LLM)的长期记忆系统,依然依赖于被动的检索接口——即系统在后台悄悄检索几段...
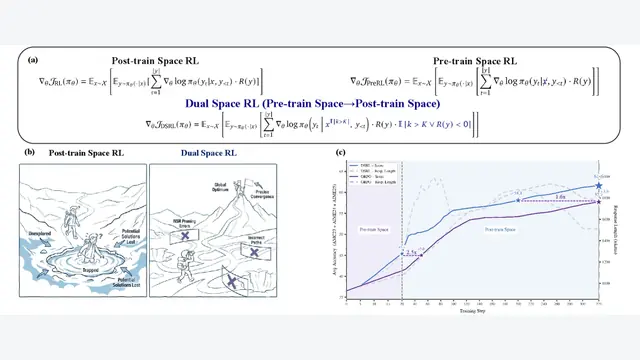
以DeepSeek-R1为代表的卓越模型,将基于可验证奖励的强化学习(RLVR)推向了整个行业的聚光灯下。然而,这种后训练范式隐藏着一个不容忽视的致命瓶颈。它通过优化条件分布来提升推理能力,这意味着其潜力被基座模型现有...
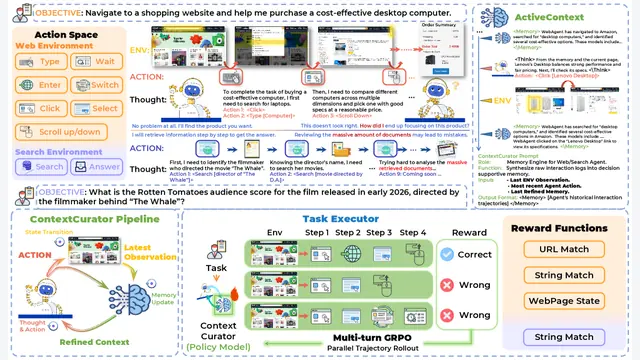
当前,各大AI厂商都在疯狂内卷大语言模型的上下文窗口长度,百万级Token的输入似乎已经成为前沿模型的标配。然而,仅仅给模型塞入海量的上下文,它就真的能完美处理长周期的复杂任务吗?
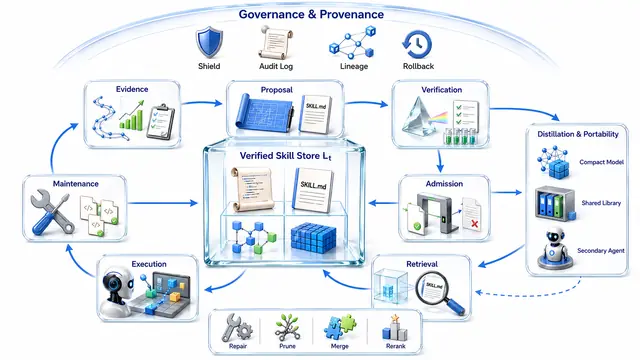
当大语言模型从简单的对话助手,逐步深入并接管实际的工作流时,一个严峻的核心瓶颈浮出水面。这种瓶颈并非模型单次推理能力的不足,而是智能体(Agent)能否在重复性任务中复用过程知识。如果每次遇到相似任务,智能体都要在有限...
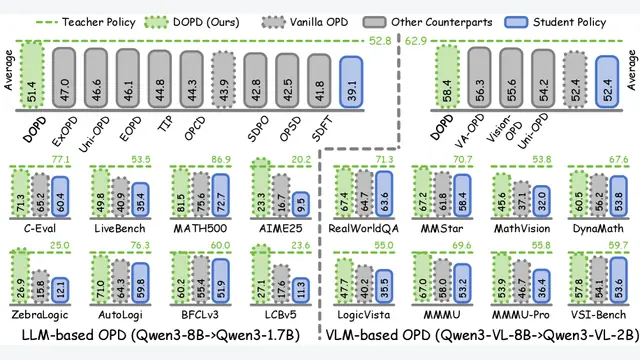
为什么给大模型“开小灶”,它反而越学越傻?在如今的大模型后训练阶段,用一个强大的“老师”模型来指导一个较弱的“学生”模型,已经成为提升性能的标准操作。为了让老师教得更好,研究人员往往会给老师提供一些特权信息(Privi...
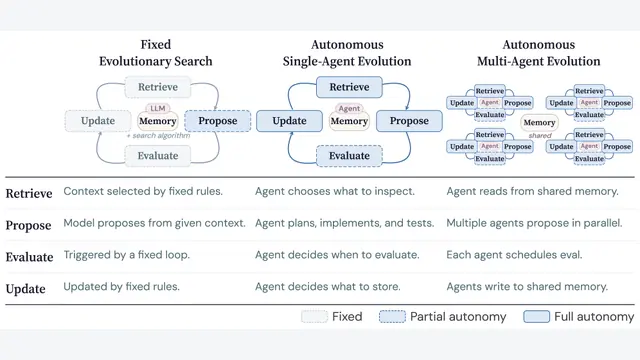
解决没有标准答案的开放性科学难题,一直被视为人工智能迈向更高级形态的试金石。面对复杂的物流调度或底层的系统内核优化,传统的“单次生成”模式早已捉襟见肘。近年来,将大语言模型嵌入进化算法循环中,成为了破局的新希望。然而,...
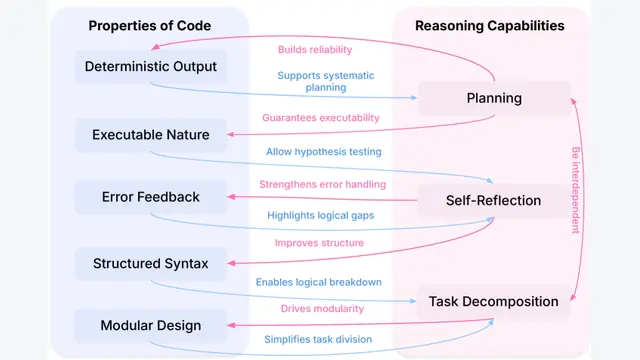
近期,以OpenAI-o1和DeepSeek-R1为代表的新一代大型语言模型,在复杂任务中展现出了惊人的逻辑求解能力。业界逐渐观察到一个反直觉却极其有趣的现象:让大模型学习编写程序,竟能跨领域地大幅提升其解决数学和逻辑...
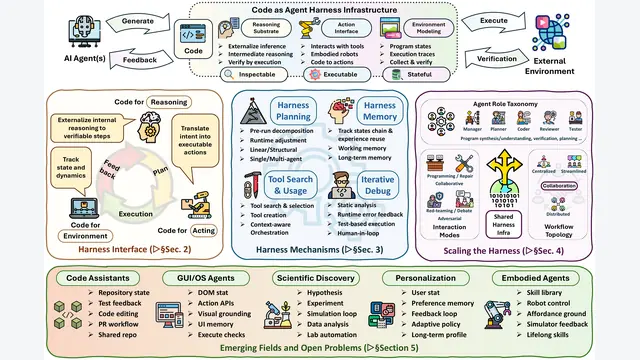
长期以来,业界对大模型代码能力的关注点,大多停留在“AI写代码”这一单一结果上。人们惊叹于模型能通过算法竞赛,或者能写出精妙的前端网页。但在Meta、斯坦福大学和UIUC的最新联合研究中,这一固有认知被彻底打破。他们提...
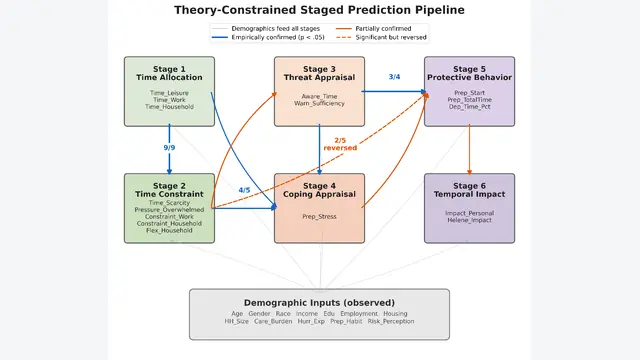
现如今,发一份在线问卷,你收回的可能是大量机器刷单、AI辅助作弊以及随意乱填的“无效数据”。这种数据质量危机正在悄无声息地摧毁社会科学的基石。在争分夺秒的灾害响应研究中,情况更为致命。受灾最严重的人往往处于断网、流离失...
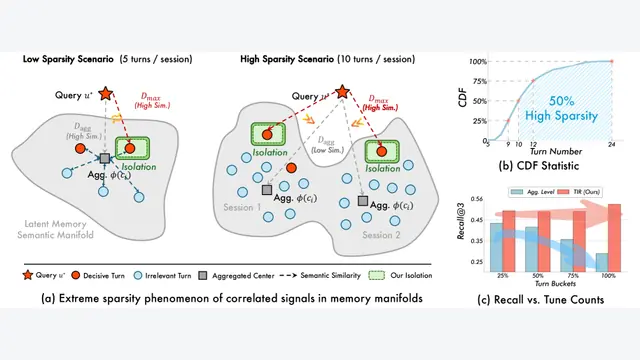
随着智能体与用户的交互日益频繁,让大语言模型记住几个月甚至一年前的冗长对话,已成为各大研究团队竞相攻克的难题。为了实现这种长期记忆,现有的主流方案往往走向了无休止的“堆料”之路。从极其复杂的层次化摘要,到繁琐的强化学习...