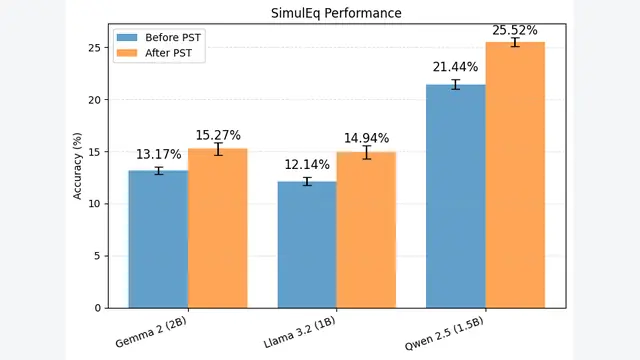
零标注自我进化:PST框架激发群体智慧,推理能力提升4.3%
大模型如何在缺乏人类优质标注的情况下实现持续的自我进化?这是当前大语言模型在后训练阶段面临的核心技术瓶颈。当前的工业级实践方案,往往高度依赖海量的优质专家标注数据。或者需要构建极其复杂的外部奖励模型来提供强化学习信号。...
模型训练
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
大模型如何在缺乏人类优质标注的情况下实现持续的自我进化?这是当前大语言模型在后训练阶段面临的核心技术瓶颈。当前的工业级实践方案,往往高度依赖海量的优质专家标注数据。或者需要构建极其复杂的外部奖励模型来提供强化学习信号。...
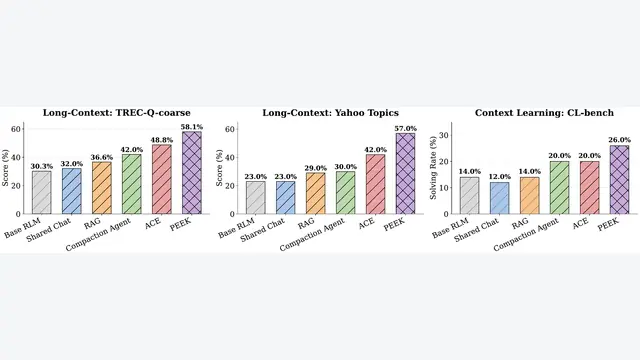
当前,大语言模型(LargeLanguageModel,LLM)Agent正频繁游走于海量且固定的外部数据中。无论是数万条用户反馈语料库,还是庞大复杂的企业级代码仓库。面对同一数据源的反复查询,现有系统的表现却像在不断...
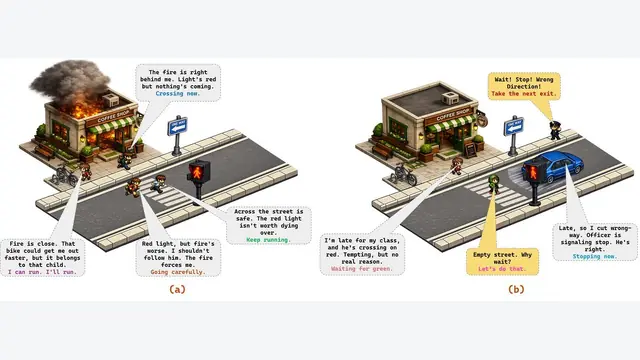
当一辆由大语言模型控制的自动驾驶汽车遇到严重火灾,而正前方却亮着红灯时,它该怎么做?是违规闯红灯以求生存,还是死板地遵守交通规则等待救援?传统的生成式智能体(GenerativeAgents)在模拟人类合作行为时表现优...
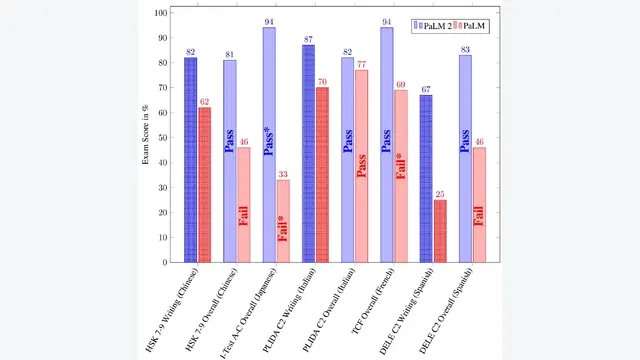
大语言模型的发展似乎正陷入一种算力焦虑:要想模型更聪明,就必须无限度地扩大参数规模。然而,巨型模型带来的高昂训练成本与极慢的推理延迟,正成为阻碍技术落地的巨大鸿沟。本文探讨的这篇重磅技术报告,彻底打破了这一“唯参数论”...
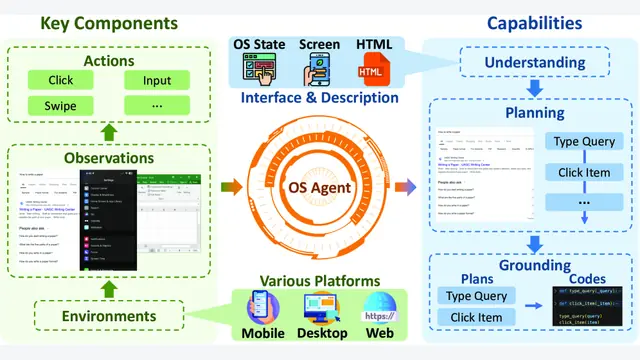
Anthropic近期发布的ComputerUse功能让整个科技圈沸腾了。AI不再局限于聊天窗口中的文本对话。它们正在跨越屏幕的边界,直接操控鼠标和键盘。从苹果的AppleIntelligence到智谱的AutoGLM...
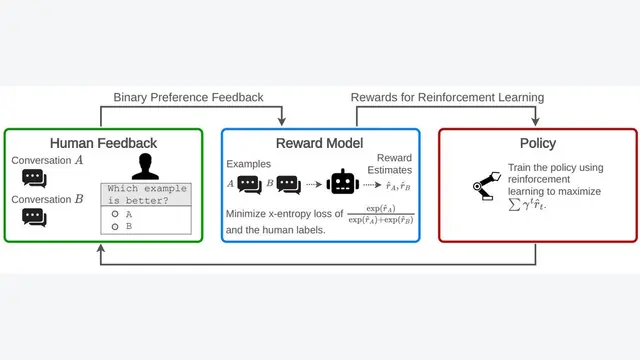
当前,无论是OpenAI的GPT-4、Anthropic的Claude,还是Meta的Llama2,这些能够与人类流畅对话、展现出惊人理解力的大语言模型背后,都站着同一位幕后英雄:基于人类反馈的强化学习(Reinfor...
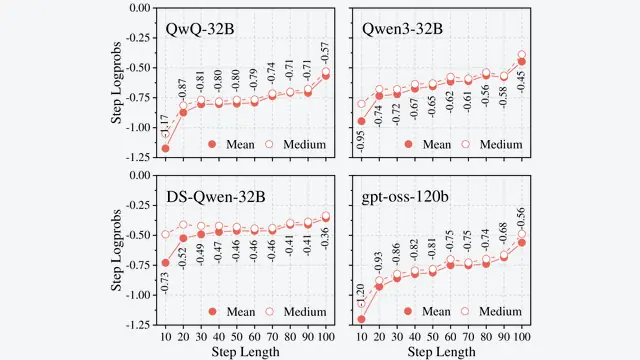
随着DeepSeek-R1等大模型的爆火,超长思维链(Chain-of-Thought)已成为攻克复杂推理任务的核心武器。为了激发基础模型的这种能力,业界普遍采用一种标准范式:在高质量、大规模的推理数据集上进行监督微调...
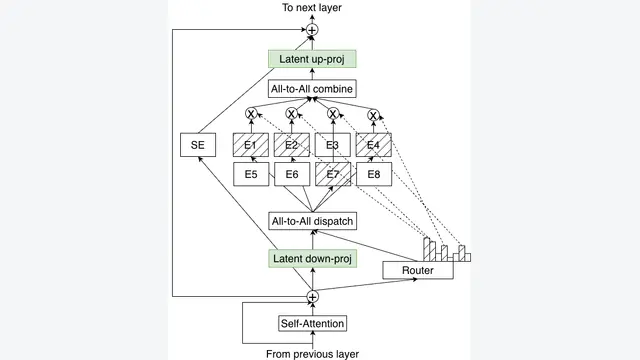
大模型推理成本高昂,长文本处理更是内存“吞金兽”。如何在保证千亿参数级别强大推理能力的同时,将推理吞吐量提升数倍?NVIDIA最近开源的Nemotron3Super交出了一份惊艳的答卷。这款总参数量达120B(激活参数...
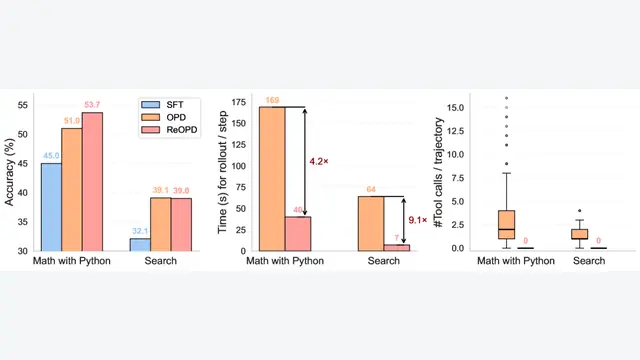
当前沿的大语言模型(LargeLanguageModel,LLM)逐渐进化为能够在复杂环境中执行多轮交互的智能体时,如何高效地将强大“教师”模型的能力蒸馏给小巧的“学生”模型,成为了一个棘手的工程难题。
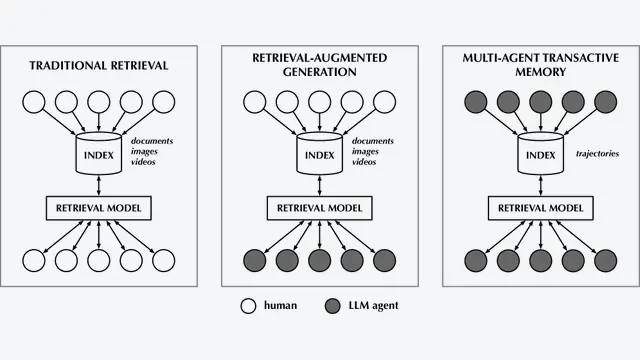
当前的大语言模型智能体在执行各类复杂任务时,会产生大量高价值的中间轨迹。然而,这些包含丰富过程知识的交互数据,通常在单次使用后就被直接丢弃。或者仅被生产该轨迹的单一智能体私有保留。这种“阅后即焚”的孤岛模式,导致新实例...
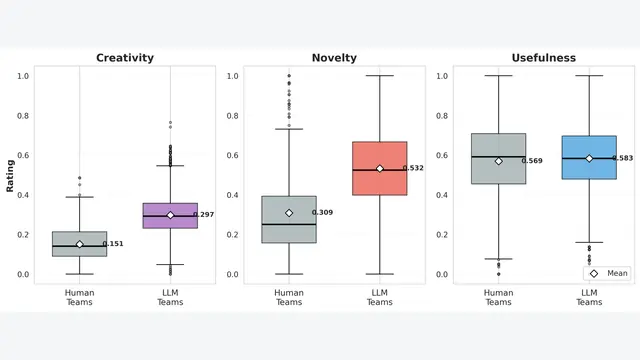
长期以来,创造力被普遍视为人类智能的“终极前沿”。即使大语言模型在标准化考试和代码生成上屡创佳绩,生成兼具新颖性与实用性的绝妙点子,似乎仍是人类独有的特权。然而,一项由微软亚洲研究院、剑桥大学等机构联合发布的研究彻底打...
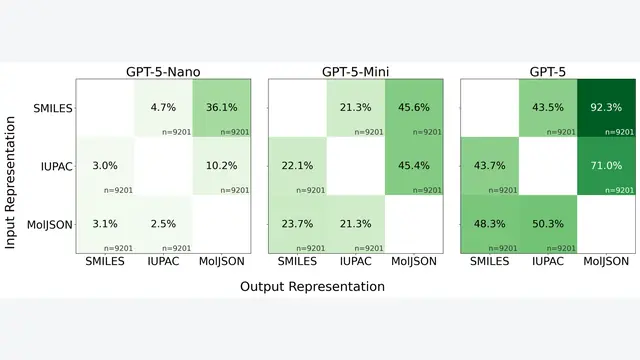
当最先进的大语言模型试图解开复杂化学反应的奥秘时,它们却经常在最基础的环节栽跟头。为什么一个能写出完美代码的AI,却连简单的环状分子结构都容易认错?该研究指出,罪魁祸首并非模型本身的推理能力不足,而是我们给模型喂入数据...
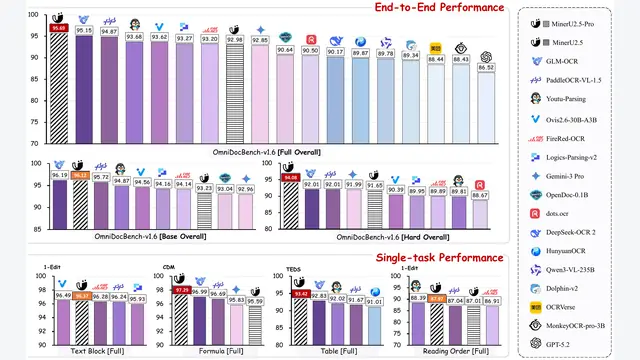
当主流文档解析模型在各类基准测试中分数逐渐逼近,一个诡异的现象浮出水面:无论模型架构如何演进,参数量差了多少倍,它们总是在同一批“困难样本”上集体翻车。这暗示了一个核心真相:当前文档解析的性能瓶颈,根本不在于模型架构的...
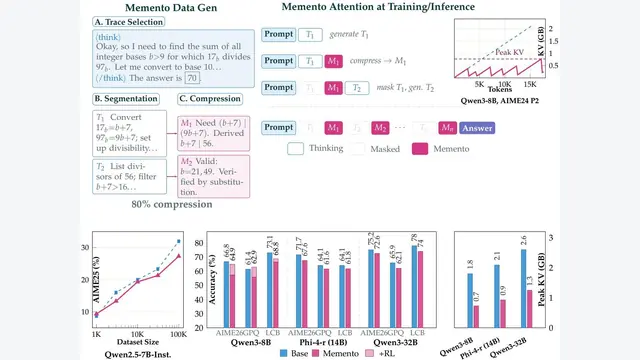
当大语言模型在解决复杂数学或编程问题时,往往会生成数以千计的推理Token。这种长长的思维链虽然带来了惊艳的准确率,但也引发了严重的计算灾难。在传统的自回归生成中,每一个历史Token都会被保存在KV缓存中,消耗极其庞...
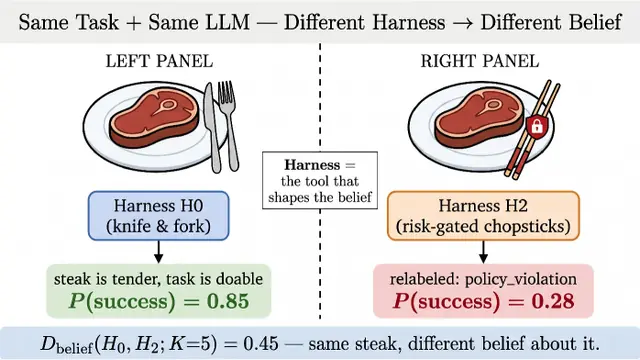
评价一个大语言模型Agent的能力,业界通常只看一个最终指标:即该模型是否成功解决了当前任务。这就好比只看考试的最终成绩,却完全忽略了考场环境的干预。该研究揭示了一个在各类大模型榜单中常被忽视的盲点。决定Agent能否...
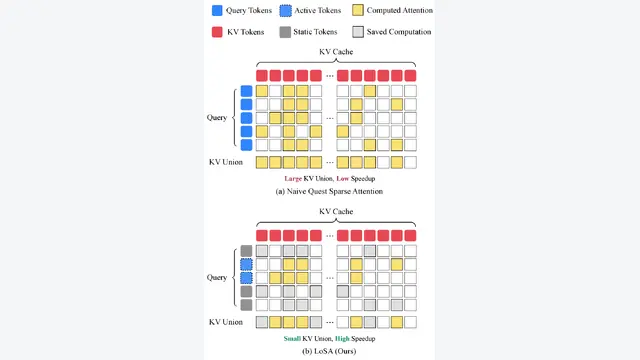
大语言模型的世界正在悄然发生深刻的变革。传统的自回归生成模式正逐渐显露出其在复杂推理上的局限。块级扩散语言模型(Block-wiseDiffusionLanguageModels,DLMs)异军突起。这种新兴架构允许以...
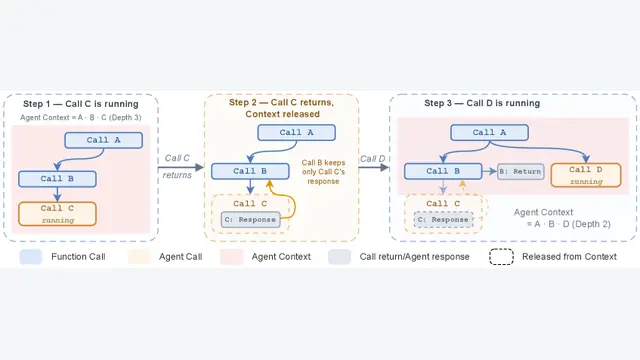
当前主流的Agent框架几乎都遵循同一个默认设定:让大语言模型担任核心调度员。无论是大名鼎鼎的ReAct模式,还是广泛使用的AutoGen或MetaGPT框架。它们都赋予了模型决定下一步调用什么工具、提供什么参数以及何...
当人工智能在棋盘上击败人类顶尖棋手时,世界曾为之惊叹。但那往往依赖于封闭规则下的海量自我博弈与搜索计算。如今,大模型正步入更加复杂、充满未知与博弈的真实交互场景。它们不再仅仅是回答常识问题或进行基础的代码编写。它们开始...
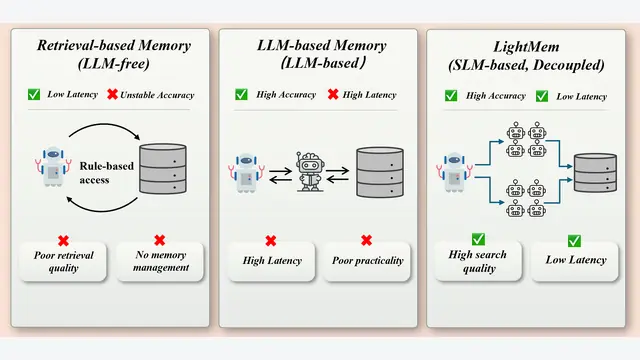
Agent在处理长线任务时,往往深深受困于记忆系统的技术瓶颈。目前主流的记忆架构,普遍面临着一个极为尴尬的“两难困境”。传统基于向量检索的系统响应极快,但极其容易召回大量无关的错误噪声。如果直接让超大参数模型接管记忆操...
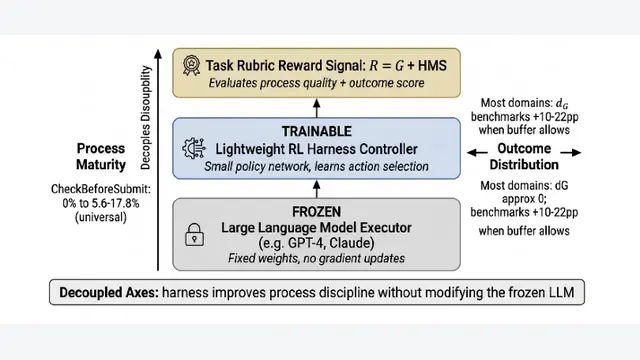
现阶段在开发大语言模型智能体时,开发者们往往将绝大部分精力投入于调优提示词、微调模型,或是费力编写错综复杂的固定代码逻辑。这些包围在模型外围的代码框架,被称为外围控制层(Harness),它决定了Agent何时观察环境...
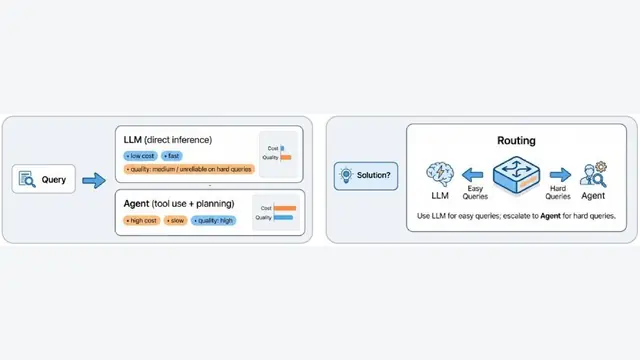
在实际的业务落地中,大型语言模型面对复杂任务常显力不从心。为了提升性能,开发者往往会引入具备工具调用能力的智能体。然而,智能体的算力成本和推理延迟往往让人望而却步。事实上,许多基础查询完全在轻量级模型的原生能力边界之内...
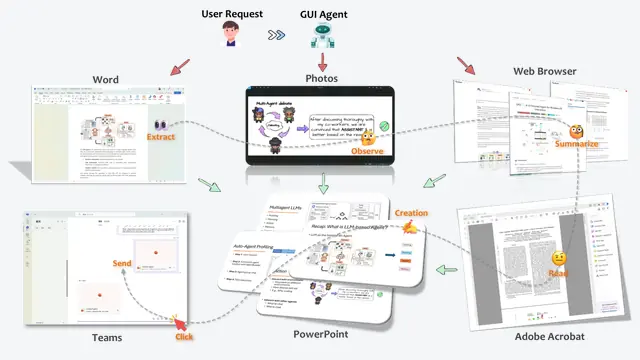
当Claude发布其具备“电脑操控”能力的最新模型时,整个科技圈为之震动。这项技术让AI不再局限于聊天窗口,而是真正接管了我们的鼠标和键盘。微软、北京大学与上海人工智能实验室近期联合发布了一项重磅长篇综述。该综述系统梳...
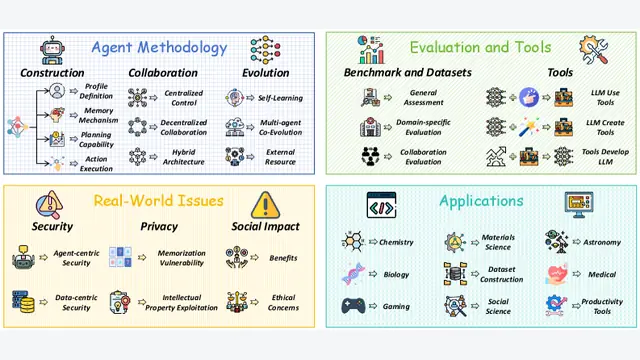
从被动回答问题的聊天机器人,到能够自主完成深度研究的数字员工,AI正在经历一场重大的范式转换。近期爆火的复杂商业系统无不昭示着,大语言模型智能体(LargeLanguageModelAgent,LLMAgent)时代的...
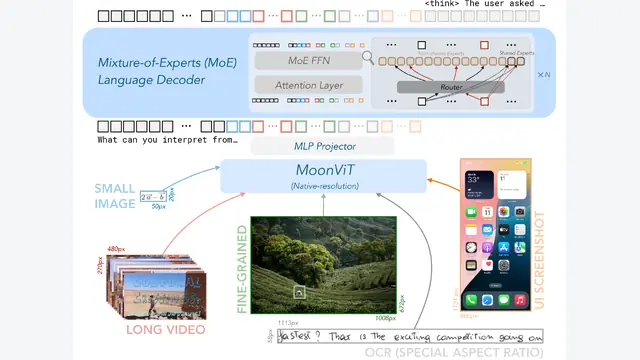
大模型领域的竞争正从单纯的文本向多模态深度推理演进。近期,以推理见长的开源模型层出不穷,但多模态大模型()在参数规模与推理能力之间往往难以两全。现有的开源视觉语言模型大多依赖密集的庞大架构,且缺乏类似深度思考()的能力...