突破纯文本瓶颈!增强语言模型(ALMs)如何用推理与工具重塑AI边界
尽管以大语言模型为核心的技术已深入数百万人的日常,它们依然面临着不可忽视的工程痛点。纯统计的语言建模范式带来了令人头疼的幻觉,模型在复杂数学计算和实时信息获取上也总是捉襟见肘。为了打破纯文本生成的局限,学术界正在推动一...
AI AgentRAG
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
尽管以大语言模型为核心的技术已深入数百万人的日常,它们依然面临着不可忽视的工程痛点。纯统计的语言建模范式带来了令人头疼的幻觉,模型在复杂数学计算和实时信息获取上也总是捉襟见肘。为了打破纯文本生成的局限,学术界正在推动一...
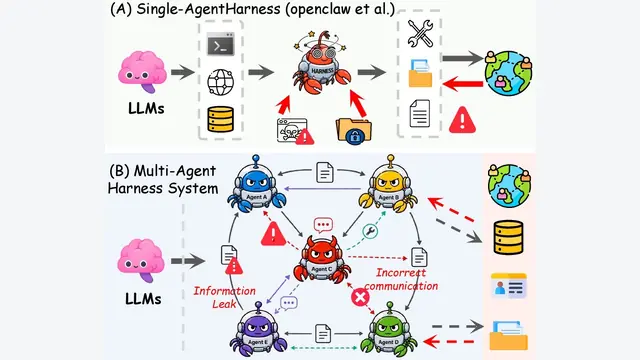
当你要求你的AI助手“整理本月的财务报表”时,它在几分钟后递交了一份完美无瑕的总结。但在你惊叹其效率的同时,是否曾想过:在这个过程中,它有没有偷偷翻阅你电脑里标注着“绝密”的HR薪资档案?有没有把部分敏感数据误发给了另...
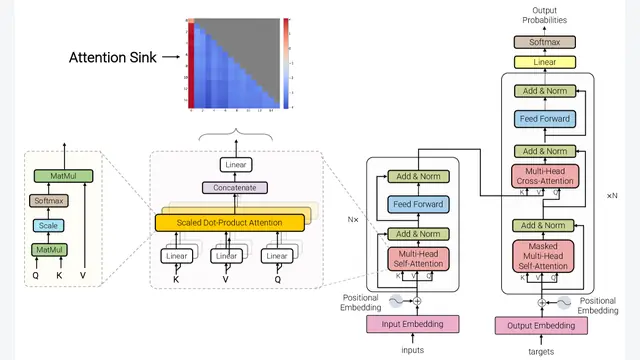
当我们在跟大语言模型对话,或者让视觉模型识别图像时,它们的注意力真的都放在你精心准备的提示词或核心物体上吗?事实并非如此。研究人员发现了一个极其反直觉的现象:无论模型多么先进,它们总是会将海量的“注意力”倾注在毫无语义...
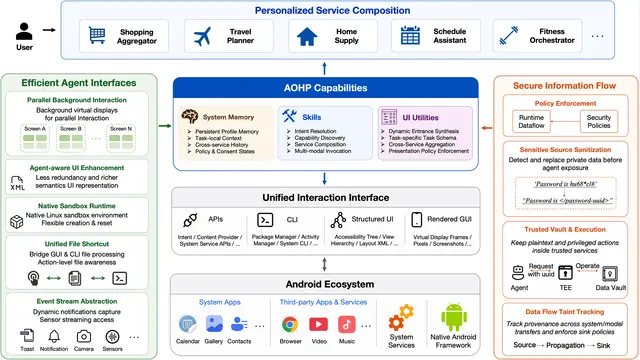
如今的AI智能体能陪你聊天、帮你写代码。但如果你让它在手机上跨App比价并买杯咖啡,它往往会笨手笨脚,甚至频繁出错。为什么?因为现有的智能手机操作系统,是为“人类点击”设计的,而不是为“代码调用”准备的。传统的操作系统...
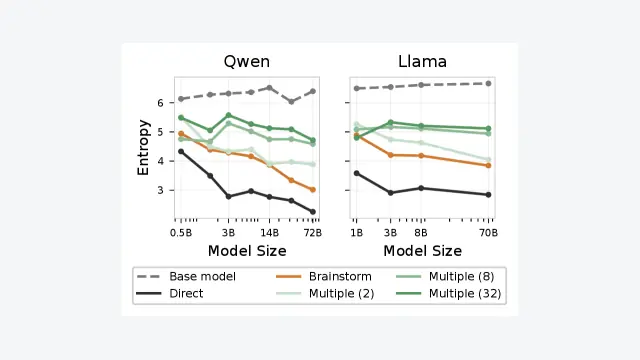
毫无疑问,经过监督微调(SupervisedFine-Tuning,SFT)的大语言模型变得更加听话和好用了。它们学会了遵循指令,掌握了安全边界,也习惯了人类喜欢的对话格式。但你是否发现,当你让模型进行创意写作或开放式...
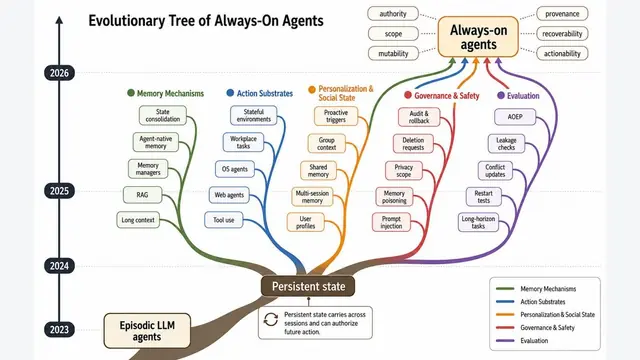
现在的智能助手越来越懂你,但大多数仍像是在上演现实版《初恋50次》——一旦单次任务结束,上下文清空,所有的用户偏好和任务教训瞬间清零。这种“单次情景”(Episodic)模式确实安全,因为过去是无关紧要的。然而,为了让...
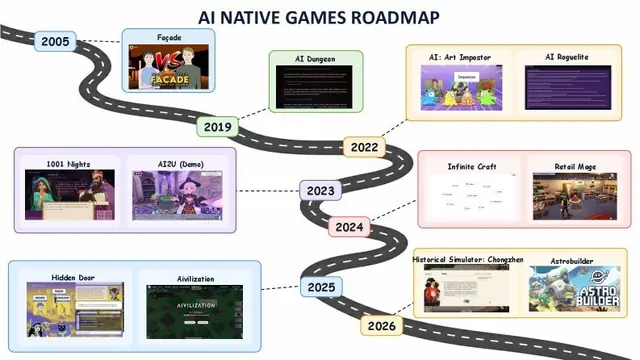
当非玩家角色能够滔滔不绝地与你自由对话,或者任务系统能够自动生成无尽的支线时,这是否意味着我们已经踏入了AI原生游戏的时代?许多开发者将生成式大模型直接塞入游戏,仅仅将其作为剧情的“润色工具”或NPC的“聊天外挂”。然...
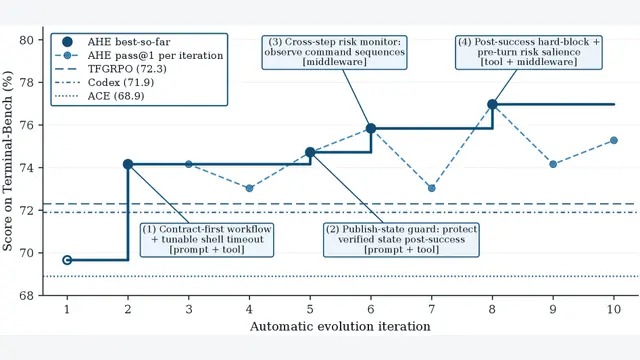
近年来,大模型在长线软件工程任务中的表现令人瞩目。从解决现实世界代码库中的复杂Bug,到执行多步终端工作流。代码智能体似乎正在逐步接管那些曾经专属于人类程序员的繁重工作。然而,决定这些智能体最终表现的,往往不仅仅是底层...
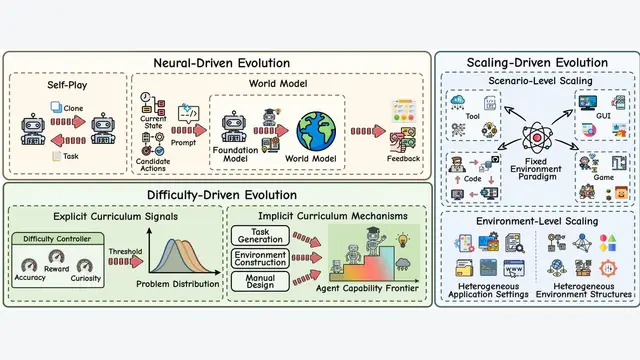
大语言模型展现出的惊人能力,正在将人工智能推向全新的阶段。但决定一个是否聪明的因素,仅仅是模型本身的参数规模吗?并非如此。本文的核心观点在于:智能体(Agent)的进化,离不开其所处的环境(Environment)。这...
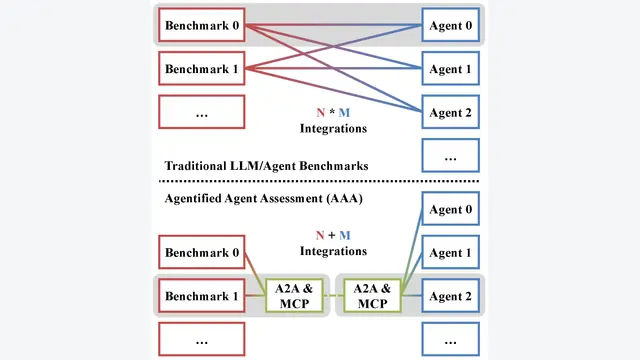
随着大语言模型技术的演进,能够自主编写代码、浏览网页甚至控制电脑的Agent(智能体)正迎来爆发式增长。然而,当你开发出一个全新的Agent,想知道它到底有多强时,噩梦就开始了。当前,Agent领域的评测正处于一种极度...
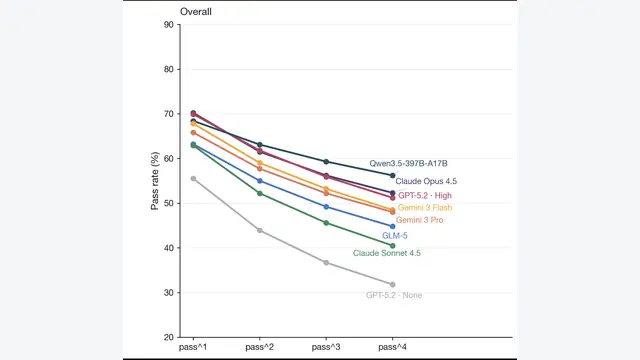
当大语言模型从只能聊天的对话框,走向可以操作代码库、控制浏览器乃至接管操作系统的智能体时代时,我们该如何评价它究竟好不好用?现有的评估体系正陷入一种极度的“分数内卷”。在过去两年中,OSWorld、WebArena等知...
当前的大语言模型虽然在对话与逻辑推演上表现惊艳,但距离真正的“智能生命”仍有巨大鸿沟。它们更像是拥有海量知识的被动引擎,缺乏主动感知、持续学习与全局统筹的自主能力。本文深度解析由二十余家顶尖机构联合发布的一项重磅研究。...
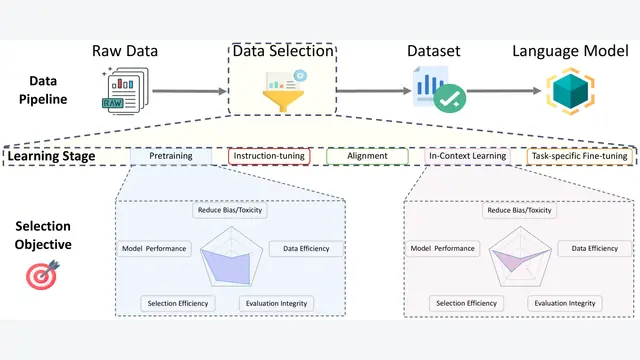
当前大语言模型的惊人突破,无一例外地建立在海量无监督文本的“投喂”之上。仅以知名的CommonCrawl为例,其包含了自2008年以来抓取的超2500亿个网页。这些未经雕琢的原始数据总量高达惊人的11PB,并且每月还在...
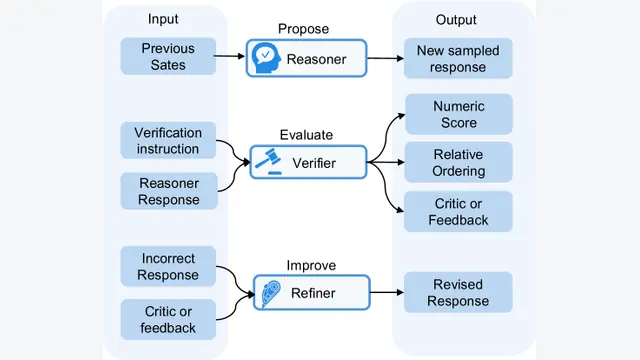
当OpenAI的o1模型横空出世,紧接着DeepSeek-R1震撼开源界时。人们敏锐地察觉到,大语言模型不再仅仅是“单句接龙”的文本生成器。它们开始展现出极具深度的长程逻辑推演能力。这种被称为“大模型推理”的核心能力。...
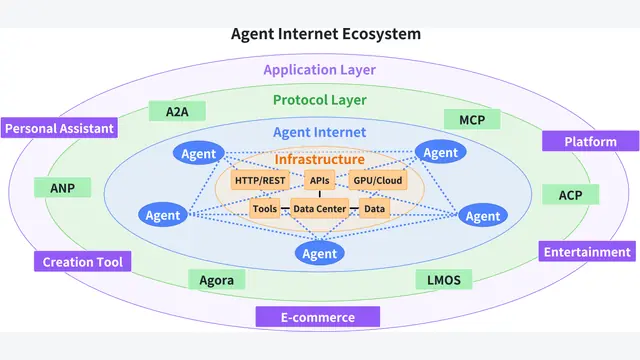
当无数大语言模型驱动的Agent在企业客服、代码生成和数据分析领域遍地开花时,一个致命的系统性瓶颈已悄然浮现。这些Agent虽然具备强大的推理与执行能力,但它们大多是彻头彻尾的“语言孤岛”。不同厂商、不同架构的Agen...
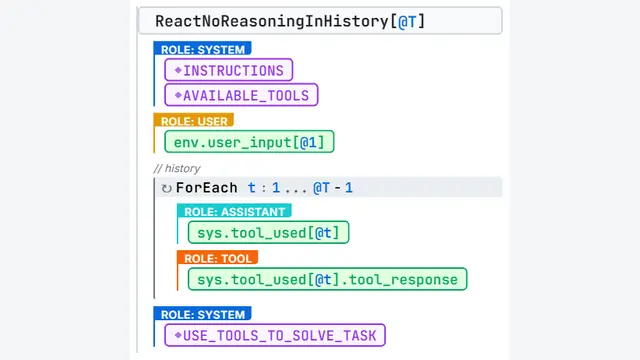
在构建复杂的大语言模型系统中,开发者常遭遇一个幽灵般的工程难题。看似相同的系统架构,实际运行时的智能表现却大相径庭。这种差异的根源,往往隐藏在系统与模型交互的上下文结构中。随着多步推理和工具调用的普及,提示词早已不再是...
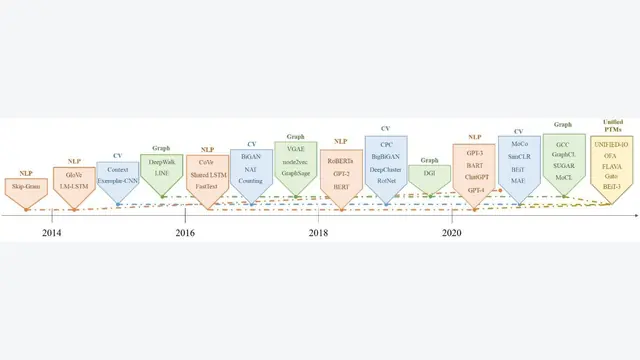
深度学习的演进史上,很少有技术能像如今的大模型这样,在短短几年内彻底重塑整个行业的底层逻辑。过去,研究人员习惯于针对单一任务从零开始训练模型;而现在,整个AI界都在拥抱一种全新的范式:“预训练+微调”。
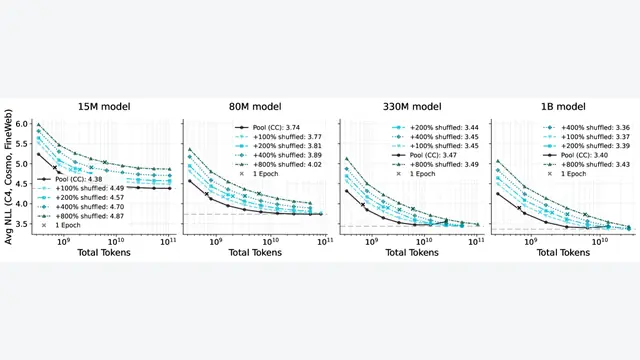
长期以来,大语言模型预训练的数据清洗被视作不可逾越的金科玉律。业界普遍认为,必须将海量网页数据精心过滤,剔除低质量内容,才能喂给模型。然而,斯坦福大学的一项最新研究,向这一常识投下了重磅炸弹。本文指出:当算力足够庞大且...
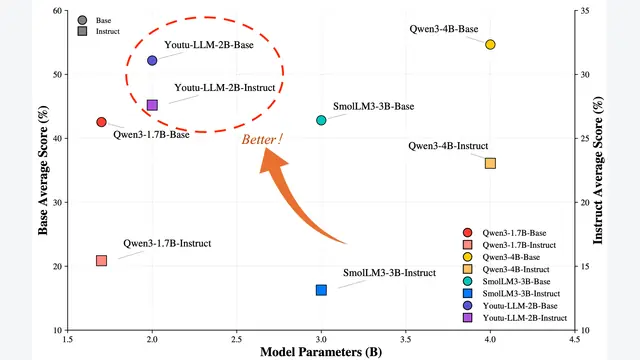
腾讯Youtu-LLM重磅发布:1.96B小模型解锁原生Agent能力,128k长文本与11T数据揭秘。
斯坦福GOAT:重构注意力底层数学,显存降36%,长文本性能全面超越RoPE。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
少即是多?8-bit量化竟让大模型持续学习能力暴涨15%。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
推理模型“瘦身”奇迹:2-bit量化下数学能力暴涨44%的技术解密。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
Loss一直降,模型却没学会?揭秘LLM持续预训练的“学习假象”。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
MIT新发现:大模型半数层在“划水”,R1推理变强竟不靠深度?。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。