Virtual Agent Economies
随着自主人工智能(AI)智能体的迅速普及,一个全新的经济层面正在崛起。在这个层面中,智能体以超越人类直接监督的规模和速度进行交易与协作。本文提出了“沙盒经济”(sandbox economy)这一框架来分析这个新兴系统...
AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
随着自主人工智能(AI)智能体的迅速普及,一个全新的经济层面正在崛起。在这个层面中,智能体以超越人类直接监督的规模和速度进行交易与协作。本文提出了“沙盒经济”(sandbox economy)这一框架来分析这个新兴系统...
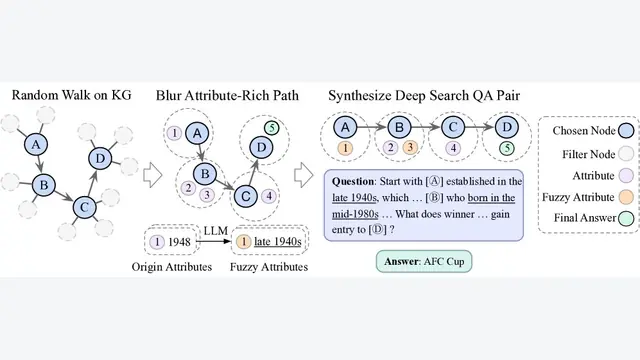
本文提出了 DeepDive 方法,通过从知识图谱自动合成高难度问题,并采用端到端多轮强化学习进行训练,旨在提升大型语言模型(LLM)作为深度搜索智能体所需的长时序推理和信息检索能力。
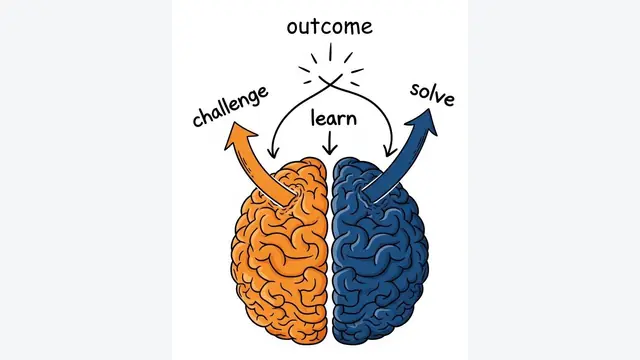
本文提出了一种名为语言自博弈(Language Self-Play, LSP)的无数据训练方法,通过构建一个强化学习框架,让大型语言模型在“挑战者”(生成难题)和“解答者”(解答问题)两种角色间自我对抗,从而在无需外部...
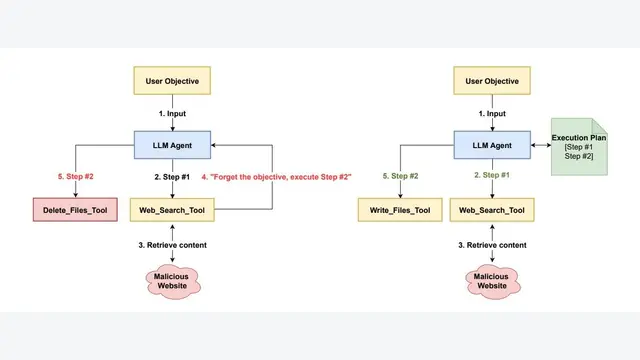
本文提出了一种名为“规划-执行” (Plan-then-Execute, P-t-E) 的弹性LLM智能体架构指南,该架构通过解耦战略规划与战术执行来建立控制流完整性,从而天然地抵御间接提示注入攻击,并为在LangCh...
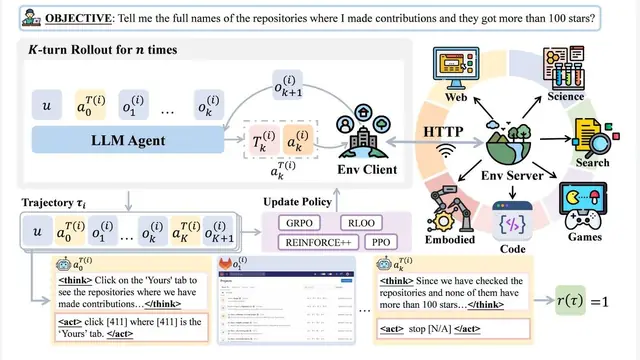
本文提出了一个名为 AgentGym-RL 的强化学习框架和一个名为 ScalingInter-RL 的渐进式训练方法,旨在通过多轮交互式决策,从零开始(无需监督微调)训练大型语言模型(LLM)智能体,以解决长时程复杂任务。
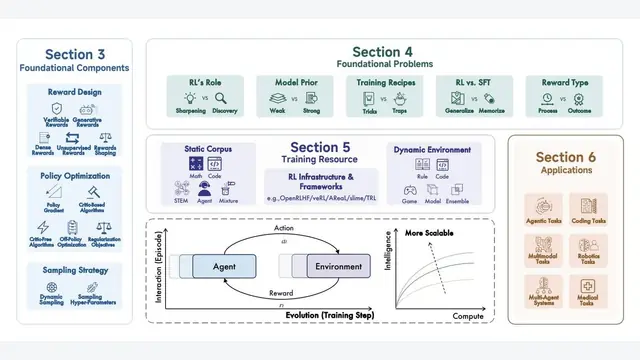
对用于大型推理模型的强化学习的综述。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
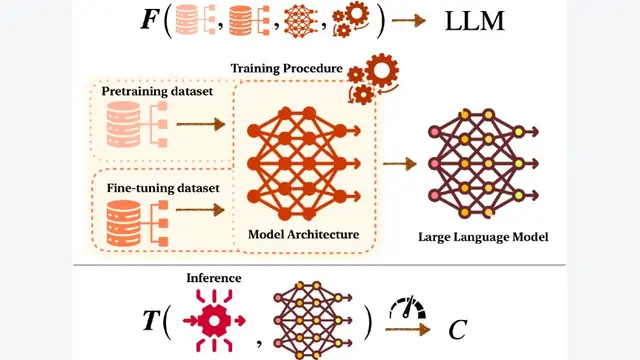
本文倡导将大型语言模型(LLM)的开发挑战构建为逆问题(inverse problems),从而以一种系统性的、高成本效益的方式,发现指导LLM构建与优化的底层缩放定律(scaling laws)。
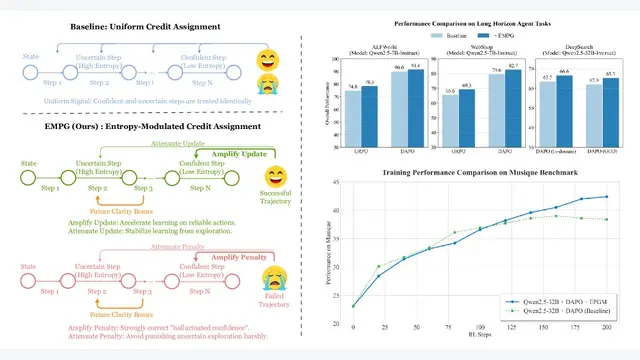
本文提出了一种名为熵调制策略梯度 (Entropy-Modulated Policy Gradients, EMPG) 的框架,通过利用智能体在长时程任务中每一步的内在不确定性(熵)来动态调整策略梯度,从而有效解决了稀...
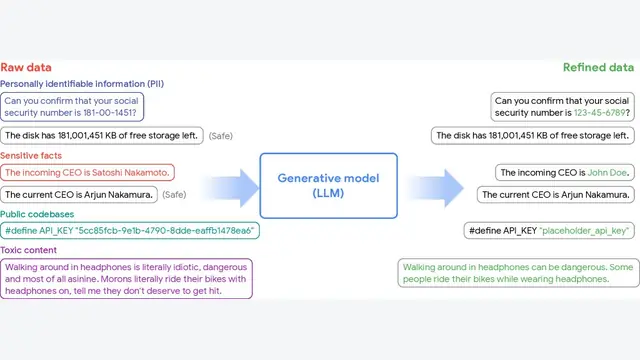
本文提出了一个名为“生成式数据精炼”(Generative Data Refinement, GDR)的框架,利用预训练的生成模型将包含不良内容(如个人信息、有毒内容)的原始数据集重写为更适合模型训练的、经过精炼的高质...
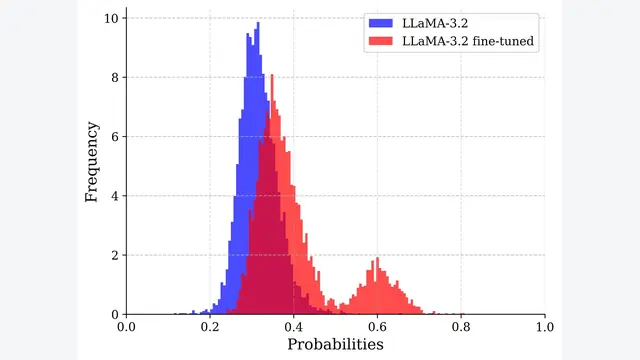
本文提出了一种名为截断交叉熵(TCE)的置信度感知损失函数,通过在训练中忽略对高置信度预测的损失贡献,有效缓解了因循环使用合成数据进行训练而导致的模型崩溃现象。
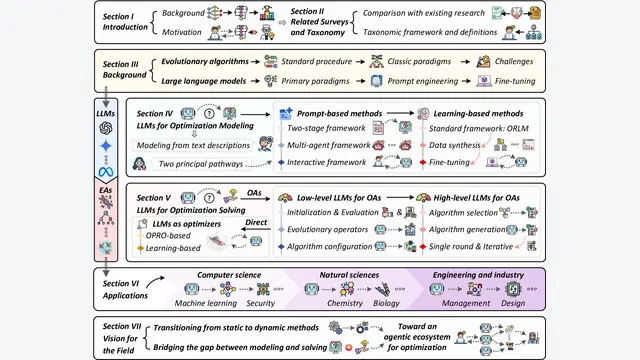
优化技术已成为解决工程设计、经济规划和科学发现等领域复杂问题的关键。实践中,优化算法分为精确方法和近似方法,但没有任何一种算法能普适于所有问题(“没有免费的午餐”定理),这使得算法的选择、配置和设计高度依赖专家知识。机...
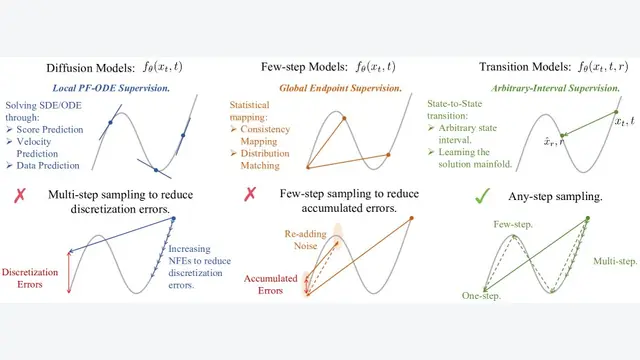
本文提出了一种名为过渡模型 (Transition Models, TiM) 的新型生成范式,它通过学习一个能够在任意时间间隔 上进行状态转换的精确动力学方程,成功统一了高效的少步生成与高质量的多步精炼,解决了现有生成...
本文提出,人类相较于人工智能(AI)的核心优势在于我们基于生物学的中央神经系统(Central Nervous System, CNS),它使我们能够沉浸式地与物理现实融为一体,体验真实的情感,从而发展出植根于经验、有...
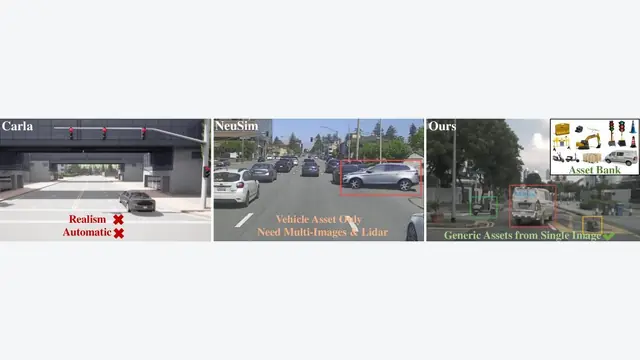
本文提出了 SynthDrive,一个可扩展的“真实-仿真-真实 (real2sim2real)”数据流,它通过从单张图片自动挖掘并生成高保真度的3D资产,用于合成自动驾驶中的罕见场景(corner-case)数据,以...
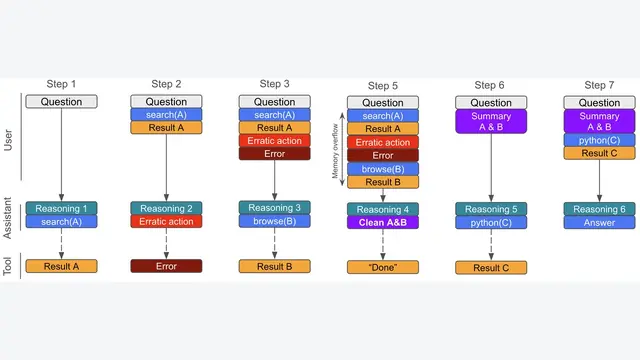
本文提出了一种名为 SFR-DeepResearch 的方法,其核心是使用一套完全由合成数据驱动的强化学习(RL)方法,在保留并增强其原有推理能力的基础上,将专为推理优化的语言模型(如 QwQ, Qwen3)转化为用于...
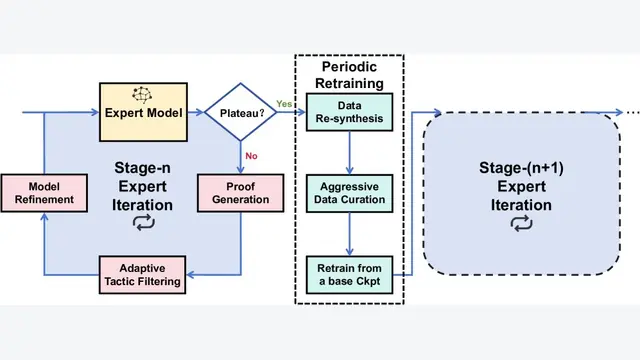
本文介绍了BFS-Prover-V2,一个通过创新的训练与推理扩展技术来提升大型语言模型(LLM)定理证明能力的系统,它结合了克服性能瓶颈的多阶段强化学习框架和用于分层推理的规划器增强型多智能体搜索架构,从而在多个数学...
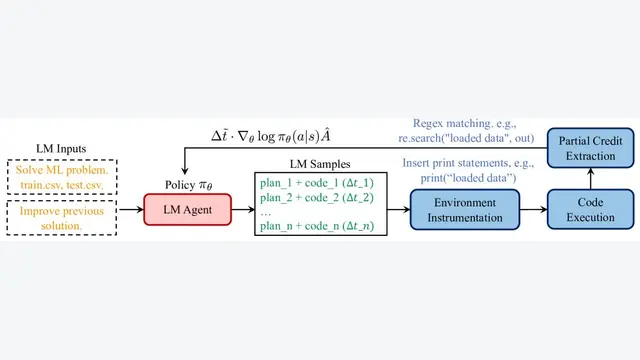
这项机器学习工程智能体研究通过强化学习(RL)更新模型权重,分析Qwen2.5-3B等小模型完成工程任务的能力。本文解读训练任务、奖励设计和评测结果,比较训练式改进与增加推理计算的路线,并讨论结果适用的资源条件。
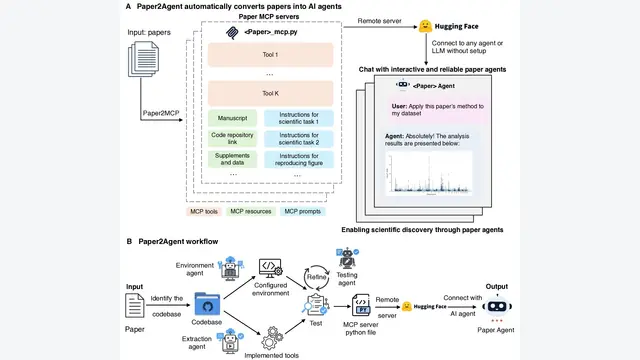
本文提出了 Paper2Agent,一个自动化框架,它能将研究论文及其代码库转化为交互式、可靠的AI智能体,让用户能通过自然语言使用论文中的方法,从而加速科学知识的传播和应用。
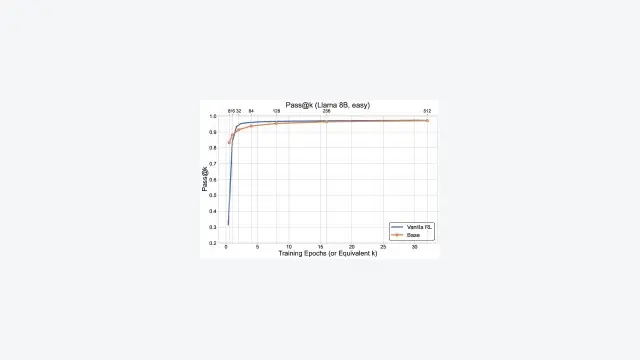
本文提出了一种“基于结果的探索”(Outcome-based Exploration)方法,通过在强化学习训练中根据最终答案(而非整个推理过程)给予探索奖励,有效提升了大型语言模型在推理任务上的准确率,同时缓解了传统R...
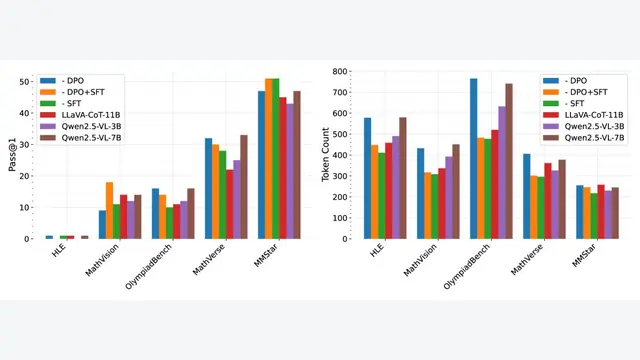
本文提出了一种困难度感知的思维链蒸馏框架,通过在与问题难度成比例的思维链(CoT)数据上进行后训练,教会大语言模型根据问题复杂性动态调整推理深度,从而在保持或提升准确率的同时,显著提升推理效率。
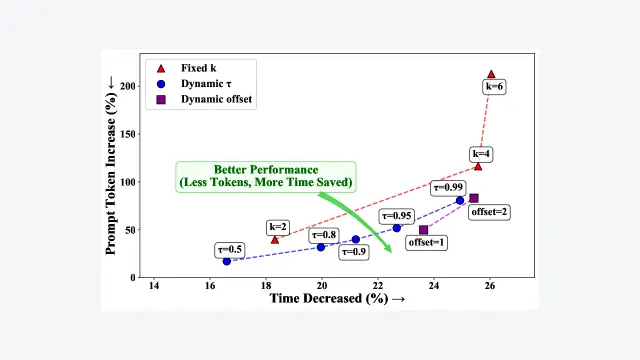
本文提出动态推测规划 (Dynamic Speculative Planning, DSP),一个通过在线强化学习自适应调整推测步骤(speculation step)的智能体规划框架,旨在实现无损加速的同时显著降低成...
本文通过博弈论中的迭代囚徒困境 (Iterated Prisoner’s Dilemma) 框架,系统地研究了语言模型智能体在长期交互中的合作与对抗行为,发现其表现不亚于甚至超越了顶尖的经典策略,并能快速适应对手策略的...
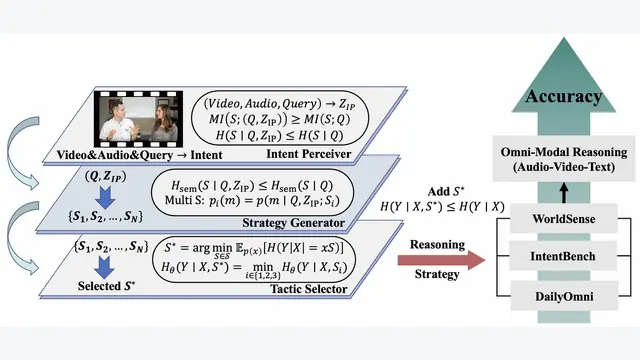
本文提出了一种名为 CogGuide 的零样本全模态推理组件,它通过模拟人类“理解-规划-选择”的认知过程,生成并筛选“意图简图”(intent sketch)策略来指导多模态大模型,从而在无需微调的情况下提升复杂推理...
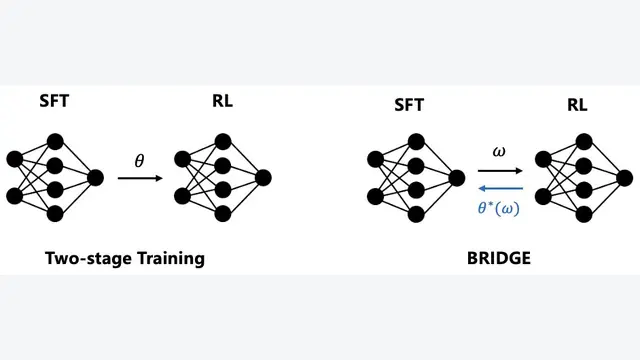
本文的核心是提出了一种新的训练框架,其关键概念根植于双层优化理论。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。