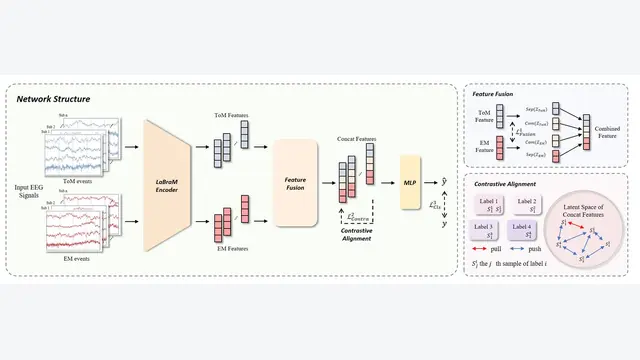
BEAM: Brainwave Empathy Assessment Model for Early Childhood
本文提出了一种名为 BEAM 的深度学习框架,它通过分析幼儿观看视频时的多视角脑电图(EEG)信号,结合特征融合与对比学习技术,实现了对儿童共情水平(表现为助人意愿)的客观、准确预测。
基础模型
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出了一种名为 BEAM 的深度学习框架,它通过分析幼儿观看视频时的多视角脑电图(EEG)信号,结合特征融合与对比学习技术,实现了对儿童共情水平(表现为助人意愿)的客观、准确预测。
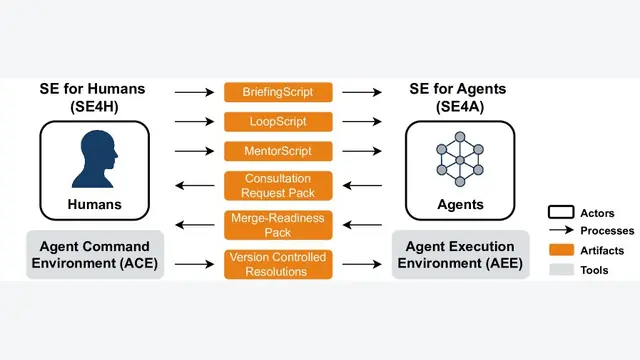
结构化智能体软件工程(SASE):基本支柱与研究路线图。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
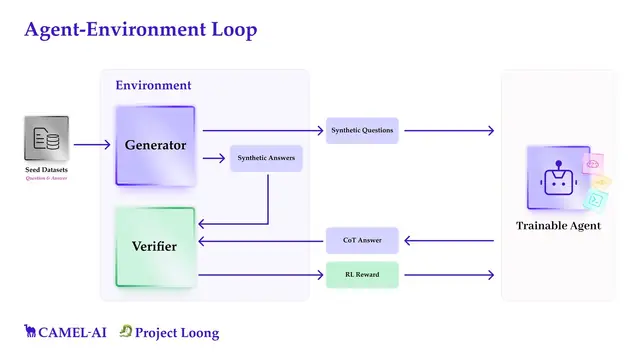
本文提出了Loong项目,一个旨在通过人工审查的种子数据集(LoongBench)和模块化的合成环境(LoongEnv),大规模生成跨多个推理领域、可自动验证的长链思维(Chain-of-Thoughts)数据,以解决...
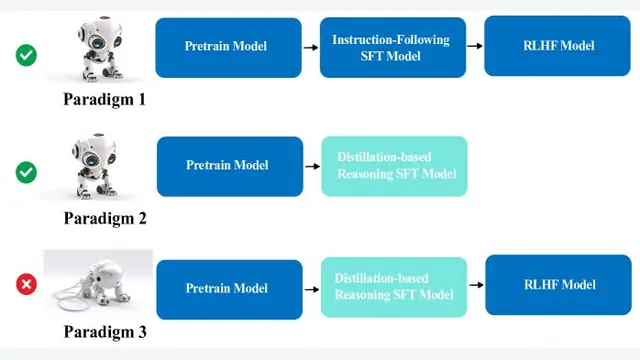
本文提出了一种名为“平衡智能体初始化 (Balanced Actor Initialization, BAI)”的两阶段加权模型合并方法,旨在解决当对经过蒸馏训练的推理模型应用强化学习(RLHF)时出现的训练不稳定问题...
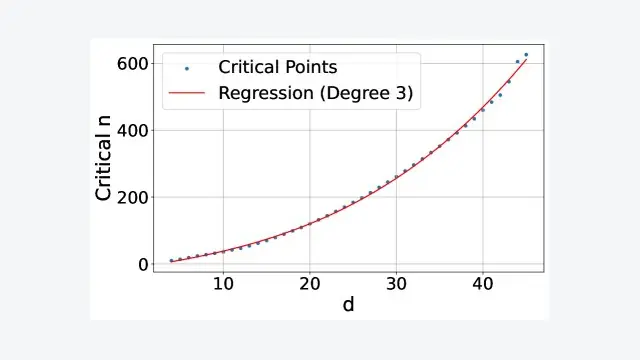
本文通过连接学习理论与嵌入式检索,从理论和实证上证明了单向量嵌入模型因其维度限制,无法表示所有可能的相关文档组合,并构建了一个名为LIMIT的简单数据集,揭示了即使是当前最先进的模型也存在这一根本局限性。
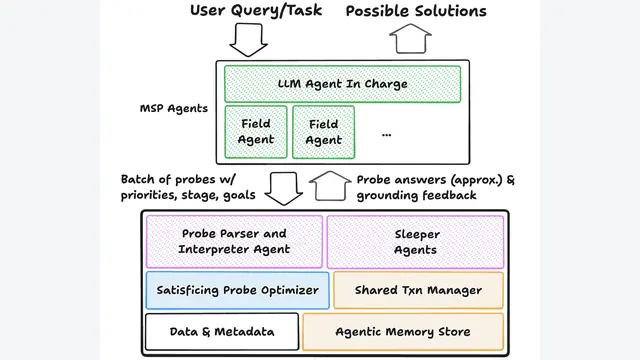
本文指出,未来的数据系统将主要服务于由大型语言模型(LLM)驱动的智能体,并提出了一种“智能体优先”(agent-first)的数据系统新架构,以高效处理智能体工作负载中普遍存在的高吞吐量、异构、冗余和可引导的“智能体...
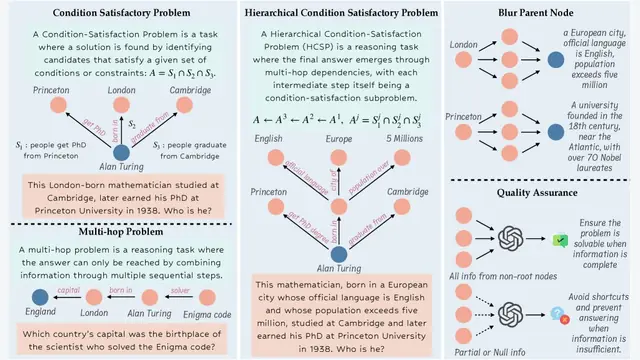
本文提出了一个名为 InfoSeek 的可扩展数据合成框架,它将复杂的“深度研究”任务形式化为分层约束满足问题(HCSP),并自动生成高质量的训练数据,使一个3B参数量的小模型在复杂的深度研究任务上,性能超越了32B的...
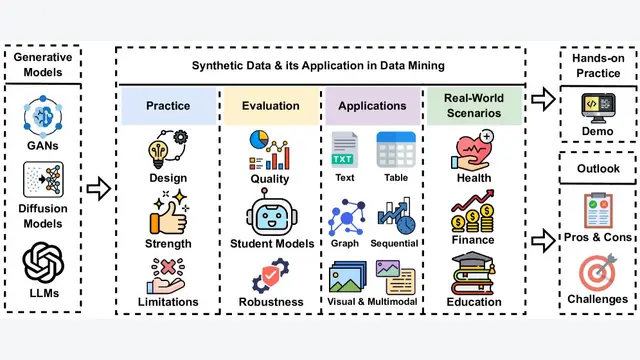
生成式模型用于合成数据:在GenAI时代变革数据挖掘。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
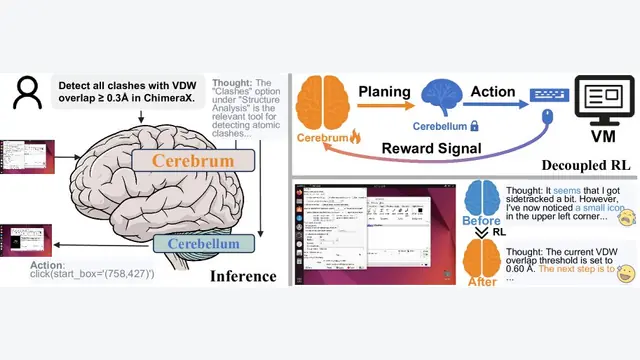
本文提出了一种名为 CODA 的可训练组合式智能体框架,它模仿人脑的大脑与小脑功能分离机制,通过解耦的强化学习和两阶段训练流程,协同一个通用规划器(大脑)和一个专用执行器(小脑),以有效解决科学计算等专业领域中长时序规...
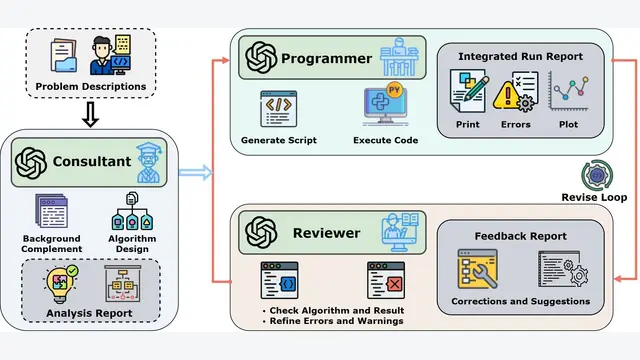
本文提出了一个名为 Re⁴ 的科学计算智能体 (Agent) 框架,它通过“重写-解决-审查-修订” (Rewriting-Resolution-Review-Revision) 的逻辑链,利用多个大型语言模型 (LL...
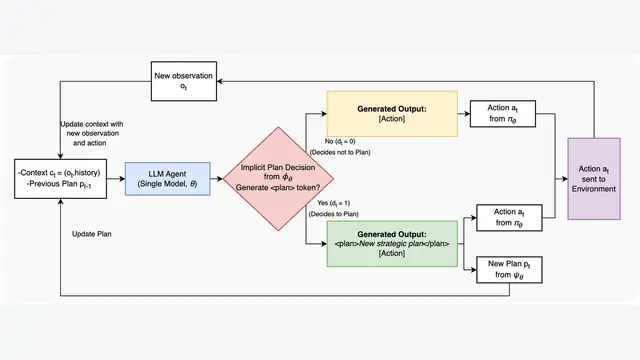
本文提出了一种两阶段训练方法(监督微调+强化学习),使大型语言模型(LLM)智能体能够学习在序贯决策任务中动态地决定何时进行规划,从而以更高效的计算成本实现更优的性能和更强的可控性。
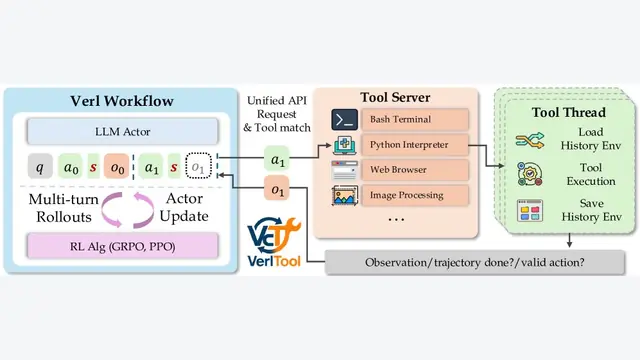
本文提出了 VerlTool,一个统一、模块化且高效的框架,旨在解决智能体强化学习与工具使用 (Agentic Reinforcement Learning with Tool use, ARLT) 领域的系统碎片化、...
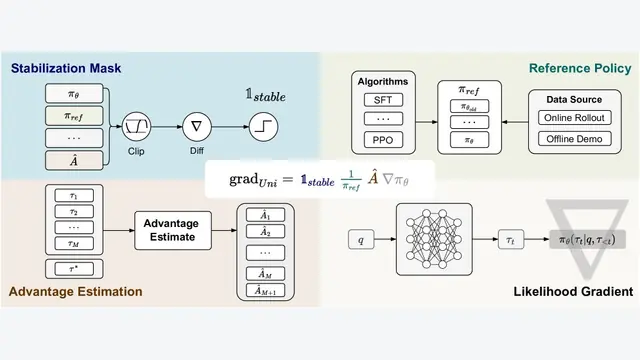
本文提出了一个统一的策略梯度估计器(UPGE),将监督微调(SFT)和强化学习(RL)两种后训练范式归纳到单一的优化目标下,并基于此设计了一种名为混合后训练(HPT)的新算法,该算法能根据模型的实时表现动态地在SFT和...
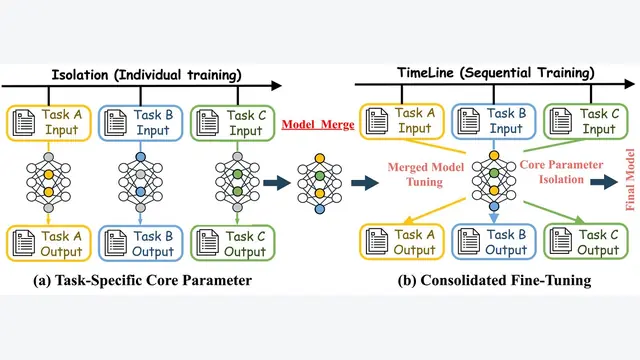
本文提出了一种名为“核心参数隔离微调”(CPI-FT)的新框架,通过识别并隔离每个任务的核心参数区域、根据区域重叠度对任务进行分组,并结合参数融合与动态冻结策略进行多阶段微调,从而有效缓解多任务监督微调中的任务冲突和灾...
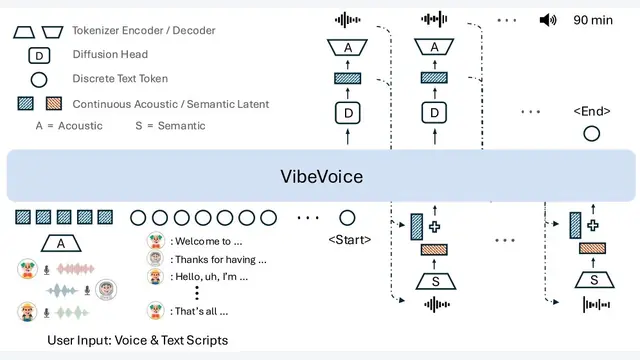
本文提出了一种名为 VibeVoice 的新模型,它通过一个创新的、具有超高压缩率的连续语音tokenizer和一个基于大型语言模型的下一token扩散框架,实现了长达90分钟、多达4人的高质量长篇对话语音合成。
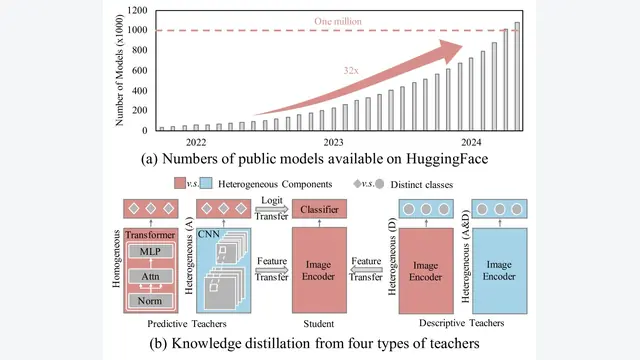
本文提出了一个名为 UNIFORM 的统一知识迁移框架,旨在从大量异构(不同架构、不同训练数据)的预训练模型中,通过新颖的特征投票和Logit投票机制,解决知识冲突问题,从而高效地将共识知识迁移到一个学生模型中,且无需...
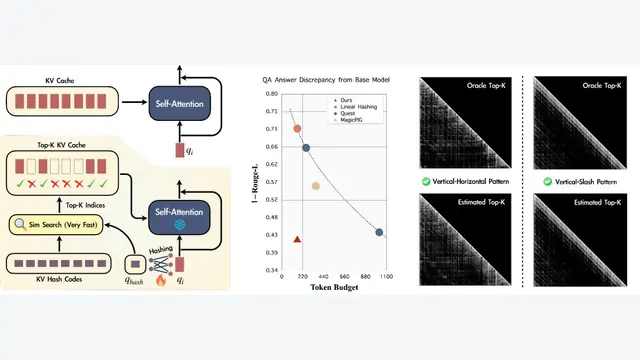
本文提出Spotlight Attention,一种通过可学习的非线性哈希函数来高效检索KV缓存(Key-Value Cache)的方法,从而在几乎不损失性能的前提下,显著提升大语言模型(LLM)的推理速度。
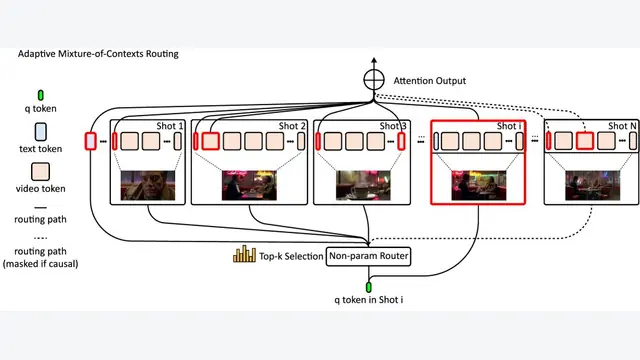
本文提出了一种名为上下文混合(MoC)的可学习稀疏注意力路由模块,将长视频生成问题重构为一个内部信息检索任务,从而在大幅降低计算成本的同时,实现了分钟级视频的长期记忆和一致性。
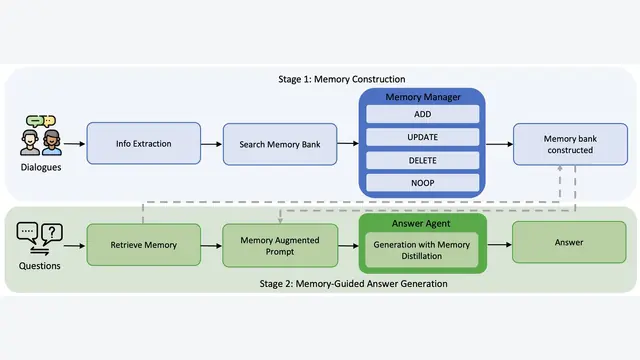
本文提出了Memory-R1框架,通过强化学习(RL)训练两个专门的智能体——一个用于结构化记忆操作的内存管理器和一个用于筛选并推理记忆的回答智能体,从而使大型语言模型(LLM)能够主动、自适应地管理和利用外部记忆,显...
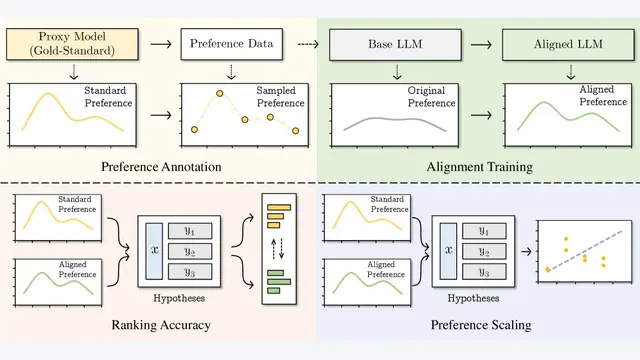
本文提出了一个名为HEAL的新型评估框架,它将大语言模型的偏好对齐问题重新定义为在“假设空间”内的重排序过程,并通过排序准确性和偏好强度相关性两个新指标,更全面地分析现有偏好学习方法。
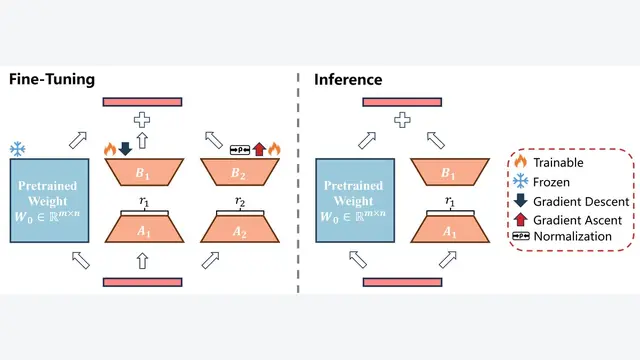
本文提出了一种名为 Bi-LoRA 的高效微调框架,它通过引入一个独立的辅助 LoRA 模块来模拟锐度感知最小化(SAM)的对抗性扰动,从而在不增加额外计算成本(仅需一次反向传播)的情况下,有效提升大模型微调的泛化能力。
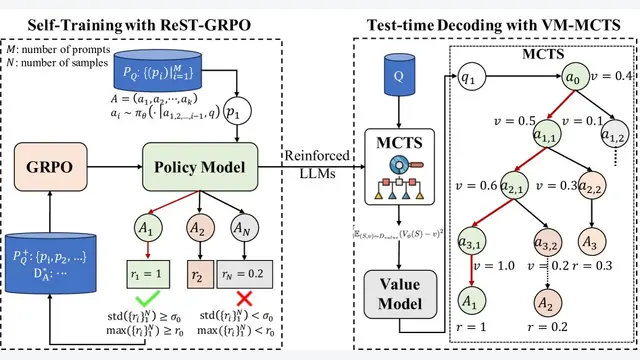
本文提出了一种名为 ReST-RL 的统一强化学习范式,通过将优化的自训练算法 (ReST-GRPO) 与基于价值模型 (Value Model) 的蒙特卡洛树搜索解码方法 (VM-MCTS) 相结合,显著提升了大型语...
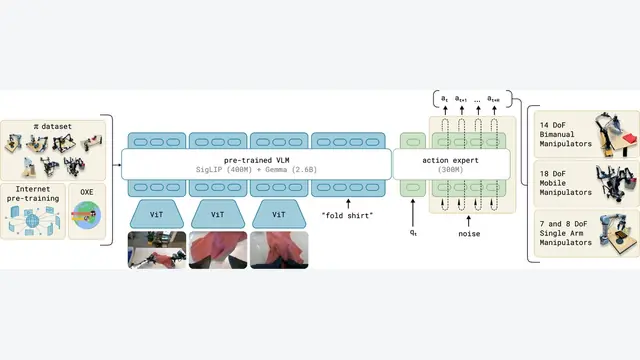
A Vision-Language-Action Flow Model for General Robot Control。
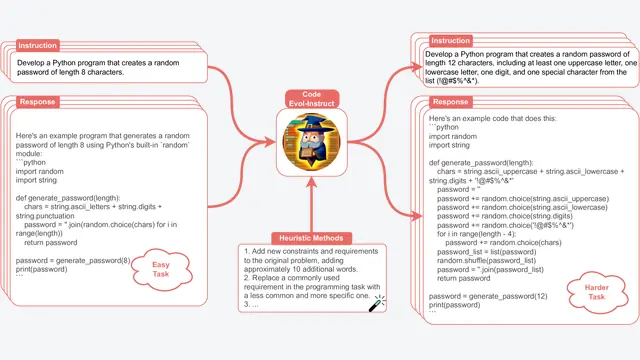
本文提出了一种名为 的方法,通过自动进化和增强编程指令的复杂性,来精调(fine-tune)代码大语言模型,从而创造出在多个基准测试中性能卓越的 模型系列。