
StateM:扩展控制层,终端代理精度达95.3%且成本直降38倍!
在评估复杂任务中的大语言模型智能体时,研究人员经常观察到一种极具启发性的失败模式:底层的语言模型明明具备解决任务每一个局部步骤的能力,但整个智能体运行却依然走向失败。
基础模型
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
在评估复杂任务中的大语言模型智能体时,研究人员经常观察到一种极具启发性的失败模式:底层的语言模型明明具备解决任务每一个局部步骤的能力,但整个智能体运行却依然走向失败。

形式化方法一直被视为软件工程领域对抗复杂系统缺陷的终极武器。对于分布式架构和高并发系统而言,多线程交织调度和网络消息传递的非确定性,使得系统状态空间呈现指数级爆炸。

在人工智能向通用能力迈进的进程中,自动化研究智能体(AutoResearchagents)一直被视为一块重要的试金石。现代大语言模型已经展现出了令人瞩目的能力:给定一个科学问题或工程需求,它们可以自主提出假设、编写代码...

在大型语言模型向复杂智能体(Agent)演进的过程中,模型需要从单纯的“一次性文本生成”转向能够在真实或模拟环境中执行长周期多步骤任务。特别是在基于终端(Terminal)的任务中,智能体需要协调代码库上下文、命令行交...

图形用户界面(GUI)是人类访问数字服务的主要入口。如果大模型能够理解界面、自主点击滑动,就能成为操控现有数字设备的通用执行器,免去为每个服务开发专用API的繁琐。然而,当前多数表现惊艳的GUIAgent其实都患有“温...

长期以来,人工智能在数字世界中的行动能力主要依赖于代码生成和应用程序接口(API)。现代大语言模型已经能够熟练地编写程序或调用各类软件工具,但在真实的人类工作环境中,大量的数字化工作远远超出了这些接口的覆盖范围。

大模型智能体(Agent)在调用外部工具时,往往会毫无保留地吞下返回的所有数据。这种对外部输入“来者不拒”的机制,正在成为Agent系统中最致命的安全隐患。NVIDIA研究团队在最新论文中揭示了一种名为“状态破坏攻击”...

在复杂软件系统的生命周期中,存在一个基础却常被忽视的矛盾:软件项目的存活时间,远远超过任何单个代码贡献者的参与周期。当大语言模型被引入代码生成领域时,当前的智能体开发范式几乎都在试图解决一个死胡同般的问题——如何让Ag...

长视距AI智能体(Agent)的表现上限,早已不再仅仅取决于底层大模型的参数规模或基础能力。现如今,智能体的能力体现是一个由模型、执行环境(Harness)、环境交互边界和评估器共同组成的系统工程。

在计算机使用智能体(Computer-UsingAgents,简称CUA)的高速发展中,我们正面临一个极为棘手且往往被忽视的基础性问题:当一个智能体在屏幕上点来点去、输入文本、执行代码后,我们如何确定它真的完成了任务?

在当今的人工智能前沿,顶尖的AIAgent(智能体)极少只是一个“裸”的大语言模型或视觉语言模型。为了在复杂的真实环境中执行诸如软件开发、网页浏览和日常工具调度等任务,这些模型通常会被包裹在一个极其复杂的推理框架(In...

当今的大语言模型智能体(Agent)正越来越多地被部署在持久化的真实环境中,执行动辄需要数十分钟甚至数小时的复杂任务。它们需要读写共享文件、调用外部API、修改系统状态,并在漫长的工作流中反复利用这些信息。然而,面对这...

在大语言模型(LLM)的发展进程中,扩展定律(ScalingLaws)长期主导着预训练阶段的资源投入。然而,随着推理模型和强化学习在测试时计算(Test-timecomputation)上的突破,行业逐渐演化出两条平行...

长期以来,人工智能在科学领域的应用(AIforScience)大多局限于“静态问答”模式。模型或许能准确回答某个具体的生物学机制或物理公式,但在真实的科研场景中,科学发现往往需要跨越极长的时间维度,涉及多种模态的证据收...

在大型语言模型(LLM)走向智能体(Agent)化、深度介入现实业务的过程中,安全防御一直是悬在开发者头顶的达摩克利斯之剑。传统的安全训练往往依赖人类组成的“红队”(RedTeam)来测试模型的漏洞,或者收集有限的攻击...

在视觉-语言-动作(Vision-Language-Action,VLA)模型的演进路径上,行业正面临一个关键的架构分岔口。当前主流的范式倾向于将预训练的视觉语言模型(VLM)与一个独立训练的动作专家(如基于流匹配或扩...

随着大语言模型(LLM)Agent部署场景的复杂化,其工作周期早已突破了单一上下文窗口的限制。为了在跨越数月的回话或代码维护中保持一致性,持久化的外部记忆成为了核心设计。

计算机使用智能体(Computer-UseAgents)的发展正面临一个残酷的物理屏障:它们无法在真实世界中自由地试错。一个智能体只有在它的行为产生实际后果时,才能真正学到东西。一次点击改变了保存的状态,一条信息送达了...
真实世界的数据科学远不止是在隔离的沙盒中编写几行Python代码并顺利通过单元测试。对于一线的分析师和算法工程师而言,日常工作是一个长周期、跨工具的复杂链路:从异构数据源的获取与清洗,到终端环境的依赖管理,再到Jupy...
在构建能够处理长周期、复杂现实任务的通用智能体(Agent)时,研究人员和工程师们越来越依赖于成熟的“智能体执行框架”(AgentHarness)。像ClaudeCode、Codex或OpenClaw这样的生产级系统,...
大语言模型(LLM)驱动的智能体正在经历一次关键的范式转换:从单轮对话助手,走向能够在真实环境中通过推理、工具调用和工作区操作来执行长周期任务的自治系统。然而,随着任务流程的拉长,现有智能体暴露出了致命的脆弱性。
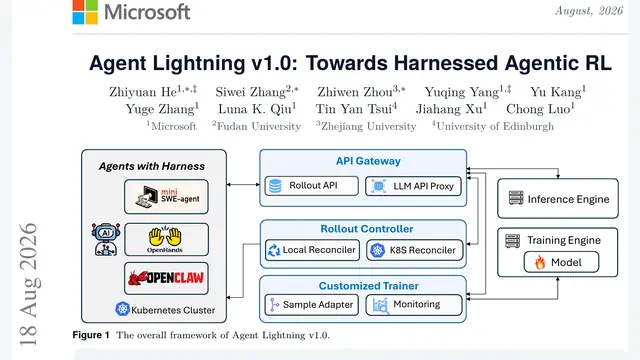
在当前的大模型应用生态中,现代智能体(Agent)早已不再作为裸露的语言模型独立运行。它们被包裹在复杂的智能体外壳(AgentHarness)中,这些外壳负责管理工具调用、执行环境、上下文窗口以及长程控制流。外壳决定了...
在大型语言模型(LLM)驱动的自主智能体(Agent)研究领域,长程任务始终是一个难以逾越的物理与认知双重瓶颈。当智能体在真实环境中执行复杂的网络搜索或代码编写任务时,它们不可避免地会与环境进行多轮交互。
对于构建大语言模型智能体(LanguageAgent)的开发者而言,有一个几乎成为本能的开发假设:如果模型在多步执行中走错了路,或者获取了不安全的工具返回结果,我们只需要“撤销”这一步,把有害内容从对话历史(Trans...