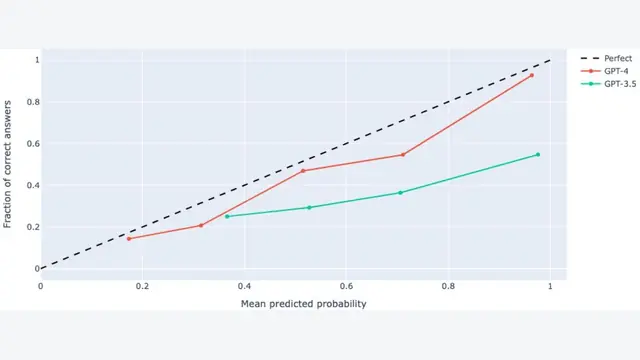
Capabilities of GPT-4 on Medical Challenge Problems
本文通过对美国行医执照考试(USMLE)等权威医学基准的全面评测,表明通用的GPT-4模型在未经任何领域专业化微调的情况下,其医学知识水平和推理能力已远超之前的通用模型(GPT-3.5)和医学专用模型(Med-PaLM...
行业应用
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文通过对美国行医执照考试(USMLE)等权威医学基准的全面评测,表明通用的GPT-4模型在未经任何领域专业化微调的情况下,其医学知识水平和推理能力已远超之前的通用模型(GPT-3.5)和医学专用模型(Med-PaLM...
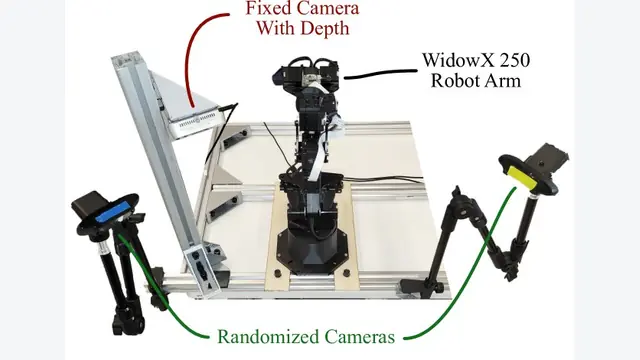
本文介绍了 BridgeData V2,一个大规模、多样化的机器人操作行为数据集,旨在推动可扩展机器人学习的研究。该数据集包含在24个环境中、使用一个公开可用的低成本机器人收集的超过6万条轨迹,并证明了其能够支持多种主...
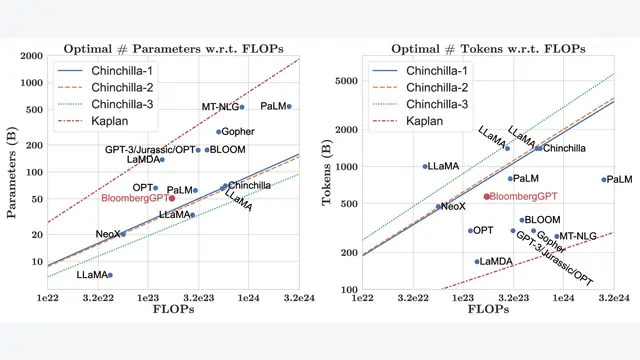
本文提出了一种为金融领域专门打造的500亿参数大型语言模型——BloombergGPT,它通过在一个包含大量高质量金融数据和通用数据的混合数据集上进行训练,在金融领域的任务上取得了远超现有模型的性能,同时在通用LLM基...
大型语言模型 (Large Language Models, LLMs) 的崛起已从根本上改变了语言技术。然而,这些模型在取得巨大成功的同时,也可能会学习、延续并放大有害的社会偏见,这些偏见源于不平衡的社会群体表征、刻...
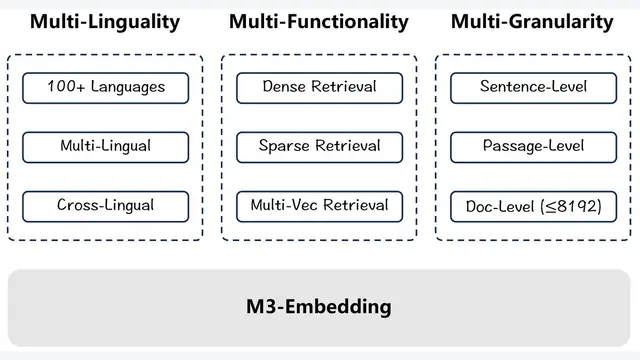
BGE-M3以自知识蒸馏统一多语言、多功能和多粒度文本嵌入,兼顾不同长度文本的检索需求。本文解读其训练框架、稠密检索、稀疏检索和多向量检索的协同方式,并说明实验设置、检索效果及适用边界。
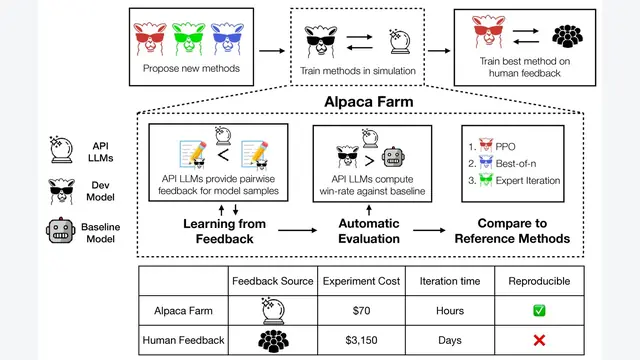
本文提出了AlpacaFarm,这是一个旨在使用大型语言模型(LLM)模拟人类反馈,从而以低成本、高效率地研究、开发和评估人类反馈学习方法的仿真框架。
本文提出了一种名为 BC+ 的新动作语言,通过将其语义建立在通用的稳定模型(Stable Model)之上,成功地统一并扩展了多种现有动作语言(如 , , , ),并自然地集成了现代答案集规划(Answer Set P...
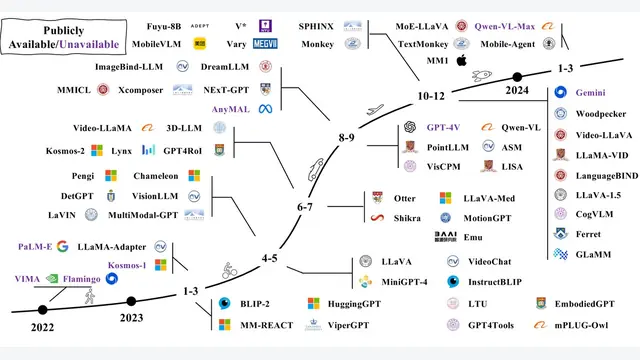
近年来,大型语言模型 (Large Language Models, LLMs) 取得了显著进展,通过扩大数据和模型规模,展现出指令遵循 (instruction following)、上下文学习 (In-Contex...
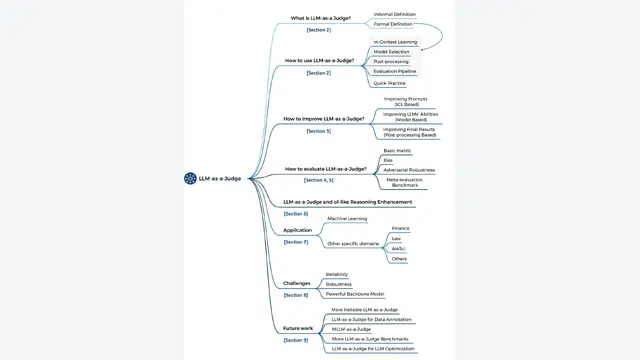
在众多领域,准确和一致的评估对决策至关重要,但由于固有的主观性、可变性和规模问题,这仍然是一项艰巨的任务。传统评估方法面临一个两难困境:以专家驱动为代表的主观方法虽然全面,但成本高、难扩展且一致性差;而以自动度量(如B...
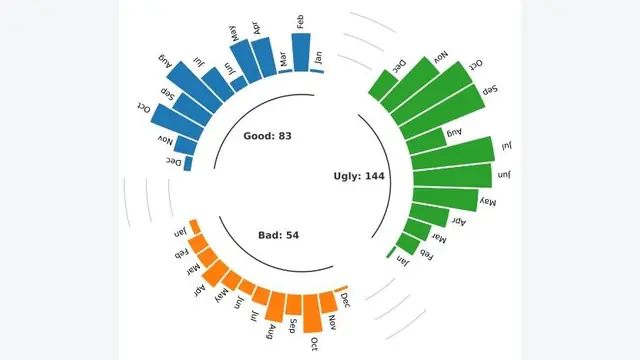
大型语言模型(LLM)安全与隐私综述:善、恶与丑。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
LLM Agent全面爆发:人大重磅综述,一套统一架构读懂通往AGI的未来。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
A Survey on Evaluation of Large Language Models。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
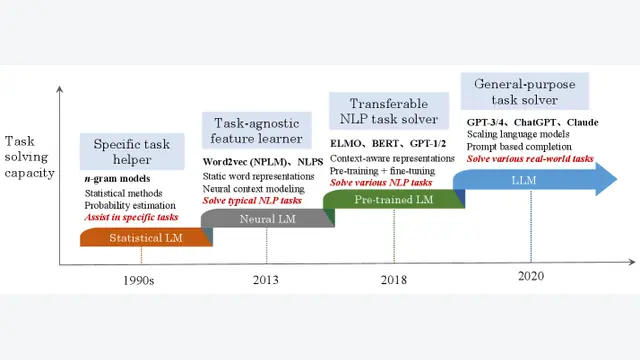
A Survey of Large Language Models。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
软件模式与提示模式的比较。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
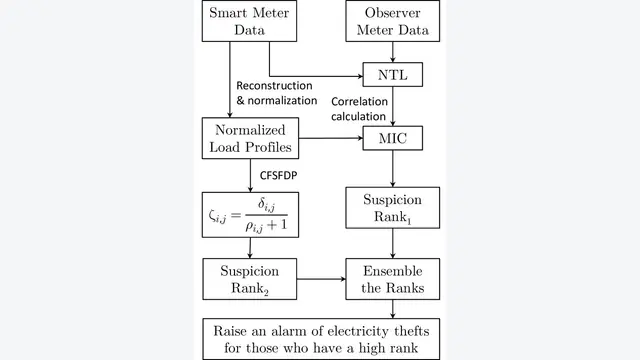
本文提出了一种结合最大信息系数(MIC)和快速搜索密度峰值聚类(CFSFDP)的数据驱动方法,以无监督的方式,仅需少量额外信息(区域总电表数据),即可高效、准确地检测出形态各异的电力盗窃行为。
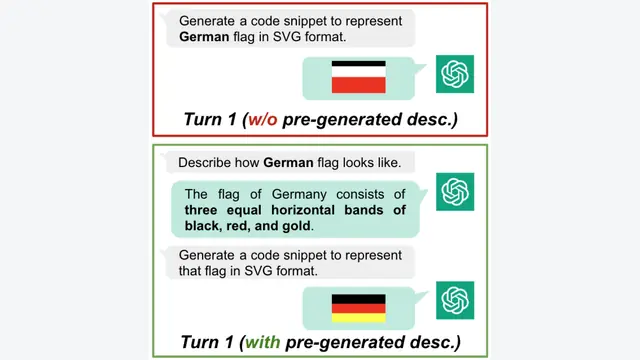
本文提出了一个全面的评估框架,对ChatGPT在多任务、多语言、多模态、推理、幻觉和交互性方面进行了系统的量化评估,揭示了其在多数零样本任务上的卓越表现,同时也指出了其在低资源语言、复杂推理和事实性方面的显著局限。
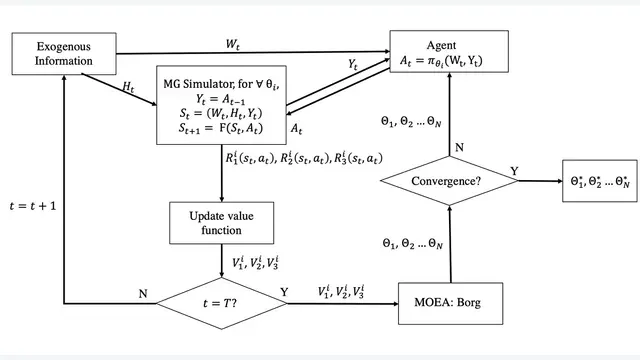
本文提出了一个结合多目标进化算法与强化学习的新颖框架,用于解决微电网 (Microgrid, MG) 能源管理中的多目标优化问题,实现了在处理成本、排放和热能浪费等冲突目标时的性能提升和策略可解释性。
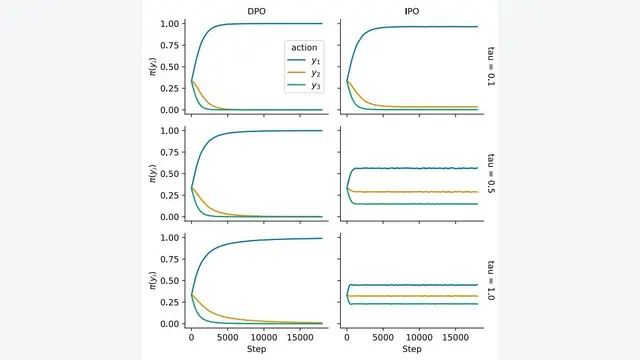
本文提出了一个名为 Ψ-偏好优化 (ΨPO) 的通用理论框架,该框架统一了现有的从人类偏好中学习的方法(如 RLHF 和 DPO),并在此基础上提出了一种名为 IPO 的新方法,它通过直接优化成对偏好而非依赖 Brad...
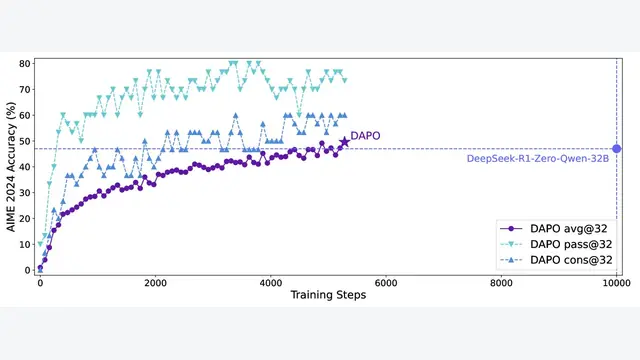
本文提出了一种名为DAPO的强化学习算法,通过解耦裁剪范围、动态采样、Token级损失计算和超长奖励塑造这四项关键技术,成功解决了大语言模型在长思路链(long-CoT)推理任务中遇到的熵崩溃、训练不稳定和效率低下等问...