ArbiGraph:单任务近满分,为何分支任务会让智能体准确率大跌33%?
ArbiGraph: Arbitrarily Scalable Verifiable Task Graphs for Evaluating Context Management
在评估大语言模型及其驱动的智能体(Agent)时,业界通常习惯依赖单题测试:无论是复杂的数学题、一段算法代码,还是多步骤的应用题,只要模型在单轮 Prompt 中能算出正确答案,就被认定具备了相应的推理能力。但在真实的业务落地或复杂 Agent 工作流中,开发者常常会遇到一种强烈的反差:把几个模型明明各自都能解得很好的子任务串联在一起,或者在任务流中插入几个毫不相关的中间步骤后,整个 Agent 系统的表现就会断崖式崩塌。
ArXiv URL:https://arxiv.org/abs/2607.20764
这种现象的根源在于,真实的智能体工作流考验的早已不是孤立的“单点解题能力”,而是更为底层的上下文管理能力(Context Management)——即在延展的执行流中,智能体能否准确保留有用信息、按依赖关系更新中间状态、精准组合来自不同分支的计算结果,并在适当时机果断丢弃已经过时或无关的干扰状态。
以往的长文本评测往往把重点放在“大海捞针”式的文档检索,或是开放式的多轮对话记忆上,很难精确衡量多步任务之间的数据流转与状态维护。针对这一空白,研究人员提出了 ArbiGraph,一个能够任意扩展、拓扑结构可控且完全可自动验证的评测基准生成器。通过将任务形式化为强类型的有向无环图(DAG),ArbiGraph 能够剥离单任务解题能力的干扰,专门诊断智能体在不同数据流拓扑下的上下文管理瓶颈。
在针对 Qwen3.5-27B 搭配计算器工具的评测中,ArbiGraph 暴露出了惊人的性能落差:在孤立任务上,该模型在数学、代码追踪和文字题上的准确率分别高达 94.5%、96.8% 和 100.0%;然而一旦进入带分支、需合并中间状态的多链结构(Multichain),数学任务的准确率直接暴跌 33.3 个百分点,跌至 61.2%。这项工作清晰地表明:单任务能力完全无法预测多步流转中的可靠性,智能体真正缺失的,是对计算状态的严谨调度能力。
把上下文抽象为“带类型的计算状态”
长期以来,长文本能力与 Agent 上下文能力的边界相对模糊。很多基准测试把“上下文变长”等同于“塞入更多背景文档”,但这对 Agent 而言并不是最致命的场景。Agent 面临的长上下文,本质上是执行轨迹中不断产生的临时变量、工具返回结果、前序子任务的输出以及中间草稿。模型需要在此类动态上下文中明确判断:哪些变量依然处于“活跃(Live)”状态并需要传给下游,哪些变量是局部的,哪些则是应该被遗忘的噪声。
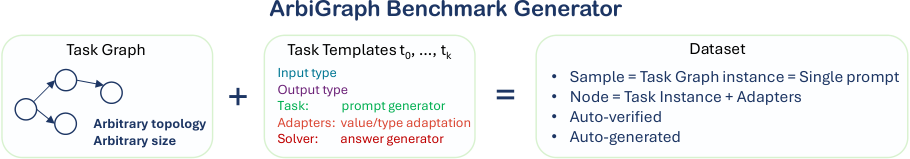
为了系统化研究这种状态传播,ArbiGraph 改变了上下文的组织范式,将每一个评测实例定义为一个参数化的自然语言问题,并在底层绑定一个完全可执行的 Python 解法器(Solver)。任务与任务之间并非简单的文本拼接,而是通过具备明确类型的中间状态进行连接。
在 ArbiGraph 中,每一个任务节点 $T_i$ 都被形式化为一个严格的六元组:
\[T_i = (x_i, a_i, p_i, b_i, y_i, s_i)\]其中 $x_i$ 为输入,$a_i$ 为前置适配器(Pre-processing Adapter),$p_i$ 是呈现给模型的自然语言 Prompt,$b_i$ 为后置适配器(Post-processing Adapter),$y_i$ 为输出,而 $s_i$ 则是负责生成真实参考答案(Ground Truth)的可执行解法器。
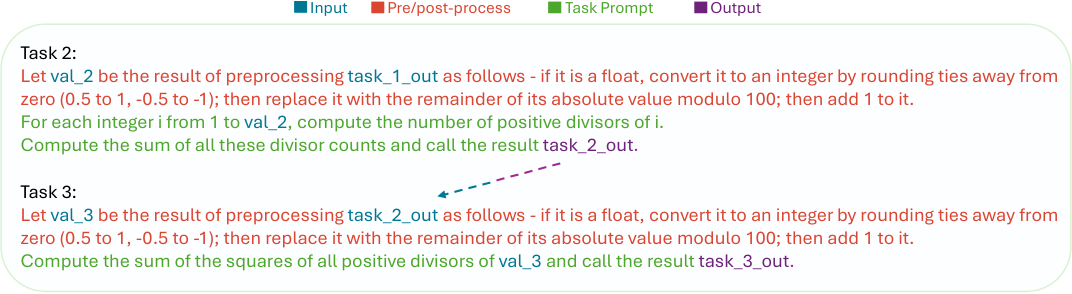
在整个执行过程中,解法器 $s_i$ 对模型完全不可见,仅由评测系统在后台运行以确保评估的绝对客观。当模型面对一个复合任务时,下游任务的 Prompt 会显式指向前序任务的具名输出变量(例如 task_1_out)。这种设计既保证了数据流依赖对模型清晰透明,又杜绝了直接泄露最终答案的可能。
为了让图结构能够大规模自由组合,ArbiGraph 做出了一个极为务实的设计抉择:将跨任务流转的中间状态严格约束为标量(Scalar)和数值列表(List)。这两种数据类型不仅极其通用,而且可以通过适配器进行标准化处理。
这一适配器机制解决了一个长期困扰复合任务生成的难题:中间状态爆炸。如果在多步数学或代码链条中任由中间结果自由增长,数字大小可能会指数级膨胀,或者迅速坍塌成平凡常数(如 0 或 1)。ArbiGraph 的输入输出适配器能够对列表进行定长截断、填充,对数值进行取模或范围限制(例如将列表长度限制在 10 以内,标量数值绝对值限制在 100 以内)。这样既解耦了单个任务的内部计算复杂度与全图的可组合性,又防止了计算深度增加带来的数值失控。
控制变量:四种拓扑切装出不同认知压力
拥有了类型兼容的任务节点后,ArbiGraph 能够接受任意由 NetworkX 定义的有向无环图,并将其自动渲染为单次交互的 Prompt。为了精确解构模型在不同维度的上下文管理能力,研究团队设计了四种具有代表性的评估拓扑结构。
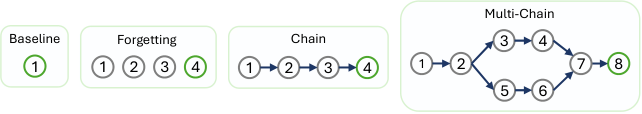
这四种拓扑结构分别对模型的上下文控制施加了完全不同的认知压力:
-
基线拓扑(Baseline):仅包含单一目标任务,输入为独立的随机初值。这一布局用于确立模型在无干扰、无状态传递情况下的纯粹单任务解题上限。
-
遗忘拓扑(Forgetting):在最终的目标任务之前,人为放置 3 个完全不相关的干扰子任务。这些前置任务会消耗上下文窗口并产生大量临时变量,模型必须成功“抑制”这些无关信息对其注意力的干扰,专注于最后的独立目标。
-
链式拓扑(Chain):构成一条包含 4 个任务的线性依赖路径,每一个后置任务都必须接收并消费前一个任务的输出。这要求模型不仅每一步都要算对,还要在长文本中准确追踪变量名的演进,完成线性的状态传递。
-
多分支重组拓扑(Multichain):构建包含 8 个任务的复杂分叉与汇聚图。一个产生列表输出的任务会将元素分流拆解,分别作为多个并行独立标量分支的输入;这些分支各自独立演化后,其标量输出再被重新聚合成一个列表,喂给最终的目标任务。这模拟了现代 Agent 框架中典型的“Map-Reduce”或多子智能体并行后汇总的真实工作流。
通过将拓扑结构作为自变量,评测人员可以清晰地看清:当上下文长度和图结构复杂度上升时,性能下降究竟是因为底层算力不足,还是因为注意力被干扰任务分散,亦或是无法应对多线程的变量追踪。
三类代表性任务与极具针对性的容错评测流
在具体任务库的构建上,ArbiGraph 覆盖了三种异构的推理领域,兼顾算法深度与语言形式的多样性:
-
数学任务(Math):包含精心挑选的 40 个算子,严格覆盖“列表到列表、列表到标量、标量到标量、标量到列表”四种类型签名。涵盖线性代数、多项式运算、离散变换、组合数学、几何与数论。所有任务均由 Python 或 SymPy 编写底层求解器,并被精准包装为自然语言指令。
-
Python 追踪任务(Python Tracing):从 LeetCode 数据集中筛选出的 80 个经典算法,涵盖动态规划、栈与贪心、排序搜索及数组处理等。模型不需要自己写代码,而是需要扮演解释器,在给定的具体输入上追踪函数的单步执行。这高度检验了模型对结构化逻辑与局部状态演进的理解。
-
GSM 风格应用题(GSM-Symbolic):基于 GSM-Symbolic 模板改写出的 41 个标量到标量应用题,引入了实体描述与自然语言算术表达,充当工作流中的扰动项与现实算术节点。
在智能体评测中,另一个普遍存在的痛点是“机械性失误干扰了真实能力的测定”。很多时候,模型并非不知道答案,而是因为上下文太长导致输出格式漏掉了 LaTeX 框、将变量名拼错,或者触碰了单轮生成的 Token 上限而惨遭截断。如果直接判定为错误,基准测试测出的实际上是模型的“格式依从性”而非“上下文管理”。
为此,ArbiGraph 引入了一套极其严谨的定向修复协议(Targeted Repair Protocol)。评测环境为模型配备了一个基础的计算器工具以辅助算术运算,并设置了多轮交互修复机制:如果模型没有发起合法的计算器调用,环境会提示其发起工具调用;如果最终响应中遗漏了要求的变量标记盒(如 \boxed{task_N_out = value}),环境会精准追问缺失的变量;如果模型因单轮 Token 达到上限而被截断,环境则会发出续写指令。
这些修复提示完全遵循格式规范,绝对不向模型透露任何解题逻辑或中间正确数值,其唯一作用是排除格式干扰,确保提取出模型内心真正的计算轨迹。对于提取出的结果,整数与列表要求绝对匹配,浮点数则保留 $10^{-3}$ 的绝对容差,并借助符号系统进行最终真值核验。
实验反差:单任务高分掩盖下的系统性脆断
研究团队使用该框架对参数量为 270 亿的开源代表模型 Qwen3.5-27B 进行了全面评测,环境配置支持长达 512K 的上下文窗口,并采用确定性的贪婪解码(Temperature=0)。测试共执行了数千次完整的推理流程,累计消耗了约 105 个 GPU 推理小时。
实验所呈现出的数据对比极具冲击力。
在代表单点能力的 Baseline 拓扑下,Qwen3.5-27B 展现了极强的统治力:数学任务正确率达到 94.5%,代码追踪达到 96.8%,GSM 应用题更是达到了完美的 100.0%。如果仅看传统基准的单题测试,人们很容易得出该模型已经彻底攻破此类推理任务的结论。
然而,当进入遗忘拓扑(Forgetting)后,即使最终的目标任务完全没有变化、且输入数据依然独立,仅仅因为前面塞入了 3 个不相干的任务,数学任务的准确率就下滑到了 89.2%,代码追踪下滑至 92.5%。这证明仅仅是长文本中的无关静态干扰,就已经开始腐蚀模型的注意力聚焦能力。
更为剧烈的崩溃发生在真正具备数据依赖的链路中。在 4 步串联的链式拓扑(Chain)中,数学任务准确率暴跌至 75.5%;而在引入了列表拆解、多路独立计算再重组的多链拓扑(Multichain)中,数学任务准确率更是断崖式跌落至 61.2%,相比基线暴跌了整整 33.3 个百分点。
值得注意的是,不同任务类别在复杂拓扑下的抵抗力呈现出了高度的分化:
-
数学任务最为脆弱:由于数学算子对状态精度的要求极高,任何一步适配转换、数值缩放或变量名混淆,都会引发雪崩式的误差放大;
-
Python 代码追踪表现相对坚挺:在 Chain 和 Multichain 中,代码追踪的准确率依然分别维持在 90.1% 和 90.5%。这表明模型对代码抽象语法树式的局部执行追踪具备更好的鲁棒性,或者说代码的局部语义闭环一定程度上抵御了外部上下文的流动干扰;
-
自然语言应用题保持强健:GSM 类任务在四步链式下依然取得了 96.0% 的准确率,说明浅层的自然语言算术状态在长文本传递中相对不易迷失。
除了最终任务的胜负,过程指标(Process Metrics)进一步揭示了深层瓶颈。数据显示,随着拓扑由简入繁,模型的生成 Token 数量与交互轮数发生了急剧上升。在多链数学任务中,模型往往需要生成极长且繁琐的推导草稿来在脑海中“维持”前序变量的活跃状态,这种由于缺乏原生工作记忆机制而引发的自我解释,反过来进一步稀释了有限的注意力资源,最终导致自我崩溃。
对 Agent 架构演进的深层启示
ArbiGraph 的实验结论为当前热火朝天的智能体工程敲响了警钟。
在很多实际项目中,开发者倾向于将多步骤规划与执行全部托付给大模型的“端到端隐式推理”,寄希望于足够长的上下文窗口能够包揽一切。但 ArbiGraph 用确凿的数据证明:窗口变大不等于上下文管理能力的同步提升。在单 Prompt 内直接堆砌复杂的依赖流,哪怕是目前最优秀的开源模型之一,也会在分支与重组结构中遭遇高达三分之一的性能衰减。
这项研究从反面界定了大模型在复杂系统中的合理生态位。既然模型在“跨分支保持和传递带类型状态”这件事上存在原生的注意力衰减与累积误差,那么在构建生产级 Agent 框架时,便不应该把状态传递的重担完全压在模型的注意力机制上:
-
系统的外部控制流必须是确定性的:诸如分支分发、中间变量的缓存、类型检查、上下文修剪与重组,应当由确定性的代码框架(如 LangGraph 等状态机架构)来严格托管;
-
喂给模型的局部 Prompt,应当尽可能维持在 ArbiGraph 的 Baseline 或单步节点形态,让模型专注于执行局部推理,而不是强迫模型在长上下文里充当一台容易出错的“虚拟内存调度器”。
ArbiGraph 开辟了一个全新的诊断视角。通过将抽象的上下文管理解耦为可量化、可自动验证的数据流拓扑,它不仅能充当检验未来基础模型“原生工作记忆”的严苛试金石,也为智能体系统设计者划清了“纯模型推理”与“外部状态工程”的现实边界。