Robust-WAM:对齐未来语义预见,具身世界动作模型真机OOD达80%
Robust-WAM: Bridging Generative Pretraining and Semantic Foresight in World-Action Models
在具身智能与机器人操作领域,将大规模预训练视频生成模型(Video Generation Models, VGMs)转化为世界动作模型(World-Action Models, WAMs),已成为近年来的主流演进方向。视频生成模型在数以亿计的互联网视频中预先掌握了物理世界的演化规律——物体如何形变、滑移、接触和运动。将这种强大的动力学先验引入机器人动作规划,理论上能大幅降低策略在物理交互中的试错成本。
ArXiv URL:https://arxiv.org/abs/2608.05903v2
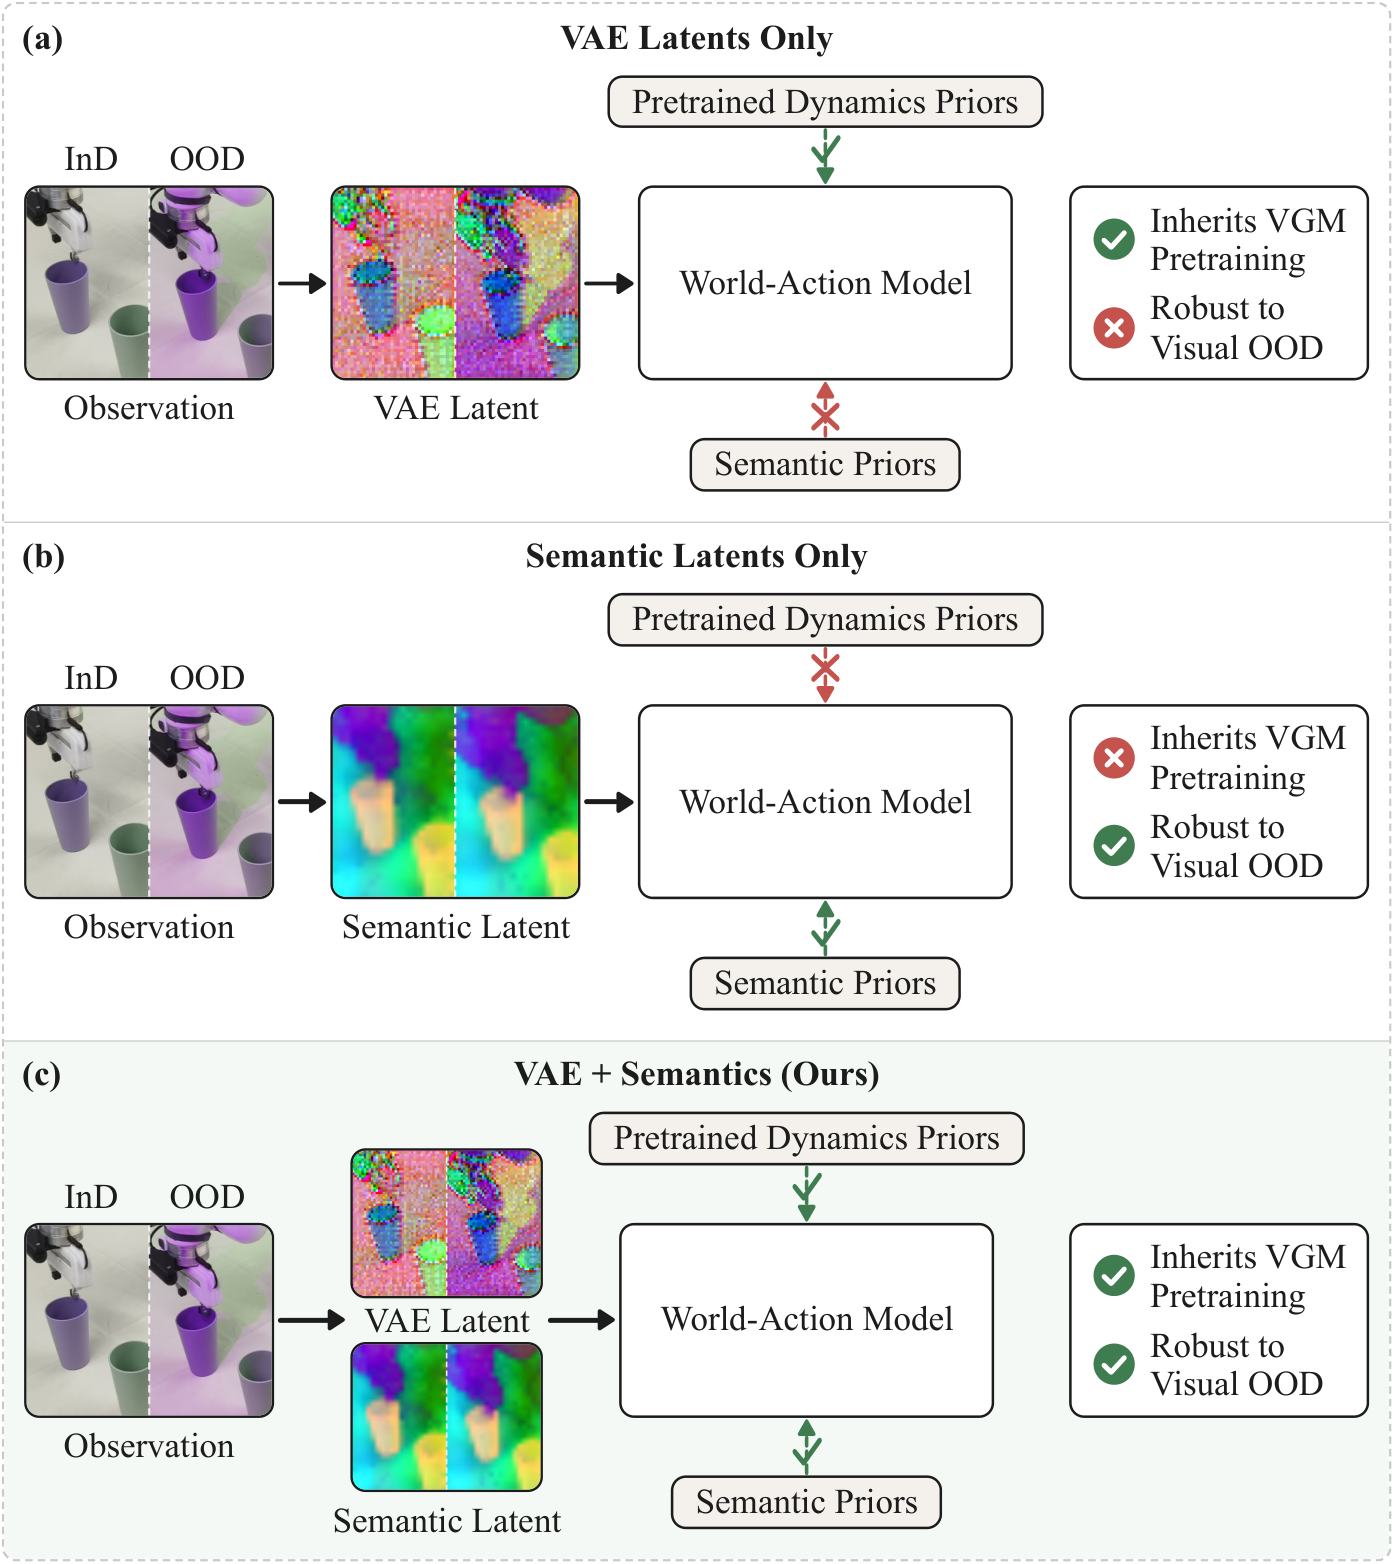
然而,现存的主流世界动作模型普遍受制于一个结构性弱点:主流视频生成底座几乎全部构建于变分自编码器(VAE)的潜空间之内。VAE 训练的核心准则是像素级重建,这迫使潜空间保留极其精细的表观细节,例如材质纹理、环境光泽与高频阴影。这就导致从 VAE 继承而来的动力学先验与视觉表观深度纠缠。当把策略部署到真实物理场景或面临未见过的光照、背景变动等分布外(OOD)扰动时,动作流极其容易被表观变化干扰,导致原本稳健的操作执行频频失效。
为了规避 VAE 的表观偏差,学界此前开辟了另一条路线:放弃视频生成模型,直接在 DINO 或 V-JEPA 等自监督语义潜空间中构建世界动作模型。语义特征天然滤除了细粒度的光影细节,对视觉扰动具有出色的不变性,但这套方案的代价同样沉重——它彻底抛弃了现成的、耗费海量算力预训练的视频生成大模型,若想重新获取对复杂动力学的理解,必须重构并在海量数据上从头预训练语义预测器。
针对这种两难境地,来自北京航空航天大学、华为与香港科技大学的研究团队提出了 Robust-WAM。这是一种面向基于视频生成的通用后训练(Post-training)方法,其核心思想并非推倒重建潜空间,而是在保留原有 VAE 生成路径以继承动力学先验的同时,在动作流上建立轻量级的未来语义预见对齐(Semantic Foresight Alignment)。通过向动作扩散架构中注入具备时间对应关系的可学习语义查询,策略能够在不丢失底层物理动力学的前提下,获得对视觉扰动免疫的未来语义预见。
动力学先验与表观鲁棒性的两难选择
要理解 Robust-WAM 的创新价值,首先需要厘清当前具身世界模型的技术断层。
目前主流的 WAM 架构多采用基于流匹配(Flow Matching)的扩散 Transformer(DiT)框架。给定当前多视角观测图像 $o_t$ 与语言任务指令 $\ell$,模型需要联合对未来视频帧的 VAE 隐变量 $\mathbf{x} = \mathcal{E}(o_{t+\Delta}, \dots, o_{t+T_f\Delta})$ 与未来 $H$ 步的动作块 $\mathbf{a} = a_{t:t+H-1}$ 进行去噪预测。在此过程中,动作预测通过交叉注意力等方式直接消耗视频流的生成隐表征 $\mathbf{H}^v$。这一耦合机制使得动作生成能够借力预训练视频模型的物理推理能力。
然而,VAE 编码器 $\mathcal{E}$ 的优化目标是最小化原始像素与重构像素之间的差异。在优化损失函数的牵引下,模型分配了大量参数与隐表征容量去捕捉诸如台面反光、灯光色温、纹理瑕疵等高频像素级信息。这就带来了一个致命后果:机器人在做决策时,其所依赖的未来状态表征对非本质的表观变化异常敏感。当现实部署环境中出现百叶窗阴影变化、灯泡色温偏移或工作台垫轻微更换时,VAE 隐变量随之剧烈漂移,进而诱发动作流预测的连锁崩溃。
另一种极端选择是转向纯语义潜空间世界模型(如 LDA-1B 及其衍生模型)。这类模型将未来的预测目标设定在自监督表征空间,自监督视觉编码器提取出的特征抽象度极高,天生对色彩与纹理不敏感。然而,目前开源社区最具竞争力的世界生成底座(如 Wan2.1、Cosmos 等)无一例外均锚定在像素级 VAE 潜空间。放弃 VAE 意味着放弃现成的大规模预训练成果,机器人策略不得不退回到较小规模数据与有限先验的困局中。
Robust-WAM 的破局点在于:不要试图强行将视频生成流改造成语义流,而是将语义不变性的纠偏工作精准收敛在动作流内部。这样既能继续“搭乘”大模型在 VAE 潜空间习得的动力学先验,又能切断表观噪声对动作预测的负面传导。
语义预见对齐:机制与时间锚定
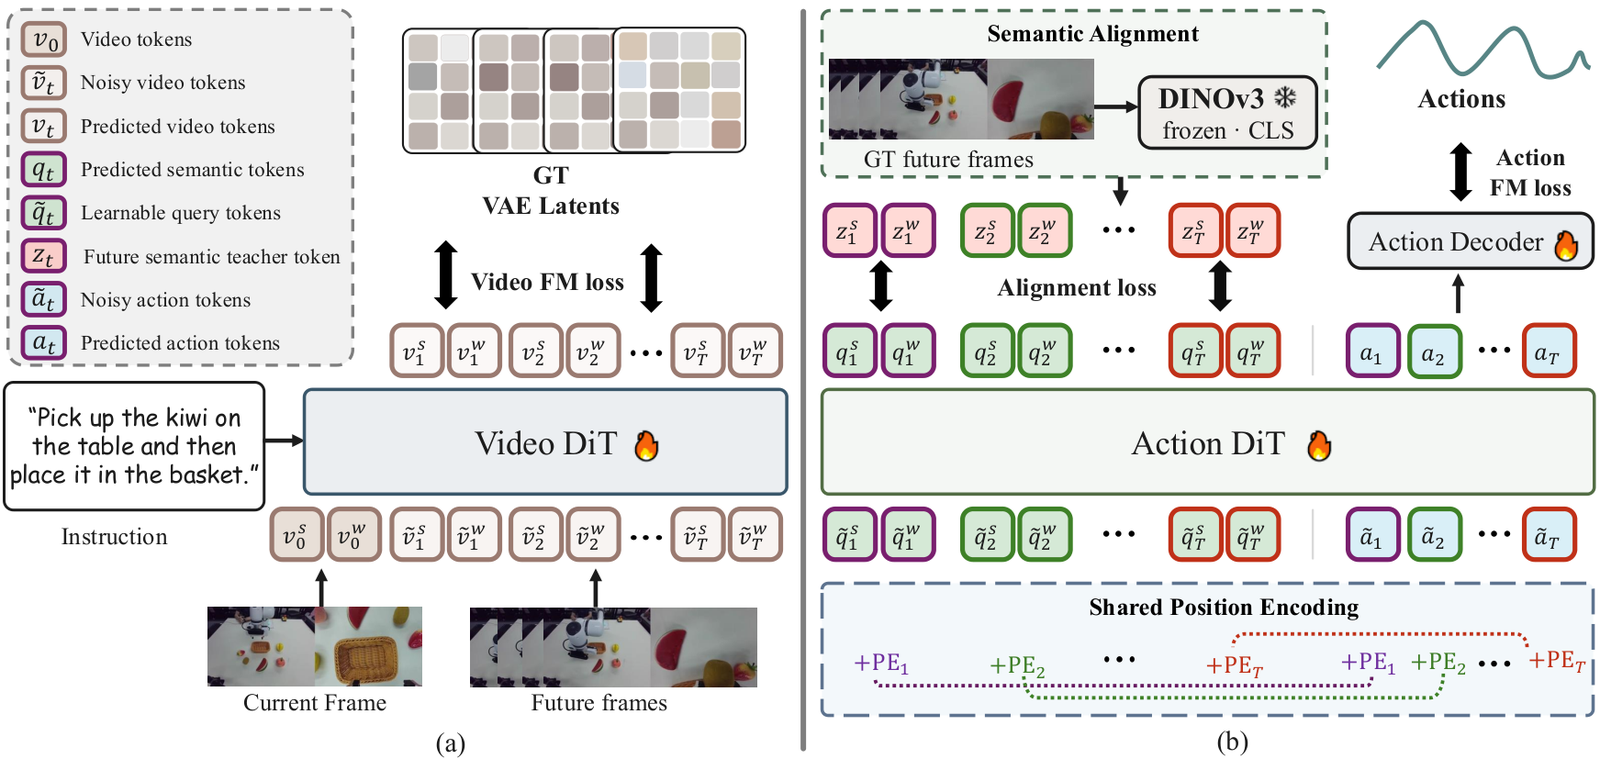
Robust-WAM 的整体架构设计非常精炼,它作为一个后训练机制无缝嵌入到现有的 WAM 中,主要包含三个核心环节:语义查询注入、时间位置编码共享,以及未来语义表征对齐。
1. 每帧可学习语义查询
在原有架构中,动作块 $\mathbf{a}$ 被离散化为 $L$ 个动作 Token $\mathbf{h}^a \in \mathbb{R}^{L \times d}$,直接送入动作 DiT 进行去噪。Robust-WAM 额外引入了一组 $K$ 个可学习的查询 Token $\mathbf{q} \in \mathbb{R}^{K \times d}$。
查询的数量取决于未来预测的时间范围与摄像机视角:设模型预测未来 $T_f$ 个视频时间步,每个时间步覆盖 $C$ 个相机视角,则查询总数为 $K = T_f \times C$。这组可学习查询直接拼接在加噪动作 Token 之前,形成组合序列:
\[\mathbf{h} = [\mathbf{q}; \mathbf{h}^a] \in \mathbb{R}^{(K+L)\times d}\]2. 共享时间位置编码(Shared Temporal PE)
给动作流加入查询并不罕见,但以往方法往往将查询视为静态全局特征,无法精确指示“当前查询究竟在看未来哪一时刻”。Robust-WAM 提出了一种极其自然的时间对齐方案:直接复用动作流本身的时间位置编码映射 $\Phi(\cdot, p)$。
具体而言,第 $j$ 个未来视频帧对应的实际控制步数为 $j\Delta$。由于动作块的总长度为 $L$,对应的动作控制步骤索引定义为:
\[\tau_j = \min(j\Delta, L) \in \{1, \dots, L\}\]在将查询输入动作 DiT 之前,为代表第 $j$ 帧、第 $c$ 个视角的查询赋予其所对应未来动作步的位置编码:
\[\hat{\mathbf{h}}_n = \begin{cases} \Phi\big(\mathbf{q}_n, \tau_{\lceil n/C \rceil}\big), & \text{if } n \le K, \\[4pt] \Phi\big(\mathbf{h}^a_{n-K}, n-K\big), & \text{if } n > K. \end{cases}\]通过复用完全相同的时间编码表,模型在底层自注意力机制中天然建立了语义查询与对应执行时刻之间的跨模态时间桥梁,使网络明确获知每个查询到底承担了预测多远未来(Foresight Horizon)的任务。
3. 冻结 DINOv3 CLS 作为语义对齐锚点
进入动作 DiT 处理后,查询 Token 与动作 Token 会经由自注意力机制与来自视频塔的交叉注意力进行充分的信息交互。查询从视频流读取动力学演化,而动作 Token 则持续汲取查询所包含的未来语义信息。
为了强迫查询 Token 剥离视觉表观干扰,研究团队选择将动作 DiT 输出的查询隐状态 $\bar{\mathbf{h}}_{1:K}$ 映射并对齐到真实未来视频帧的语义空间。对齐目标选用了冻结的 DINOv3 ViT-B/16 模型的 CLS Token:
-
CLSToken 作为一个全局聚合向量,对场景内关键物体的类别、空间几何布局与交互状态具备极强的概括力; -
自监督预训练使得该表征对低层视觉噪声(如色彩变动、光照方向、反光强度)具有天然的不变性。
需要特别强调的是,对齐的目标是真实未来帧,而非当前帧。这构成了“预见(Foresight)”的本质——查询不是在复述眼前的图像,而是在动作规划尚未完全落定之时,被迫去预测这些动作将把环境带向怎样的语义新状态。
在训练阶段,通过一个轻量线性投影头 $g: \mathbb{R}^d \to \mathbb{R}^{d_z}$ 将查询输出映射到 DINOv3 特征维度,并计算每查询余弦对齐损失:
\[\mathcal{L}_{\text{align}} = \frac{1}{K} \sum_{k=1}^K \left(1 - \cos\big(g(\bar{\mathbf{h}}_k), \mathbf{z}^*_k\big)\right)\]最终联合损失函数为原 WAM 损失与对齐损失的加权和:
\[\mathcal{L} = \mathcal{L}_{\text{WAM}} + \lambda_{\text{align}} \mathcal{L}_{\text{align}}\]而在部署推理阶段,DINOv3 教师模型与投影头 $g$ 均被直接移除,只有初始化为静态参数的 $K$ 个查询 Token 留在序列中参与计算。因此,该设计在推理阶段完全没有引入外部大模型的额外计算开销与延迟。
架构兼容性:专家架构与统一架构通吃
当前主流的世界动作模型在结构组织上呈现出两大派系:以专家混合(MoT)为代表的“双塔独立动作专家”架构,以及将视频与动作统一在单一大模型内部的“统一全能”架构。Robust-WAM 对这两种形态均给出了适配方案。
对于像 GE-Act、FastWAM 与 Motus 这类拥有独立动作专家(Action Expert)的模型,由于其动作流本身就是一个专门处理控制序列的 DiT,可学习查询直接拼接到专家输入的 Token 序列头部即可。它们与动作 Token 一同共享专家的自注意力,并以完全相同的方式 cross-attend 到视频生成塔。
而对于像 LingBot-VA 这种将视频潜在表征与动作 Token 混排在一起处理的统一架构(Unified WAMs),Robust-WAM 则将语义查询无缝嵌入到动作片段内部,并赋予它们与对应动作步相同的序列 ID、帧 ID 与噪声调度 ID。在灵活注意力(Flex-Attention)掩码的约束下,查询 Token 既能够与同一未来时间步的动作 Token 进行双向信息交互,又严格遵循时间步之间的自回归生成顺序,避免未来信息非因果性泄露。这种灵活性证明了 Robust-WAM 是一个高度泛化的后训练范式。
仿真基准评估:对抗极端分布外偏移
为了严格检验 Robust-WAM 的抗干扰能力,论文在两个以视觉扰动苛刻著称的模拟基准上进行了全方位评测:RoboTwin clean$\to$random 与 LIBERO-Plus。
在 RoboTwin clean$\to$random 评测中,策略在初始姿态固定、背景完全纯净的基准演示中完成训练,测试时则被抛入未经见过的物体位姿、非结构化背景纹理与随机光照环境中。而在 LIBERO-Plus 基准中,策略需要面对横跨相机视点、光照、背景纹理、物体初始布局、机器人起始状态、语言表述变体以及传感器噪声等 7 大维度的系统性扰动。
评估不仅对比了 FastWAM、GE-Act 与 LingBot-VA 等原生 VAE 视频世界动作模型,还横向对比了纯 VLA 模型(包括 OpenVLA、$\pi_0$、$\pi_0$-FAST、GR00T-N1.7 等)以及纯语义世界模型 LDA-1B。
实验结果揭示了几个极为关键的趋势:
-
分布内(InD)性能不仅未降,反而微幅上升:在无扰动的原生 LIBERO 测试集上,搭载 Robust-WAM 的策略表现完全不逊色于原模型,甚至在部分任务套件中取得了数个百分点的微增。这证明引入语义辅助监督并未损害原模型通过流匹配学到的高精度控制分布。
-
分布外(OOD)鲁棒性全面提升:在 LIBERO-Plus 面对视觉扰动(特别是光照变动与背景纹理改变)时,原生 VAE-WAM 基线的性能往往发生断崖式下跌。而引入 Robust-WAM 后,策略在各种扰动维度下的成功率均获得了系统性改善,成功率提升幅度普遍在十几个百分点,大幅超越了未建模动力学的传统 VLA 策略。
-
消融实验证实机制必要性:作者针对语义目标的选择与时间位置编码进行了精细消融。若将对齐目标换回当前观测帧(而非未来帧),策略的 OOD 性能显著下滑,说明“预见(Foresight)”所提供的行动指导价值远高于对“当下状态”的重述;若去除共享时间位置编码,模型缺乏时间锚定,性能同样出现衰退;而在对齐特征上,DINOv3 CLS 表现大幅优于空间 Patch 特征均值或纯几何深度特征。
真实机器人实验:极端未见光照下的硬核考验
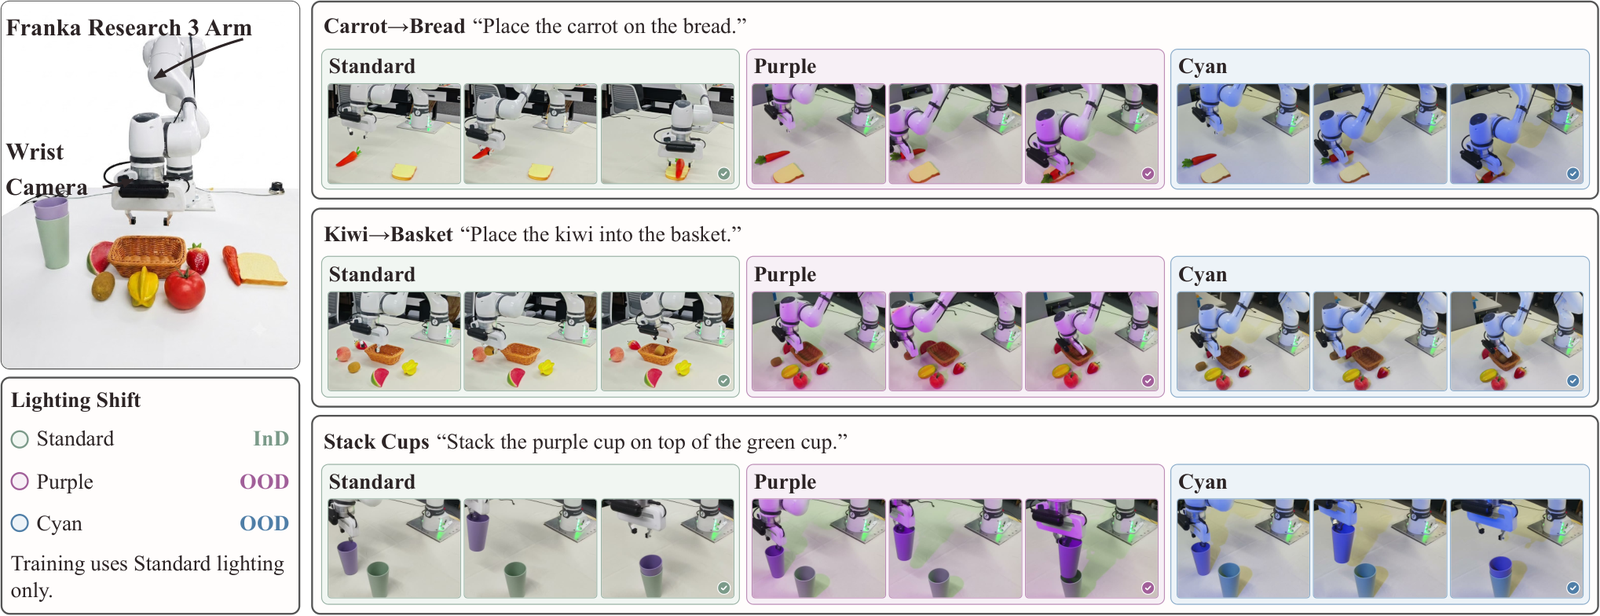
模拟器的渲染再逼真,也很难完全复现物理世界的非线性光学效应。为了验证 Robust-WAM 能否真正解决现实机器人的部署难题,研究团队在 Franka Research 3 机械臂平台上搭建了真实的物理实验。
真实实验包含三项经典桌面操作任务:胡萝卜放面包上(Carrot$\to$Bread)、猕猴桃放入收纳筐(Kiwi$\to$Basket)以及杯子叠放(Stack Cups)。
为了制造极具挑战性的视觉分布外漂移,实验设置了一个十分严苛的测试条件:
-
训练数据:所有的示范轨迹均采集于标准白光照明环境下。
-
评测条件:机械臂基座、台面几何、目标物体和双视角相机(一个第三人称视角,一个手眼视角)保持物理固定,仅改变工作区域的环境光照。测试环境引入了在任何训练数据中从未出现过的强紫色光照与强青色光照。
这对于以像素重构为先验的 VAE 视频模型来说几乎是“毁灭性”的。在紫光和青光下,物体的 RGB 像素分布整体平移,局部对比度发生剧烈反转。
下表总结了真实机械臂在标准光照与两种未见光照下的评测表现(基于最强基线 GE-Act 及其搭载 Robust-WAM 后的对比):
| 策略架构 | 分布内成功率 (InD: 白光) | 分布外成功率 (OOD: 紫光/青光) | 分布内外性能落差 ($\Delta_{\text{gap}}\downarrow$) |
|---|---|---|---|
| FastWAM 基线 | 64.0% | 26.7% | 37.3% |
| GE-Act 强基线 | 80.0% | 57.3% | 22.7% |
| Robust-WAM (基于 GE-Act) | 82.7% | 80.0% | 2.7% |
这一组真实测试数据极具说服力:
-
未经语义对齐的原生基线表现出了极强的表观依赖性。即便是表现较优的 GE-Act,在换上紫色和青色灯光后,平均成功率也从 $80.0\%$ 锐跌到 $57.3\%$,性能落差高达 $22.7$ 个百分点;而相对轻量的 FastWAM 更是从 $64.0\%$ 骤跌至 $26.7\%$。机械臂在末端接近物体阶段,由于反光与颜色扭曲,频繁发生定位偏离或抓空现象。
-
引入 Robust-WAM 后,机械臂在极端颜色光照下的平均 OOD 成功率维持在 $80.0\%$,各子任务的 OOD 成功率提升幅度在 20 到 28 个百分点不等。更重要的是,分布内与分布外之间的性能落差从原先的 $22.7$ 个百分点断崖式收窄至 $2.7$ 个百分点。
这充分证明,尽管视频生成塔底层的 VAE 潜变量在极端光照下不可避免地发生了偏移,但动作流依靠具备时间位置编码的查询 Token,锚定在了具有强不变性的未来 DINOv3 语义空间上。策略做决策时所依赖的“意图与未来状态认知”没有被表面的光影杂质带偏,展现出了极高的鲁棒性。
总结与技术启示
世界动作模型的发展一度陷入了一种“两头为难”的思维定势:要么全盘接受基于 VAE 的生成式预训练,被迫忍受视觉漂移带来的策略脆弱;要么推倒重来搞纯语义表征,失去视频大模型数千小时通用动力学训练积累的红利。
Robust-WAM 的最大启示在于,它用极具工程智慧的解耦思想消解了这种二元对立:
-
潜空间不需要“一刀切”:视频生成模型需要像素级细粒度表征来学习物体的碰撞、重叠与连续运动;但机器人高层动作控制真正需要的,是剔除无关细节后的语义意图。二者不必强行统一在同一个隐空间内,通过在动作去噪阶段引入可学习查询,即可在保留动力学传输的同时过滤表观噪声。
-
时间对齐是多模态融合的胜负手:仅仅给模型添加语义特征是不够的,将未来预见查询与特定动作控制步的时间编码深度绑定,使得隐空间具备了清晰的时空结构感,这是模型在极低计算开销下实现鲁棒泛化的关键所在。
作为一种无需改动推理计算流水线、即插即用的通用后训练方案,Robust-WAM 为后续结合 Sora、Wan2.1 或 Cosmos 等更大规模商业级视频生成大模型的具身智能落地,提供了一条高可行性且低成本的鲁棒演进范式。