AdvDex:用对抗学习统一动作空间,10万条人手示教零样本驱动灵巧手
AdvDex: Learning Dexterous Manipulation from Human Demonstrations via Joint-Aligned Actions and Adversarial Learning
在具身智能(Embodied AI)迈向通用操作的过程中,多指灵巧手被普遍视为终极形态。然而,相比于技术相对成熟的双指平行夹爪,灵巧手的规模化落地始终面临着难以逾越的鸿沟:真实的机器人遥操作示教成本极其高昂,采集门槛令人望而生畏;不同硬件平台的机械结构天差地别,从几千元的简易手到几十万元的拟人灵巧手,关节自由度与运动学约束各不相同;即便是直接采集低成本的人手操作视频,由于人类手部与机械手的物理外观迥异,现有的端到端视觉策略极易陷入过拟合——神经网络学到的往往不是物体的几何互动逻辑,而是特定机械手臂的外观纹理,从而彻底丧失跨本体泛化能力。
ArXiv URL:https://arxiv.org/abs/2608.14028v1
针对这一系列痛点,来自复旦大学、帕西尼感知科技(Paxini Tech)、上海创新研究院、上海交通大学以及浙江大学的研究团队提出了一个统一的视觉-语言-动作(Vision-Language-Action, VLA)框架——AdvDex。
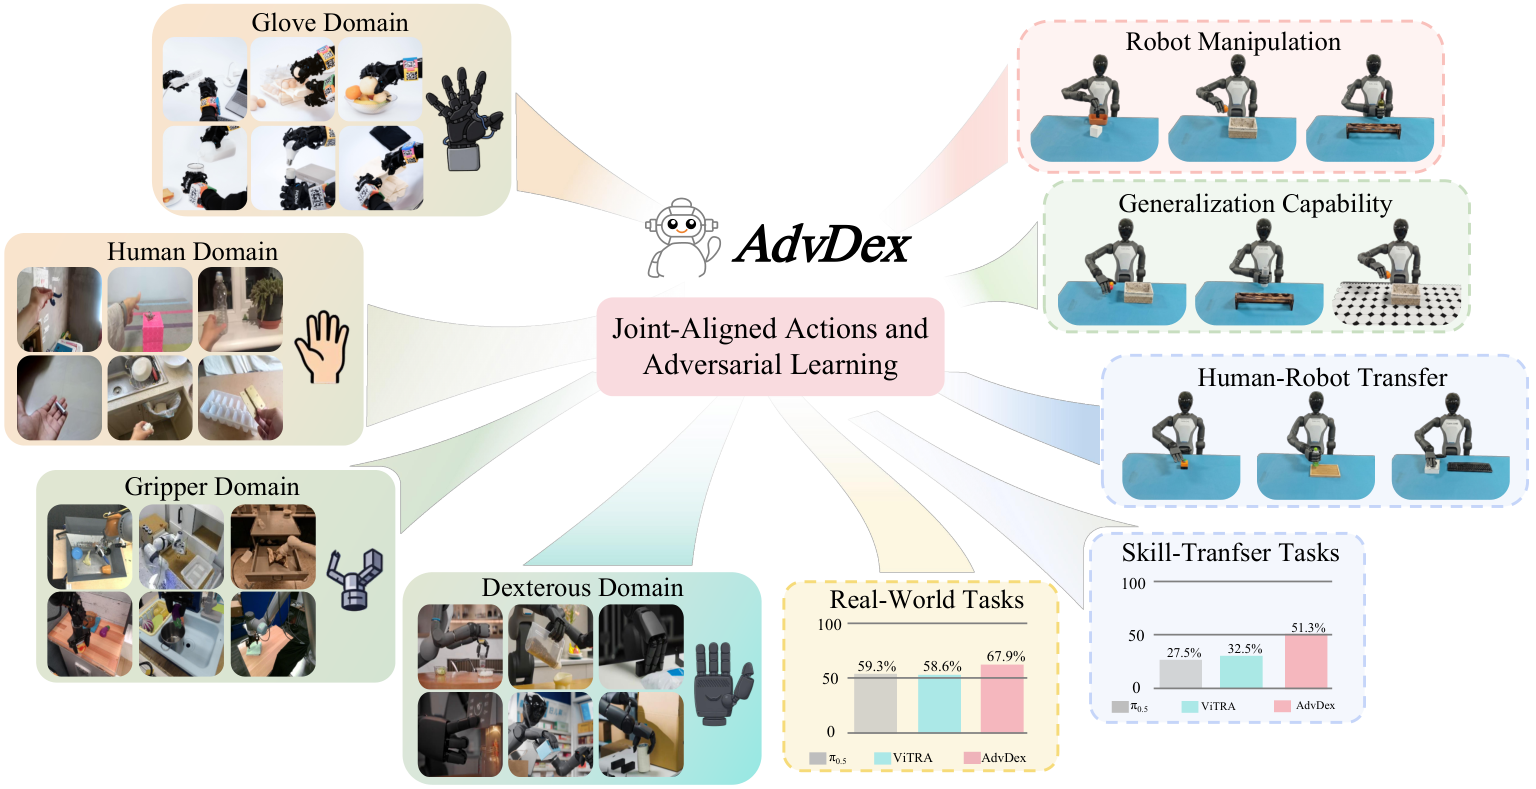
该框架的核心突破在于打破了“硬件必须一一适配模型”的旧范式:通过构建包含超10万条人类轨迹的高精度多模态数据集 OmniShare,设计标准化的关节对齐动作空间(JAAS),并引入基于梯度反转层的领域对抗表征学习,AdvDex 首次在极度异构的多指硬件与人手之间搭起了一座无缝迁移的桥梁。实验表明,该策略不仅能在未见过的物体与复杂环境中稳定操作,更实现了完全无需目标真机示教的零样本(Zero-shot)人手到机械臂技能迁移。
破解异构困局:为什么跨本体灵巧操作如此艰难?
在传统的机械臂模仿学习中,主流的数据集与策略大多围绕平行双指夹爪(Parallel-jaw Grippers)展开。然而,复杂的工具使用、动态抓取与细粒度装配任务必须依赖类似人类五指的丰富自由度。机械手与人手虽然在驱动逻辑上具有天然的相似性,但要将海量人类操作数据直接供给机器人学习,在学术界和工业界长期存在两大约束。
首先是运动学维度的碎片化。目前主流的灵巧手硬件包括 Wuji、Xhand、Shadow Hand 以及 Paxini DexH13 等,它们的自由度涵盖十几个到几十个不等,甚至还包含欠驱动或连杆联动机制;而描述人手姿态的经典 MANO 模型拥有 51 个自由度。这种巨大的物理结构差异,导致针对某一款机械手录制的数据根本无法直接输入到另一款机械手上训练,数据孤岛现象异常严重。
其次是视觉特征与本体外观的深度纠缠。在端到端 VLA 模型的训练中,通用的视觉编码器(如 ViT)会同时接收场景环境、目标物体以及执行器本体的像素输入。模型在优化模仿学习目标时,往往会投机取巧地将机械手或人手的外观特征作为预测动作的快捷线索(Shortcut)。一旦测试场景中的机械手外观、光影、颜色与训练集稍有偏差,或者将人手输入切换为机械手,控制策略便会迅速崩溃。
纯粹依靠在仿真环境中重定向(Retargeting)或对不同硬件分别微调,不仅无法从根本上消除视觉表征的本体偏差,还会大幅消耗昂贵的工程调试成本。AdvDex 提出的破局思路,正是在底层动作表示与高层视觉编码两个层面同时实施“本体去偶”。
动作空间的标准化:JAAS 的几何与运动学对齐
为了抹平各类异构末端执行器之间的物理鸿沟,AdvDex 首先确立了一种统一的动作规范——关节对齐动作空间(Joint-Aligned Action Space, JAAS)。
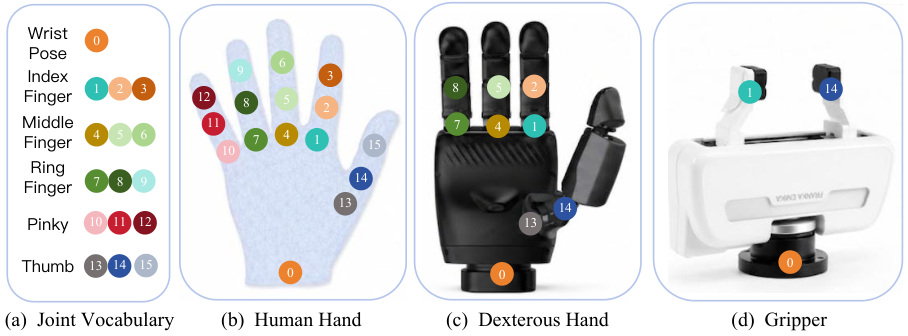
JAAS 将执行器的控制信号解耦为一个标准规范的动作接口,其主体由两部分构成:一个全局的 $\mathrm{SE}(3)$ 手腕位姿(包含3D空间位移和连续的3D空间旋转),以及 15 个手指关节。具体而言,系统为五根手指各分配了 3 个具有 3 个自由度的欧拉关节。
这个设计的巧妙之处在于,它建立了一种通用且向下兼容的“功能性对应语义”:
-
对于 51-DoF 的高自由度人手模型(如 MANO 骨骼),算法通过运动学映射将其关节自由度约束压缩并重定向至这 15 个核心控制节点;
-
对于常见的 19-DoF 拟人灵巧手(如 Paxini DexH13),其硬件关节可以直接映射至对应的欧拉关节角集合;
-
即便是退化到传统的 7-DoF 机械臂加单自由度二指平行夹爪,JAAS 也能够通过将多余手指关节参数置空或设定为固定约束,将其视作 JAAS 空间下的一个特例。
通过这种规范化表达,无论是高维度的人手捕获轨迹、精细复杂的灵巧手遥操作数据,还是大规模公开的传统二指夹爪数据集(如 Open X-Embodiment),都可以无差别地注入到同一个策略网络中参与联合预训练。
软硬协同支撑:OmniShare 数据集与物理感知优化
没有高质量的数据基座,再好的动作空间设计也只是空中楼阁。由于传统的纯视觉手部姿态估计存在严重的遮挡和深层关节不确定性,AdvDex 团队开发了名为 OmniShare 的大规模多模态人类操作数据集。
该数据集涵盖 5 个真实领域、500 多项复杂操作任务、超过 700 种各异的几何物体,累计时长突破 1 万小时,有效动作轨迹超过 10 万条。为了保证数据在动力学和接触层面的高精度,采集系统采用了微秒级同步的多模态传感套件:
操作者佩戴了集成 29 个高精度磁旋转编码器的数据手套,能够以低于 1 度的角误差实时捕获手部关节的细微颤动;同时,手套指尖与掌面集成了基于霍尔效应的触觉传感阵列,能够以高频捕获抓握与接触法向力。
在数据后处理阶段,研究人员利用 FoundationPose 与物理先验结合的方式估算 6D 腕部与物体姿态,并通过引入物理感知的联合优化目标,将原始传感器数据重定向至 MANO 模型与 JAAS 空间中。在此过程中,触觉信号通过特定的距离感知衰减函数与运动轨迹绑定,不仅记录了手在哪一刻以何种姿态接触了物体,还锁定了抓握力的动态演化过程,为后续模型学习精细的接触交互提供了极其坚实的数据监督。
领域对抗 VLA:让视觉表征剥离“本体偏见”
即使在动作输出端统一了 JAAS 空间,视觉感知端的本体偏差问题依然存在。如果视觉编码器看到的依然是人类肉手或特定型号的机械手,网络很难自发学会通用的交互逻辑。为此,AdvDex 将视觉-语言-动作架构与领域对抗学习(Domain-Adversarial Learning)进行了深度融合。
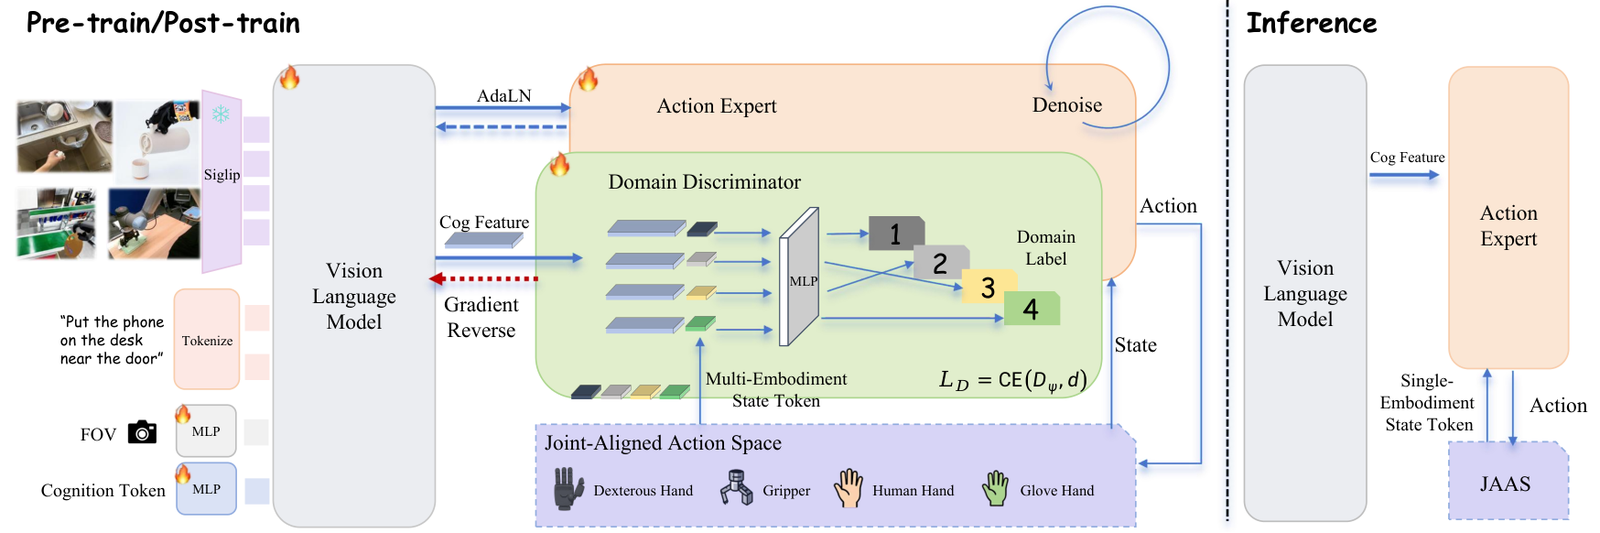
整体模型包含三个关键部分:视觉-语言模型(VLM)主干网络 $E_{\theta}$、扩散 Transformer(Diffusion Transformer, DiT)动作专家 $P_{\phi}$,以及一个专门的领域判别器 $D_{\psi}$。
给定单视角环境图像 $\mathbf{I}{t}$ 与人类语言指令,VLM 首先提取出紧凑的认知标记(Cognition Token)$\mathbf{z}{t} = E_{\theta}(\mathbf{I}{t})$。在常规流程中,该特征会结合当前的本体运动学状态 $s_t$,通过自适应层归一化(AdaLN)注入到 DiT 动作专家中,以去噪的方式逐步预测出未来一段连续的 JAAS 动作块 $(\mathbf{a}{t}^{i}, \dots, \mathbf{a}_{t+N}^{i})$。
AdvDex 的核心改动在于,在 VLM 输出认知标记 $\mathbf{z}{t}$ 的位置挂载了一个领域判别器 $D{\psi}$,并在两者之间插入了梯度反转层(Gradient Reversal Layer, GRL)。判别器的任务是根据输入的特征判断当前执行任务的是人手还是特定型号的机器人;而在反向传播时,梯度反转层会将判别器传回的梯度乘以负系数 $-\lambda$ 注入回 VLM 编码器。
这一对抗博弈过程的数学表达体现为联合优化目标:
动作预测的扩散去噪损失为:
\[\mathcal{L}_{\text{MSE}}(\theta,\phi)=\mathbb{E}_{\epsilon\sim\mathcal{N}(0,1),i}\left[\|\hat{\epsilon}_{i}-\epsilon\|_{2}^{2}\right]\]领域分类交叉熵损失为:
\[\mathcal{L}_{\text{D}}(\psi\mid\theta)=\mathbb{E}_{(\mathbf{I}_{t},s_{t},d)\sim\mathcal{B}}\left[-\sum_{k\in\mathcal{D}}\mathbb{I}(d=k)\log D_{\psi}^{(k)}([\mathbf{z}_{t},s_{t}])\right]\]最终模型的联合优化目标为:
\[\mathcal{L}_{\text{final}}=\mathcal{L}_{\text{MSE}}(\theta,\phi)+\lambda\cdot\mathcal{L}_{\text{D}}(\psi\mid\theta)\]值得注意的是,判别器在判断本体领域时,输入同时拼接了认知特征 $\mathbf{z}_t$ 和当前状态 $s_t$。这一设计的考量十分精细:网络中已经被关节运动学显式解释的物理差异不应该干扰视觉特征,对抗损失只需专注于消除那些潜藏在图像纹理中的外观信息。随着对抗训练的进行,VLM 提取出的认知表征逐渐对执行器的具体视觉外观“脱敏”,只保留与任务意图、物体几何位姿相关的跨本体不变特征。
在推理阶段,判别器与梯度反转层被直接剥离,完全不增加任何额外的计算延迟或改变策略接口,真正做到了“训练期消除偏见,推理期轻量运行”。
实验印证:从零样本技能迁移到极速环境适应
为检验 AdvDex 的泛化能力与真实落地表现,研究团队在真实物理平台开展了严格评估。测试平台采用 Paxini Tora 双臂移动机器人,双臂末端各搭载一台拥有 19 个自由度的高拟人 DexH13 触觉灵巧手。
1. 零样本跨本体技能迁移
为了彻底验证模型是否真正摆脱了对特定本体示教的依赖,研究人员设计了严苛的互斥任务评估:联合训练集中包含了 1000 条机械手遥操作轨迹和 1000 条 OmniShare 人类操作轨迹,但两者的任务集完全不重叠。测试时,机器人必须执行那些仅在人类演示中出现过、机械手从未学过的操作指令(如翻转特定工具、抓握特殊几何体等)。
在这种苛刻的零样本跨本体设定下,普通的预训练策略(如基准模型 $\pi_{0.5}$ 和 VITRA)基本瘫痪,成功率接近于零;而 AdvDex 凭借对齐的 JAAS 动作空间与领域不变的视觉特征,成功将人类演示中的操作逻辑映射到了 19-DoF 机械手上,展现出了惊人的泛化理解能力。
2. 少样本极速适应能力
在实际工程部署中,即使存在零样本能力,通常也允许工程师提供极少量的目标域数据进行微调,以适应不同地面的摩擦力或机械损耗。
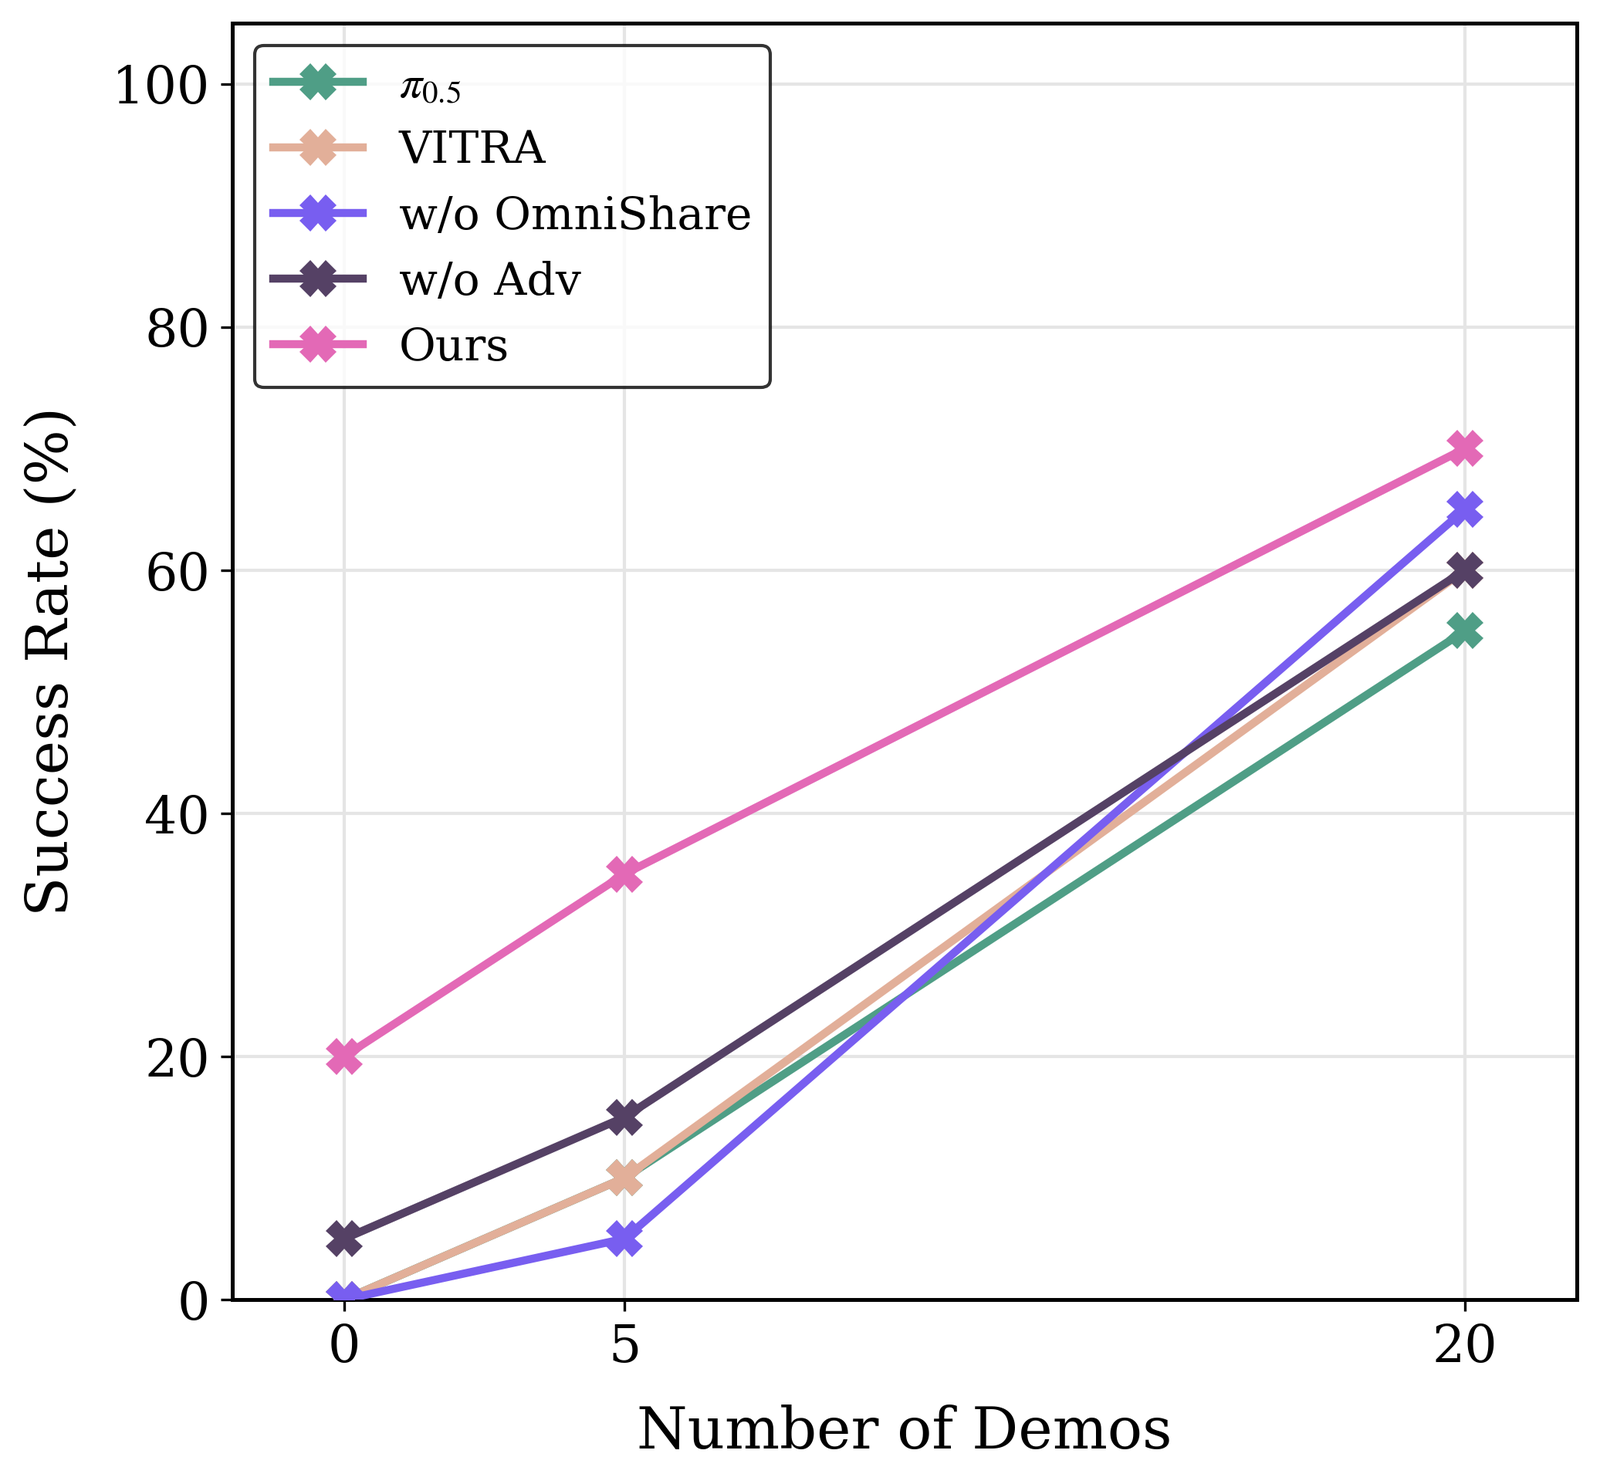
在针对单一物体抓握的微调实验中,AdvDex 表现出极高的数据效率。对比基线模型在零样本时彻底失败的情况,AdvDex 在未微调状态下便已具备非零的基础成功率;仅注入 5 条真实机械手示教轨迹后,其成功率便迎来爆发式跃升;在增加至 20 条轨迹时,操作表现已接近饱和。
消融实验进一步揭示了各个模块的不可或缺性:如果移除领域对抗模块(w/o Adv),策略的性能衰减幅度甚至超过了移除大规模数据集 OmniShare(w/o OmniShare)带来的影响。这充分证明,在跨本体学习中,消除视觉假象的优先级绝不亚于堆砌数据规模本身。
3. 特征分布的具象验证
对抗学习是否真的抹除了本体外观的鸿沟?研究团队利用 t-SNE 技术对策略网络的中间层认知表征进行了降维投影。
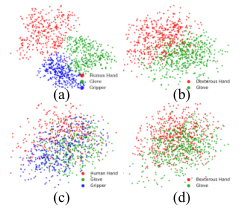
对比图呈现出了极具说服力的模式分离与融合:
在没有引入梯度反转层(GRL)的预训练与后训练阶段,来自人手和机器人的特征在潜在空间中呈现出界限分明的两组聚类,这表明网络深层依然在根据外观给输入打上强烈的本体标签;
而引入 GRL 之后,无论是在预训练期还是针对目标域的微调期,人手与机械手的表征点云都呈现出高度重叠和弥散的融合状态。这种定性的可视化结果直接印证了:对抗训练成功迫使模型将注意力转移到了物体几何状态与操作目标上,达成了真正意义上的视觉不变性。
迈向通用的灵巧手具身智能
AdvDex 的出现,实质上为当前具身智能领域的“数据饥渴症”提供了一条极具操作性的解题路径。过去,灵巧手操作研究之所以举步维艰,很大程度上是因为研究人员默认必须在特定机器人平台上日复一日地积累海量遥操作轨迹;而 AdvDex 证明,通过将运动学映射至通用的关节空间,并在潜空间中使用对抗策略过滤掉物理外观的噪点,海量低成本、自然丰富的人类活动数据完全能够成为机械手强大的知识源泉。
当然,该框架仍存在演进空间。人类在操作中的软组织形变、复杂的指尖微滑动动力学,很难单纯依靠当前的纯模仿学习完全复现;此外,统一的 JAAS 空间目前主要聚焦于运动学对齐,并未显式建模各款机械手在电机扭矩极限、惯量分布以及接触刚度上的动力学差异。未来的一个关键演进方向,是将 AdvDex 预训练获得的通用操作先验,与真机上的强化学习或在线自适应控制相结合,利用在线试错去填补微观动力学上的最后一道代沟。
即便如此,AdvDex 所展现出的跨本体理解、零样本技能迁移与少样本适应能力,已经清晰地昭示出通用机器人的未来形态:一个拥有统一动作语义、能够从海量人类现实行为中汲取智慧,并随意注入不同形态硬件的具身大模型,正在从理论设想一步步变为现实。